围绕软件开发中人工智能的讨论已经发生了巨大变化。多年来,人们对 AI 编码助手的基本期待很简单:自动补全接下来的几行代码、给出一个正则表达式,或在聊天窗口里解释一段遗留文档。这些工具虽然有用,却始终只是被动的辅助工具,需要人工不断介入。
如今,行业正在超越简单的自动补全,走向更具系统性的方向:智能体编码工作流。自主和半自主的编码智能体不再只是编写函数,而是被设计为能够推理多步骤的工程任务、编排测试套件、调试构建失败,并重构整个目录结构。推动这一演进的重要力量,是开放权重模型的快速成熟,它让开发团队在自动化工作流的运行方式上拥有前所未有的掌控力、透明度和定制能力。
从被动助手到自主智能体
传统的编码助手是被动响应式的。开发者遇到问题,构思提示词,评估输出,再手动把结果复制粘贴到 IDE 中。上下文管理、任务拆解和结果验证,始终只由人来统筹。
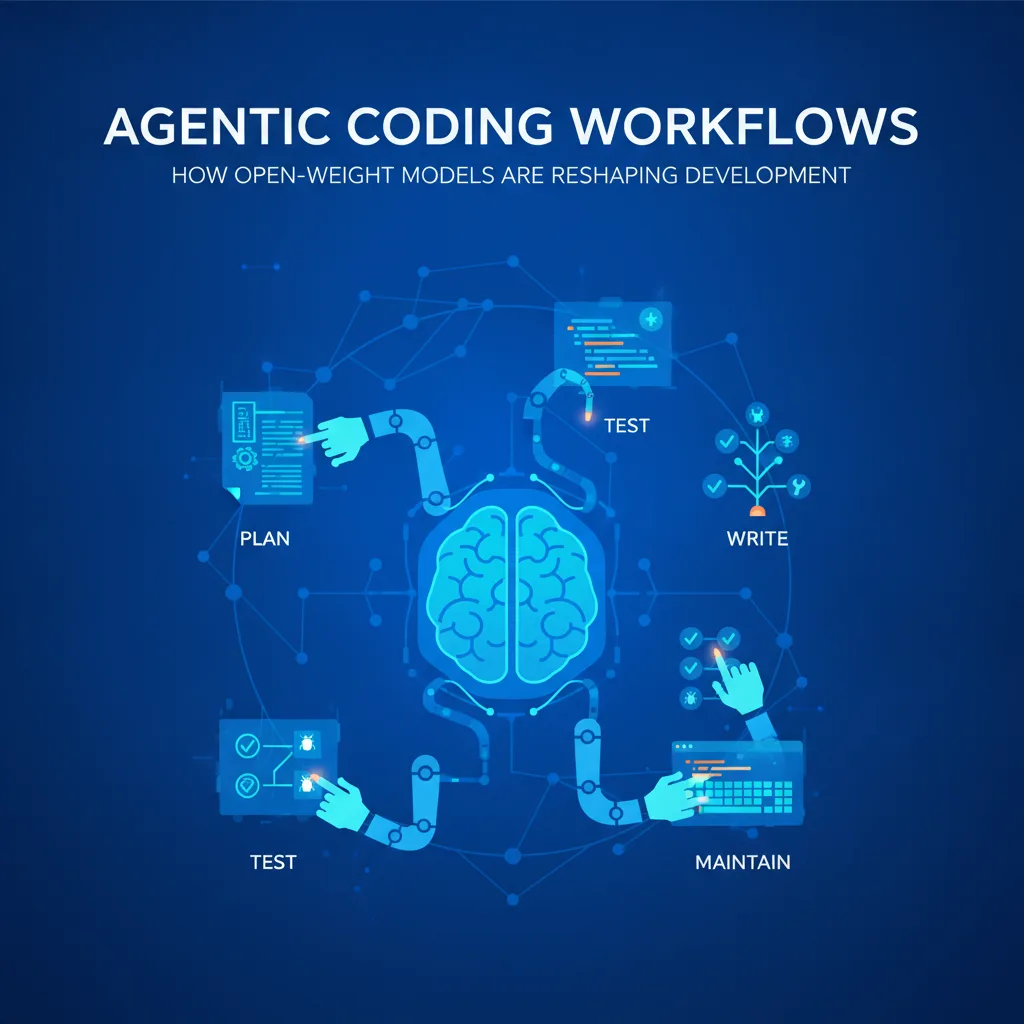
智能体工作流则扭转了这种关系。自主编码智能体会收到一个高层目标,例如“为 API 网关实现一个限流中间件,并确保所有单元测试通过”。此后,工作流通常会通过一个递归循环来执行:
- 规划:智能体分析代码仓库结构,找出相关文件,并列出分步骤的实现方案。
- 执行:它在多个文件中编写或修改代码,原生处理语法和导入。
- 验证:智能体调用本地测试运行器、代码检查工具或构建脚本,检查自己的工作成果。
- 迭代:如果出现错误,智能体会读取堆栈跟踪,诊断根本原因,并在无需人工干预的情况下修复。
这一转变让开发者从逐行编写代码的人,变成系统架构师和审查者,管理的是工作流,而不是一次次按键。
开放权重模型在智能体开发中的作用
随着编码智能体对推理能力的要求越来越高,底层模型架构的选择变得至关重要。长期以来,封闭的专有云 API 主导着讨论,但开放权重模型的最新进展,尤其是针对工具调用和推理优化的大规模架构,正在拉平这场竞争的起跑线。
对于构建内部自动化流水线的工程团队,开放权重模型具有独特的优势:
- 数据隐私与安全:企业代码库往往包含专有逻辑和敏感的安全配置。在本地或私有虚拟私有云(VPC)中运行高性能的开放权重模型,可以确保专有代码不会离开组织边界。
- 微调灵活性:每个工程团队都有自己独特的编码规范、架构模式和内部库。开放权重模型可以基于内部代码仓库进行微调,从而比通用云端模型更好地理解公司特有的惯用写法。
- 成本可预测:高频运行的自主智能体每完成一个任务就要进行成千上万次推理调用。完全依赖按 token 计费的云端定价,可能让大规模自动化的成本高到难以承受,而自托管的开放权重模型只需承担固定的基础设施成本。
稳健的智能体编码工作流的关键组成
要成功部署编码智能体,仅仅把一个强大的模型指向 Git 仓库是不够的。可用于生产环境的智能体工作流,依赖于精心设计的技术栈。
以下是构建可靠编码自动化所需的核心支柱:
- 上下文检索与索引:大型代码库会超出标准的上下文窗口。智能体需要语义搜索引擎和抽象语法树(AST)解析器,只把相关的文件片段加载到内存中。
- 沙盒化执行环境:由于智能体会执行代码、运行测试并安装软件包,它们必须在安全、隔离的容器中运行,以防止意外的系统改动或安全漏洞。
- 确定性护栏:自主工作流需要明确的边界,例如把文件写入权限限制在指定目录,或在合并拉取请求之前要求人工批准。
- 结构化日志与可观测性:要调试一个在十步重构中途悄无声息地失败的智能体,是出了名的困难。完整的审计轨迹对于追踪智能体的推理步骤至关重要。
克服代码自动化的障碍
尽管潜力巨大,智能体编码工作流并不是万能药。采用这些工具的开发者常常会遇到一些可预见的阻力。
一个主要挑战是“上下文漂移”。当智能体在长时间的会话中修改多个文件时,它对代码库的内部认知可能与实际情况脱节,进而引发连锁的逻辑错误。缓解的办法是频繁刷新上下文,并严格地模块化任务。
另一个障碍是过度依赖合成验证。智能体编写的代码也许能通过现有测试,却可能遗漏边界情况,或引入只有经验丰富的人工审查者才能发现的隐性架构债务。成功的做法是把智能体当作需要监督的初级工程师,而不是可以放手的资深工程师。
软件工程工作流的未来
将开放权重模型整合进智能体编码工作流,标志着软件构建方式发生了永久性的改变。随着这些系统变得更快、更可靠,也更擅长长程规划,开发者将不必再把大量时间耗费在样板代码和配置文件上,而是能把更多精力用于设计具有韧性、可扩展的系统。
通过在 AI 智能体的自主性与严格的安全、沙盒隔离和人工监督之间取得平衡,工程团队可以在不损害代码库完整性的前提下,释放出新一级的生产力。
相关指南
如需了解这些智能体背后的模型,请参阅维基百科上关于大语言模型的文章。