La conversación sobre la inteligencia artificial en el desarrollo de software ha cambiado de forma drástica. Durante años, lo que se esperaba de un asistente de programación con IA era sencillo: autocompletar las siguientes líneas, sugerir un patrón regex o explicar un fragmento de documentación heredada en una ventana de chat. Aunque útiles, estas herramientas seguían siendo utilidades pasivas que exigían una intervención humana constante.
Hoy, el sector avanza más allá del simple autocompletado hacia algo mucho más sistémico: los flujos de trabajo de programación agéntica. En lugar de limitarse a escribir funciones, los agentes de programación autónomos y semiautónomos están diseñados para razonar tareas de ingeniería de varios pasos, orquestar suites de pruebas, depurar fallos de compilación y refactorizar estructuras de directorios completas. Una parte importante de esta evolución se debe a la rápida maduración de los modelos de pesos abiertos, que dan a los equipos de desarrollo un control, una transparencia y una capacidad de personalización sin precedentes sobre cómo funcionan sus flujos de trabajo automatizados.
De asistentes pasivos a agentes autónomos
Los asistentes de programación tradicionales funcionan de forma reactiva. Un desarrollador se encuentra con un problema, redacta un prompt, evalúa el resultado y lo copia y pega manualmente en un IDE. El humano sigue siendo el único orquestador del contexto, la división de tareas y la validación.
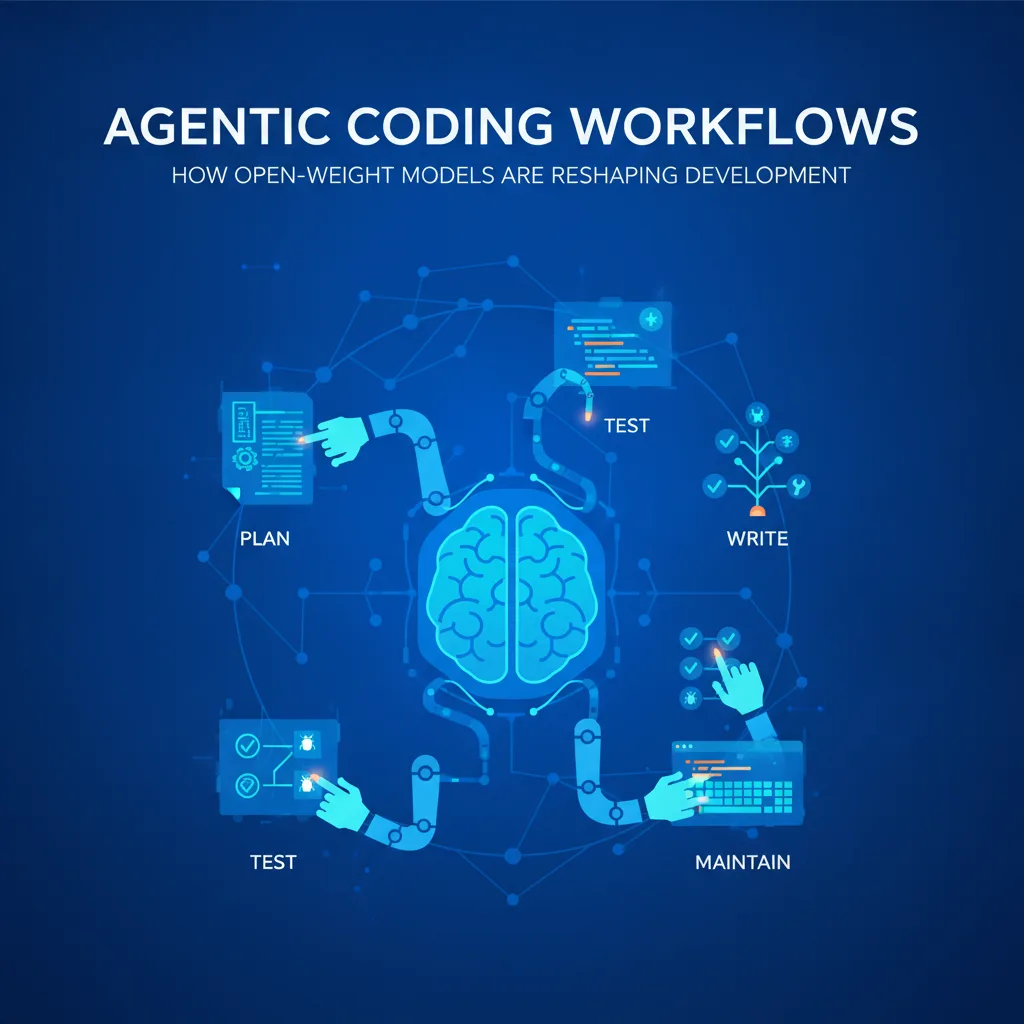
Los flujos de trabajo agénticos invierten esta dinámica. Un agente de programación autónomo recibe un objetivo de alto nivel, como "implementa un middleware de rate limiter para el API gateway y asegúrate de que pasen todas las pruebas unitarias". A partir de ahí, el flujo suele ejecutarse mediante un bucle recursivo:
- Planificación: el agente analiza la estructura del repositorio, identifica los archivos relevantes y esboza una estrategia de implementación paso a paso.
- Ejecución: escribe o modifica código en varios archivos y gestiona de forma nativa la sintaxis y las importaciones.
- Verificación: el agente invoca ejecutores de pruebas locales, linters o scripts de compilación para comprobar su propio trabajo.
- Iteración: si se produce un error, el agente lee el stack trace, diagnostica la causa raíz y aplica una corrección sin intervención humana.
Este cambio transforma a los desarrolladores de programadores línea a línea en arquitectos de sistemas y revisores, que gestionan flujos de trabajo en lugar de pulsaciones de teclas.
El papel de los modelos de pesos abiertos en el desarrollo agéntico
A medida que los agentes de programación exigen capacidades de razonamiento más profundas, la elección de la arquitectura del modelo subyacente se ha vuelto crítica. Aunque las API en la nube cerradas y propietarias han dominado durante mucho tiempo la conversación, los avances recientes en modelos de pesos abiertos, en particular las arquitecturas de mayor escala optimizadas para el uso de herramientas y el razonamiento, están igualando las condiciones.
Los modelos de pesos abiertos ofrecen ventajas únicas a los equipos de ingeniería que construyen pipelines de automatización internos:
- Privacidad y seguridad de los datos: los códigos base empresariales suelen contener lógica propietaria y configuraciones de seguridad sensibles. Ejecutar modelos de pesos abiertos competentes en local o dentro de una nube privada virtual (VPC) garantiza que el código propietario nunca salga del perímetro de la organización.
- Flexibilidad de ajuste fino: cada equipo de ingeniería tiene sus propios estándares de programación, patrones de arquitectura y bibliotecas internas. Los modelos de pesos abiertos pueden ajustarse con los repositorios internos para entender los modismos propios de la empresa mucho mejor que los modelos genéricos en la nube.
- Previsibilidad de costes: los agentes autónomos de alta frecuencia realizan miles de llamadas de razonamiento por tarea. Depender por completo de precios por token en la nube puede hacer que la automatización intensiva resulte prohibitiva, mientras que los modelos de pesos abiertos autoalojados ofrecen costes de infraestructura fijos.
Componentes clave de unos flujos de programación agéntica sólidos
Desplegar agentes de programación con éxito requiere algo más que apuntar un modelo capaz a un repositorio Git. Un flujo de trabajo agéntico listo para producción se apoya en un stack técnico cuidadosamente estructurado.
Estos son los pilares básicos necesarios para construir una automatización de código fiable:
- Recuperación de contexto e indexación: los códigos base grandes superan las ventanas de contexto habituales. Los agentes necesitan motores de búsqueda semántica y analizadores de árboles de sintaxis abstracta (AST) para cargar en memoria solo los fragmentos de archivo relevantes.
- Entornos de ejecución aislados (sandbox): como los agentes ejecutan código, lanzan pruebas e instalan paquetes, deben operar dentro de contenedores seguros y aislados para evitar modificaciones no deseadas del sistema o brechas de seguridad.
- Barreras de seguridad deterministas: los flujos autónomos necesitan límites estrictos, como restringir el acceso de escritura a directorios designados o exigir aprobación humana antes de fusionar pull requests.
- Registro estructurado y observabilidad: depurar un agente que falló en silencio a mitad de una refactorización de diez pasos es notoriamente difícil. Las pistas de auditoría completas son esenciales para seguir los pasos de razonamiento de un agente.
Cómo superar los obstáculos de la automatización del código
A pesar de su inmenso potencial, los flujos de programación agéntica no son una bala de plata. Los desarrolladores que adoptan estas herramientas suelen toparse con puntos de fricción previsibles.
Un desafío importante es la "deriva de contexto". Cuando un agente modifica varios archivos durante una sesión larga, su representación interna del código base puede alejarse de la realidad y provocar errores lógicos en cascada. Mitigarlo requiere actualizaciones frecuentes del contexto y una modularización estricta de las tareas.
Otro obstáculo es la dependencia excesiva de la validación sintética. Un agente puede escribir código que supere las pruebas existentes y, aun así, pasar por alto casos límite o introducir una sutil deuda de arquitectura que solo un revisor humano con experiencia detectaría. Una adopción exitosa trata a los agentes como ingenieros junior que requieren supervisión, no como seniors autónomos.
El futuro de los flujos de trabajo de ingeniería de software
La integración de los modelos de pesos abiertos en los flujos de programación agéntica marca un cambio permanente en la forma de construir software. A medida que estos sistemas sean más rápidos, más fiables y mejores en la planificación a largo plazo, los desarrolladores dedicarán menos tiempo a pelearse con código repetitivo y archivos de configuración, y más a diseñar sistemas resilientes y escalables.
Al equilibrar la autonomía de los agentes de IA con una seguridad rigurosa, el uso de sandbox y la supervisión humana, los equipos de ingeniería pueden alcanzar un nuevo nivel de productividad sin comprometer la integridad de sus códigos base.
Guías relacionadas
- Agentes de IA autónomos: de los chatbots a los orquestadores de flujos de trabajo
- Por qué los agentes de IA necesitan documentación estructurada y no memoria infinita
- Servicios de IA agéntica y automatización
Para conocer el contexto de los modelos que hay detrás de estos agentes, consulta el artículo de Wikipedia sobre los modelos de lenguaje de gran tamaño.