Durante los últimos años, la carrera en inteligencia artificial se ha definido en gran medida por una sola métrica: la longitud del contexto. Cada pocos meses, los grandes laboratorios lanzan modelos capaces de digerir cientos de miles, o incluso millones, de tokens a la vez. La promesa implícita para los desarrolladores y los arquitectos de automatización ha sido simple: dale a la IA todo y lo recordará todo. Si un agente autónomo tiene acceso al historial completo de un proyecto, seguro que tomará mejores decisiones.
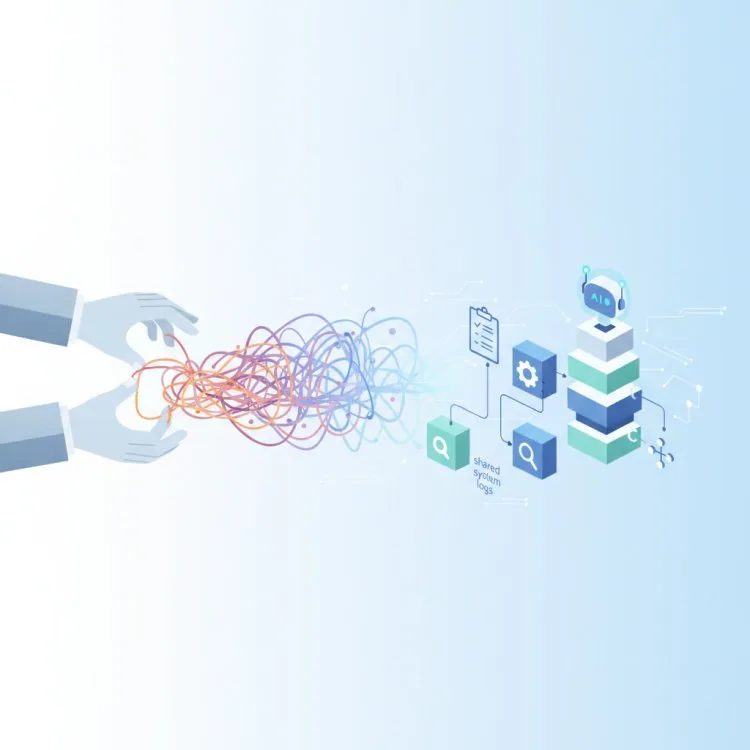
Sin embargo, cualquiera que haya desplegado agentes de IA de varios pasos en producción sabe que la realidad es mucho más desordenada. Llenar el contexto del prompt de un agente con historiales de chat interminables, instantáneas extensas de bases de código y registros de API sin procesar no produce un trabajador más inteligente. En cambio, introduce la «degradación del contexto»: un estado en el que el modelo pierde el enfoque, alucina detalles enterrados en el ruido y consume presupuestos de cómputo solo por intentar analizar su propio pasado.
Estamos llegando a un punto de inflexión en la automatización de flujos de trabajo. La industria está descubriendo una verdad contraintuitiva: los agentes autónomos no necesitan una memoria masiva y desestructurada. Necesitan una documentación limpia y dinámica.
La falacia del contexto infinito en la automatización de flujos de trabajo
Para entender por qué las arquitecturas con mucha memoria chocan con un muro, piensa en cómo funcionan las organizaciones humanas. Si un equipo de ingeniería de software o un departamento de marketing incorporara a un nuevo contratista entregándole un volcado bruto y desorganizado de cada mensaje de Slack, hilo de correo y registro de commits de los últimos cinco años, ese contratista probablemente fracasaría. No sabría qué es relevante ahora, qué ha quedado obsoleto ni quién tiene la última palabra en las decisiones.
Sin embargo, así es precisamente como se han diseñado muchos pipelines de IA automatizados. Los desarrolladores ponen en marcha un agente, le conectan una enorme base de datos vectorial o una amplia ventana de contexto y esperan que el modelo filtre el ruido histórico para averiguar el estado actual de una tarea.
Este enfoque falla por tres razones principales:
- Alta latencia y coste: procesar miles de tokens redundantes en cada ciclo de ejecución eleva los costes de API e introduce una latencia notable en los flujos de trabajo automatizados.
- Dilución de la atención: los transformers se basan en mecanismos de atención. Cuando la relación señal-ruido cae por culpa de un contexto histórico irrelevante, se degrada la capacidad del modelo para razonar sobre la tarea inmediata.
- Suposiciones obsoletas: los historiales de chat sin procesar suelen contener ideas abandonadas, intentos fallidos de depuración e instrucciones desactualizadas. Un agente que lea un registro de historial sin procesar podría resucitar por accidente un enfoque erróneo que el equipo descartó semanas atrás.
Pasar de la memoria a la documentación dinámica
La solución que surge en los frameworks de automatización avanzados es un giro hacia una arquitectura que prioriza la documentación. En lugar de tratar la memoria de un agente como un contenedor pasivo de todo lo que ha visto, los desarrolladores diseñan sistemas en los que los agentes mantienen, leen y actualizan activamente archivos markdown estructurados, registros de decisiones de arquitectura (ADR) y manifiestos de estado en vivo.
En este modelo, el entorno del agente funciona como un wiki bien mantenido. Cuando un agente ejecuta un paso de un flujo de trabajo, ya sea refactorizar un microservicio, clasificar tickets de soporte al cliente o generar un informe financiero, no registra sus pensamientos en un historial de chat sin fondo. En su lugar, actualiza una sección específica de un árbol de documentación centralizado.
Este cambio transforma la forma en que los agentes interactúan con el mundo:
- Lecturas deterministas: en lugar de depender de una búsqueda semántica difusa a través de millones de tokens de registros de chat, el agente lee un documento de estado conciso y legible por humanos que describe explícitamente los objetivos actuales, las restricciones y los hitos completados.
- Transparencia con intervención humana: la documentación estructurada es transparente. Los responsables de TI y los desarrolladores pueden abrir un archivo, ver exactamente qué cree el agente que es el estado actual de un proyecto y editarlo directamente si el agente se ha desviado.
- Portabilidad modular: cuando la documentación vive en archivos modulares y limpios en lugar de en una base de datos vectorial propietaria, los agentes pueden intercambiarse, actualizarse o ejecutarse en sandboxes descentralizados con facilidad sin perder su estado operativo.
Buenas prácticas para implementar agentes impulsados por documentación
Si estás creando o escalando flujos de trabajo automatizados con agentes de IA, abandonar la memoria de fuerza bruta requiere un cambio deliberado en el diseño del sistema. Esta es una hoja de ruta práctica para implementar un pipeline de automatización que prioriza la documentación:
- Define esquemas de estado claros: establece plantillas estrictas de lo que un agente debe documentar tras completar una tarea. Usa markdown con encabezados claros, como Objetivo actual, Bloqueos activos y Próximas acciones.
- Aplica ciclos de escritura de retorno: programa los flujos de trabajo de tus agentes para que cada ciclo de ejecución importante concluya con una operación de escritura que actualice los archivos de documentación, de modo que la siguiente ejecución comience con un contexto fresco y resumido.
- Poda de forma continua: trata la documentación del agente como repositorios de código. Implementa linting automatizado o prompts de revisión secundarios que eliminen la información obsoleta, evitando la hinchazón de la documentación.
- Separa los registros del estado: guarda los registros de ejecución sin procesar (respuestas de API, salidas de terminal) en un almacén de telemetría aparte. Deja que el agente consulte estos registros solo cuando se necesite una depuración específica, en lugar de mantenerlos permanentemente en la ruta activa del prompt.
- Mantén los archivos locales y bajo control de versiones: almacena los archivos de estado del agente en directorios locales o repositorios git. Esto te permite seguir cómo evoluciona con el tiempo la comprensión que el agente tiene de un proyecto y revertir los cambios si el modelo corrompe sus propias instrucciones.
El camino por delante para los flujos de trabajo autónomos
A medida que los agentes de IA pasan de ser novedades experimentales a componentes centrales de la infraestructura empresarial, el factor diferenciador no será cuántos tokens puede retener un modelo en su memoria a corto plazo, sino con qué claridad pueden diseñar los ingenieros la arquitectura de información que rodea al agente.
Al tratar la documentación como la interfaz principal entre la intención humana y la ejecución de la máquina, podemos construir sistemas automatizados más ligeros, más fiables y mucho más fáciles de auditar. En el mundo de los agentes de IA, la claridad siempre triunfará sobre el desorden.
¿Cómo gestiona tu equipo el estado y el contexto de los agentes en sus pipelines de automatización actuales? Adoptar pronto una documentación estructurada podría ser el avance que tus flujos de trabajo necesitan para escalar con éxito.
More about ai agents
Want to go further with ai agents? These Netstech guides and services are a good next step: