В последние годы гонка в области искусственного интеллекта во многом определялась одним показателем — длиной контекста. Каждые несколько месяцев крупные лаборатории выпускают модели, способные переварить сотни тысяч, а то и миллионы токенов сразу. Неявное обещание разработчикам и архитекторам автоматизации было простым: дайте ИИ всё, и он всё запомнит. Если у автономного агента есть полная история проекта, он наверняка будет принимать лучшие решения.
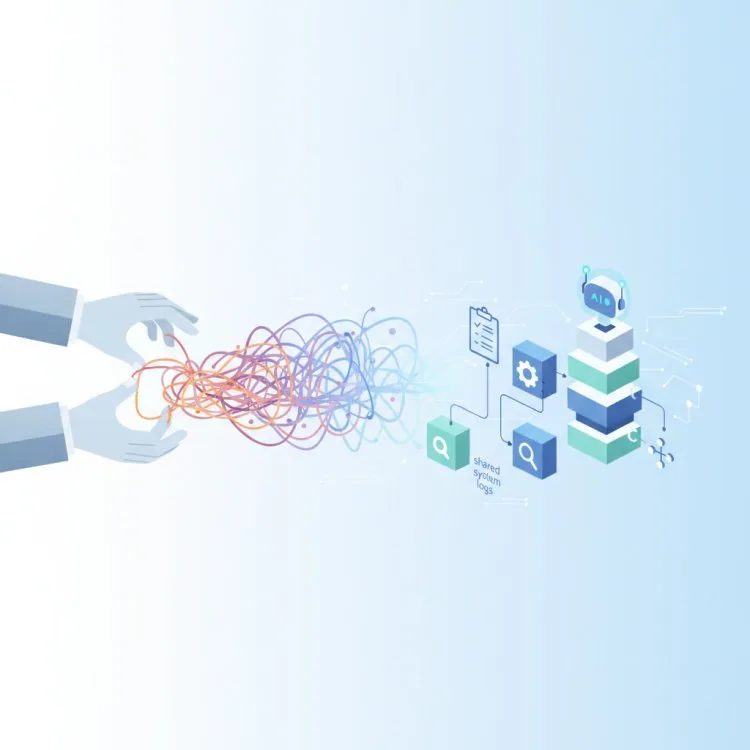
Тем не менее любой, кто развёртывал многошаговых ИИ-агентов в производстве, знает, что реальность куда запутаннее. Забивание контекста промпта агента бесконечной историей чатов, разрастающимися снимками кодовой базы и сырыми журналами API не делает работника умнее. Вместо этого возникает «гниение контекста» — состояние, при котором модель теряет фокус, придумывает детали, похороненные в шуме, и тратит вычислительные бюджеты только на то, чтобы разобрать собственное прошлое.
Мы достигаем переломного момента в автоматизации рабочих процессов. Отрасль осознаёт парадоксальную истину: автономным агентам не нужна огромная неструктурированная память. Им нужна чистая динамическая документация.
Заблуждение о бесконечном контексте в автоматизации рабочих процессов
Чтобы понять, почему архитектуры с тяжёлой памятью упираются в стену, посмотрите, как работают человеческие организации. Если бы команда разработки ПО или отдел маркетинга вводили нового подрядчика, вручив ему необработанную неорганизованную свалку каждого сообщения Slack, цепочки писем и журнала коммитов за последние пять лет, подрядчик, скорее всего, не справился бы. Он не знал бы, что актуально сейчас, что устарело и у кого последнее слово в принятии решений.
Тем не менее именно так задумано работать многим автоматизированным ИИ-конвейерам. Разработчики запускают агента, подключают огромную векторную базу данных или обширное контекстное окно и ждут, что модель просеет исторический шум и выяснит текущее состояние задачи.
Этот подход не работает по трём основным причинам:
- Высокая задержка и стоимость: обработка тысяч избыточных токенов в каждом цикле выполнения увеличивает расходы на API и вносит заметную задержку в автоматизированные процессы.
- Размывание внимания: трансформеры опираются на механизмы внимания. Когда соотношение сигнала и шума падает из-за нерелевантного исторического контекста, способность модели рассуждать о текущей задаче ухудшается.
- Устаревшие допущения: сырые истории чатов часто содержат заброшенные идеи, неудачные попытки отладки и устаревшие инструкции. Агент, читающий сырой журнал истории, может случайно возродить плохой подход, который команда отвергла несколько недель назад.
Переход от памяти к динамической документации
Решение, возникающее в передовых фреймворках автоматизации, — сдвиг к архитектуре с приоритетом документации. Вместо того чтобы считать память агента пассивным хранилищем всего, что он когда-либо видел, разработчики проектируют системы, где агенты активно ведут, читают и обновляют структурированные markdown-файлы, записи об архитектурных решениях (ADR) и живые манифесты состояния.
В этой модели среда агента работает как хорошо поддерживаемая вики. Когда агент выполняет шаг рабочего процесса — рефакторинг микросервиса, сортировку обращений в поддержку или создание финансового отчёта, — он не записывает свои мысли в бездонную историю чата. Вместо этого он обновляет определённый раздел централизованного дерева документации.
Это изменение трансформирует взаимодействие агентов с миром:
- Детерминированное чтение: вместо нечёткого семантического поиска по миллионам токенов журналов чата агент читает краткий, понятный человеку документ состояния, явно описывающий текущие цели, ограничения и достигнутые этапы.
- Прозрачность с участием человека: структурированная документация прозрачна. ИТ-менеджеры и разработчики могут открыть файл, увидеть, что именно агент считает текущим состоянием проекта, и напрямую отредактировать его, если агент сбился с пути.
- Модульная переносимость: когда документация хранится в чистых модульных файлах, а не в проприетарной векторной базе данных, агентов можно легко заменять, обновлять или запускать в децентрализованных песочницах без потери операционного состояния.
Лучшие практики внедрения агентов, управляемых документацией
Если вы создаёте или масштабируете автоматизированные рабочие процессы на основе ИИ-агентов, отказ от грубой силы памяти требует осознанного сдвига в проектировании системы. Вот практическая дорожная карта внедрения конвейера автоматизации, где документация на первом месте:
- Определите чёткие схемы состояния: задайте строгие шаблоны того, что агент должен документировать после выполнения задачи. Используйте markdown с чёткими заголовками, например Текущая цель, Активные блокеры и Следующие действия.
- Обеспечьте циклы обратной записи: запрограммируйте рабочие процессы агентов так, чтобы каждый крупный цикл выполнения завершался операцией записи, обновляющей файлы документации, чтобы следующий запуск начинался со свежего, сжатого контекста.
- Постоянно очищайте: относитесь к документации агента как к репозиториям кода. Внедрите автоматическую проверку или вторичные промпты для рецензирования, которые удаляют устаревшую информацию и предотвращают раздувание документации.
- Разделяйте журналы и состояние: храните сырые журналы выполнения (ответы API, вывод терминала) в отдельном хранилище телеметрии. Позволяйте агенту обращаться к этим журналам только при необходимости конкретной отладки, а не держите их постоянно в активном пути промпта.
- Храните файлы локально и под контролем версий: храните файлы состояния агента в локальных каталогах или git-репозиториях. Это позволяет отслеживать, как со временем меняется понимание проекта агентом, и откатывать изменения, если модель повредит собственные инструкции.
Путь вперёд для автономных рабочих процессов
По мере того как ИИ-агенты переходят от экспериментальных новинок к основным компонентам корпоративной инфраструктуры, отличием станет не то, сколько токенов модель удерживает в кратковременной памяти, а то, насколько чисто инженеры смогут спроектировать информационную архитектуру вокруг агента.
Рассматривая документацию как основной интерфейс между человеческим замыслом и машинным исполнением, мы можем создавать автоматизированные системы, которые легче, надёжнее и гораздо проще проверять. В мире ИИ-агентов ясность всегда побеждает беспорядок.
Как ваша команда управляет состоянием и контекстом агентов в текущих конвейерах автоматизации? Раннее внедрение структурированной документации вполне может стать тем прорывом, который нужен вашим процессам для успешного масштабирования.
More about ai agents
Want to go further with ai agents? These Netstech guides and services are a good next step: