Nos últimos anos, a corrida na inteligência artificial foi definida em grande parte por uma única métrica: o tamanho do contexto. A cada poucos meses, os grandes laboratórios lançam modelos capazes de absorver centenas de milhares, ou até milhões, de tokens de uma só vez. A promessa implícita para desenvolvedores e arquitetos de automação era simples: dê tudo à IA e ela se lembrará de tudo. Se um agente autônomo tem acesso ao histórico completo de um projeto, certamente tomará decisões melhores.
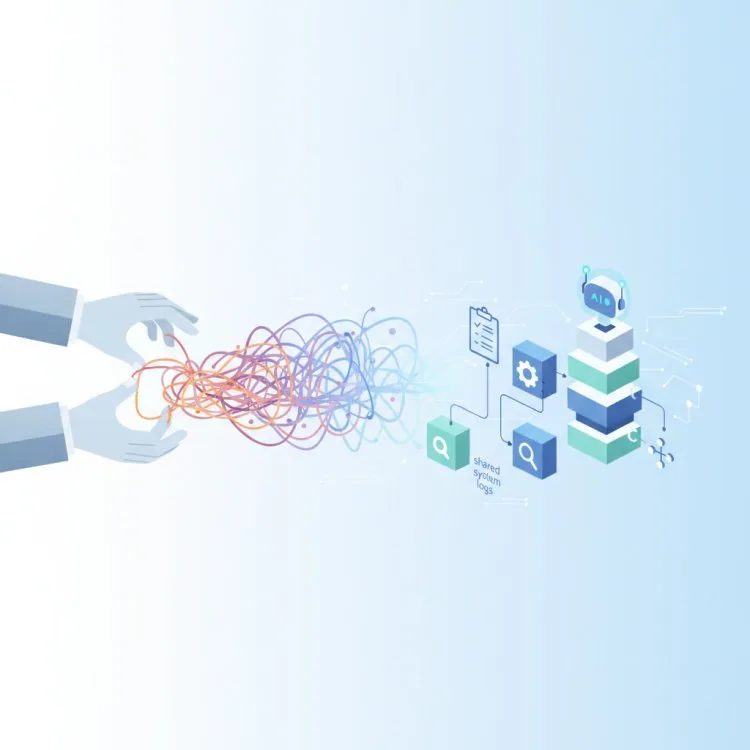
No entanto, quem já implantou agentes de IA de várias etapas em produção sabe que a realidade é bem mais bagunçada. Entupir o contexto do prompt de um agente com históricos de chat intermináveis, instantâneos extensos de bases de código e logs brutos de API não produz um trabalhador mais inteligente. Em vez disso, gera o "apodrecimento de contexto": um estado em que o modelo perde o foco, alucina detalhes enterrados no ruído e consome orçamentos computacionais apenas tentando interpretar o próprio passado.
Estamos chegando a um ponto de inflexão na automação de fluxos de trabalho. O setor está percebendo uma verdade contraintuitiva: os agentes autônomos não precisam de uma memória enorme e desestruturada. Precisam de uma documentação limpa e dinâmica.
A falácia do contexto infinito na automação de fluxos de trabalho
Para entender por que as arquiteturas com muita memória estão batendo em um muro, considere como as organizações humanas funcionam. Se uma equipe de engenharia de software ou um departamento de marketing integrasse um novo prestador de serviços entregando-lhe um despejo bruto e desorganizado de todas as mensagens do Slack, threads de e-mail e logs de commits dos últimos cinco anos, esse prestador provavelmente fracassaria. Ele não saberia o que é relevante agora, o que foi descontinuado ou quem tem a palavra final nas decisões.
No entanto, é exatamente assim que muitos pipelines de IA automatizados foram projetados para funcionar. Os desenvolvedores criam um agente, conectam um enorme banco de dados vetorial ou uma ampla janela de contexto e esperam que o modelo filtre o ruído histórico para descobrir o estado atual de uma tarefa.
Essa abordagem falha por três razões principais:
- Alta latência e custo: processar milhares de tokens redundantes a cada ciclo de execução eleva os custos de API e introduz uma latência perceptível nos fluxos de trabalho automatizados.
- Diluição da atenção: os transformers dependem de mecanismos de atenção. Quando a relação sinal-ruído cai por causa de contexto histórico irrelevante, a capacidade do modelo de raciocinar sobre a tarefa imediata se degrada.
- Premissas desatualizadas: os históricos de chat brutos costumam conter ideias abandonadas, tentativas de depuração fracassadas e instruções ultrapassadas. Um agente que lê um log de histórico bruto pode, sem querer, ressuscitar uma abordagem ruim que a equipe descartou semanas atrás.
Passando da memória para a documentação dinâmica
A solução que surge nos frameworks de automação avançados é a migração para uma arquitetura que prioriza a documentação. Em vez de tratar a memória de um agente como uma lixeira passiva de tudo o que ele já viu, os desenvolvedores projetam sistemas em que os agentes mantêm, leem e atualizam ativamente arquivos markdown estruturados, registros de decisões arquitetônicas (ADRs) e manifestos de estado em tempo real.
Nesse modelo, o ambiente do agente funciona como uma wiki bem mantida. Quando um agente executa uma etapa do fluxo de trabalho, seja refatorando um microsserviço, triando chamados de suporte ao cliente ou gerando um relatório financeiro, ele não registra os seus pensamentos em um histórico de chat sem fundo. Em vez disso, atualiza uma seção específica de uma árvore de documentação centralizada.
Essa mudança transforma a forma como os agentes interagem com o mundo:
- Leituras determinísticas: em vez de depender de uma busca semântica difusa em milhões de tokens de históricos de chat, o agente lê um documento de status conciso e legível por humanos, que descreve explicitamente os objetivos atuais, as restrições e os marcos já concluídos.
- Transparência com humano no circuito: a documentação estruturada é transparente. Gestores de TI e desenvolvedores podem abrir um arquivo, ver exatamente o que o agente acredita ser o estado atual de um projeto e editá-lo diretamente se o agente sair do rumo.
- Portabilidade modular: quando a documentação fica em arquivos modulares e limpos, e não em um banco de dados vetorial proprietário, os agentes podem ser facilmente trocados, atualizados ou executados em sandboxes descentralizadas sem perder o estado operacional.
Boas práticas para implementar agentes orientados por documentação
Se você está criando ou escalando fluxos de trabalho automatizados com agentes de IA, abandonar a memória de força bruta exige uma mudança deliberada no design do sistema. Este é um roteiro prático para implementar um pipeline de automação que prioriza a documentação:
- Defina esquemas de estado claros: estabeleça modelos rigorosos para o que o agente deve documentar após concluir uma tarefa. Use markdown com títulos claros, como Objetivo atual, Bloqueios ativos e Próximas ações.
- Imponha ciclos de gravação de retorno: programe os fluxos de trabalho dos seus agentes para encerrar cada ciclo de execução importante com uma operação de gravação que atualize os arquivos de documentação, garantindo que a execução seguinte comece com um contexto novo e resumido.
- Pode continuamente: trate a documentação dos agentes como repositórios de código. Implemente linting automatizado ou prompts de revisão secundária que eliminem informações obsoletas, evitando o inchaço da documentação.
- Separe os logs do estado: mantenha os logs brutos de execução (respostas de API, saídas de terminal) em um repositório de telemetria separado. Deixe que o agente consulte esses logs apenas quando uma depuração específica for necessária, em vez de mantê-los permanentemente no caminho ativo do prompt.
- Mantenha os arquivos locais e sob controle de versão: armazene os arquivos de estado do agente em diretórios locais ou repositórios git. Isso permite acompanhar como a compreensão que o agente tem de um projeto evolui ao longo do tempo e reverter alterações se o modelo corromper as próprias instruções.
O caminho à frente para os fluxos de trabalho autônomos
À medida que os agentes de IA passam de novidades experimentais a componentes centrais da infraestrutura corporativa, o diferencial não será quantos tokens um modelo consegue guardar na memória de curto prazo. Será a clareza com que os engenheiros conseguem projetar a arquitetura de informação que cerca o agente.
Ao tratar a documentação como a interface principal entre a intenção humana e a execução da máquina, podemos construir sistemas automatizados mais enxutos, mais confiáveis e muito mais fáceis de auditar. No mundo dos agentes de IA, a clareza sempre vencerá a desordem.
Como a sua equipe está gerenciando o estado e o contexto dos agentes nos seus pipelines de automação atuais? Adotar cedo a documentação estruturada pode ser o avanço de que os seus fluxos de trabalho precisam para escalar com sucesso.
More about ai agents
Want to go further with ai agents? These Netstech guides and services are a good next step: