Ces dernières années, la course en intelligence artificielle a été largement définie par une seule métrique : la longueur du contexte. Tous les quelques mois, les grands laboratoires lancent des modèles capables d'ingérer des centaines de milliers — voire des millions — de jetons à la fois. La promesse implicite faite aux développeurs et aux architectes d'automatisation était simple : donnez tout à l'IA, et elle se souviendra de tout. Si un agent autonome a accès à tout l'historique d'un projet, il prendra sûrement de meilleures décisions.
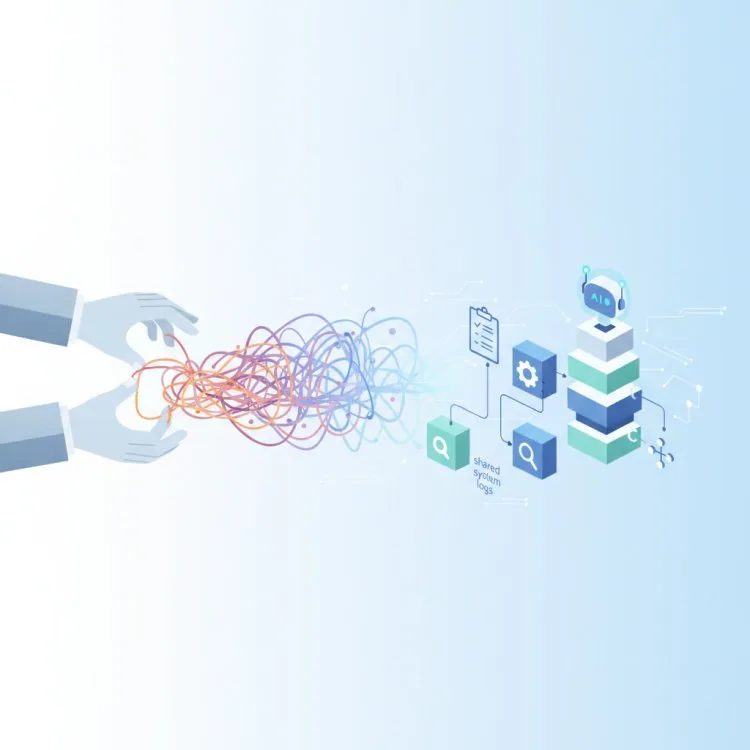
Pourtant, quiconque a déployé des agents IA multi-étapes en production sait que la réalité est bien plus désordonnée. Bourrer le contexte du prompt d'un agent d'historiques de chat interminables, d'instantanés tentaculaires de base de code et de journaux d'API bruts ne produit pas un travailleur plus intelligent. Cela introduit plutôt la « dégradation du contexte » — un état où le modèle perd le fil, hallucine des détails enfouis dans le bruit et épuise ses budgets de calcul rien que pour analyser son propre passé.
Nous atteignons un point d'inflexion dans l'automatisation des flux de travail. L'industrie découvre une vérité contre-intuitive : les agents autonomes n'ont pas besoin d'une mémoire massive et non structurée. Ils ont besoin d'une documentation propre et dynamique.
Le mythe du contexte infini dans l'automatisation des flux de travail
Pour comprendre pourquoi les architectures gourmandes en mémoire atteignent un mur, observez le fonctionnement des organisations humaines. Si une équipe d'ingénierie logicielle ou un service marketing intégrait un nouveau prestataire en lui remettant un vidage brut et désorganisé de chaque message Slack, fil d'e-mails et journal de commits des cinq dernières années, ce prestataire échouerait probablement. Il ne saurait pas ce qui est actuellement pertinent, ce qui est obsolète, ni qui détient le pouvoir de décision final.
Pourtant, c'est précisément ainsi que de nombreux pipelines d'IA automatisés ont été conçus. Les développeurs lancent un agent, y attachent une immense base de données vectorielle ou une vaste fenêtre de contexte, et attendent du modèle qu'il trie le bruit historique pour comprendre l'état actuel d'une tâche.
Cette approche échoue pour trois raisons principales :
- Latence et coût élevés : traiter des milliers de jetons redondants à chaque boucle d'exécution fait grimper les coûts d'API et introduit une latence notable dans les flux de travail automatisés.
- Dilution de l'attention : les transformers reposent sur des mécanismes d'attention. Lorsque le rapport signal/bruit chute à cause d'un contexte historique non pertinent, la capacité du modèle à raisonner sur la tâche immédiate se dégrade.
- Hypothèses périmées : les historiques de chat bruts contiennent souvent des idées abandonnées, des tentatives de débogage ratées et des instructions obsolètes. Un agent qui lit un journal d'historique brut peut ressusciter par erreur une mauvaise approche que l'équipe a écartée il y a des semaines.
Passer de la mémoire à la documentation dynamique
La solution qui émerge dans les frameworks d'automatisation avancés est un virage vers une architecture axée sur la documentation. Plutôt que de traiter la mémoire d'un agent comme un bac de stockage passif pour tout ce qu'il a déjà vu, les développeurs conçoivent des systèmes où les agents maintiennent, lisent et mettent à jour activement des fichiers markdown structurés, des enregistrements de décisions d'architecture (ADR) et des manifestes d'état en direct.
Dans ce modèle, l'environnement de l'agent fonctionne comme un wiki bien entretenu. Lorsqu'un agent exécute une étape de flux de travail — qu'il s'agisse de refactoriser un microservice, de trier des tickets de support client ou de générer un rapport financier — il ne consigne pas ses réflexions dans un historique de chat sans fond. Il met plutôt à jour une section précise d'une arborescence de documentation centralisée.
Ce changement transforme la façon dont les agents interagissent avec le monde :
- Lectures déterministes : au lieu de s'appuyer sur une recherche sémantique floue parmi des millions de jetons d'historiques de chat, l'agent lit un document d'état concis et lisible par un humain qui décrit explicitement les objectifs actuels, les contraintes et les jalons accomplis.
- Transparence avec humain dans la boucle : la documentation structurée est transparente. Les responsables informatiques et les développeurs peuvent ouvrir un fichier, voir exactement ce que l'agent croit être l'état actuel d'un projet et le modifier directement si l'agent s'est égaré.
- Portabilité modulaire : lorsque la documentation réside dans des fichiers modulaires propres plutôt que dans une base de données vectorielle propriétaire, les agents peuvent facilement être remplacés, mis à niveau ou exécutés dans des sandbox décentralisés sans perdre leur état opérationnel.
Bonnes pratiques pour mettre en œuvre des agents pilotés par la documentation
Si vous créez ou déployez à grande échelle des flux de travail automatisés avec des agents IA, s'éloigner de la mémoire par force brute exige un changement délibéré dans la conception du système. Voici une feuille de route pratique pour mettre en place un pipeline d'automatisation axé sur la documentation :
- Définissez des schémas d'état clairs : établissez des modèles stricts de ce qu'un agent doit documenter après avoir terminé une tâche. Utilisez du markdown avec des titres clairs, comme Objectif actuel, Blocages actifs et Prochaines actions.
- Imposez des boucles d'écriture en retour : programmez vos flux d'agents pour qu'ils concluent chaque cycle d'exécution majeur par une opération d'écriture qui met à jour les fichiers de documentation, afin que la prochaine exécution démarre avec un contexte frais et résumé.
- Élaguez en continu : traitez la documentation des agents comme des dépôts de code. Mettez en place un linting automatisé ou des prompts de revue secondaire qui élaguent les informations obsolètes, pour éviter le gonflement de la documentation.
- Séparez les journaux de l'état : conservez les journaux d'exécution bruts (réponses d'API, sorties de terminal) dans un magasin de télémétrie distinct. Laissez l'agent interroger ces journaux uniquement lorsqu'un débogage précis l'exige, plutôt que de les garder en permanence dans le chemin actif du prompt.
- Gardez les fichiers en local et sous contrôle de version : stockez les fichiers d'état des agents dans des répertoires locaux ou des dépôts git. Cela permet de suivre l'évolution de la compréhension d'un projet par l'agent et d'annuler les changements si le modèle corrompt ses propres instructions.
La route à suivre pour les flux de travail autonomes
Alors que les agents IA passent de nouveautés expérimentales à composants essentiels de l'infrastructure d'entreprise, ce qui fera la différence ne sera pas le nombre de jetons qu'un modèle peut conserver dans sa mémoire à court terme. Ce sera la propreté avec laquelle les ingénieurs sauront concevoir l'architecture de l'information autour de l'agent.
En traitant la documentation comme l'interface principale entre l'intention humaine et l'exécution machine, nous pouvons construire des systèmes automatisés plus légers, plus fiables et bien plus faciles à auditer. Dans le monde des agents IA, la clarté triomphera toujours du désordre.
Comment votre équipe gère-t-elle l'état et le contexte des agents dans vos pipelines d'automatisation actuels ? Adopter tôt une documentation structurée pourrait bien être la percée dont vos flux de travail ont besoin pour passer à l'échelle.
More about ai agents
Want to go further with ai agents? These Netstech guides and services are a good next step: