引言:
数据科学已发展成为二十一世纪的变革性技术。由于这是一份高薪且颇具挑战的工作,许多人渴望成为数据科学家。对原始数据的研究对数据科学至关重要。它是提取、评估、展示、管理和存储数据以产生洞察的过程。这些视角帮助企业做出明智的、数据驱动的决策。数据科学需要同时利用非结构化数据和结构化数据。
数据科学的含义是什么?
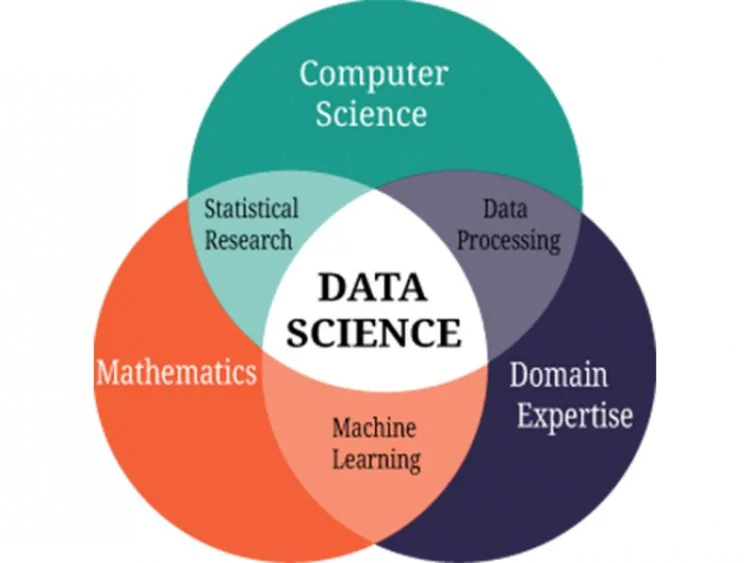
数据科学是运用创新的分析工具或技术以及科学概念,从原始数据中提取有意义的信息,用于商业决策、战略规划和其他各种应用。
数据科学是统计学、人工智能(AI)、科学方法和数据分析等多个学科的结合。在数据科学中,通过运用所有这些领域,从原始数据中提炼出有意义的数据。
谁是数据科学家?
从事数据科学实践的人被称为数据科学家。
数据科学背后的故事是什么?
1962 年,美国数学家 John W. Tukey 首次阐述了数据科学的目标。早在 1974 年,Peter Naur 就将其作为计算机科学的名称提出。
随着首届数据库知识发现(KDD)研讨会的举办以及 20 世纪 80 至 90 年代国际分类学会联合会(IFCS)的成立,数据科学开始取得长足进步。
数据科学的目的是什么?
数据科学的主要目标是发现数据中的设计和模式。它使用各种统计技术来检查、分析并从数据中得出洞察。从数据提取、整理和预处理开始,数据科学家必须对数据进行彻底检查。
然后,他有责任根据数据构建预测。数据科学家的目标是从数据中得出结论。[1]
数据科学是如何工作的?
检查并处理数据的过程是迭代的而非线性的,但对于一个数据建模项目,数据科学的开发流程通常是这样的:
规划: 在规划阶段,我们定义项目并讨论其各个方面。
构建数据模型:数据科学家通常会使用各种开源库和数据工具来构建机器学习模型。借助这些工具,数据科学家构建出模型。
评估模型: 数据科学家必须做到 100% 满意并具备足够的信心,以便在部署模型之前能够从不同方面对其进行评估。
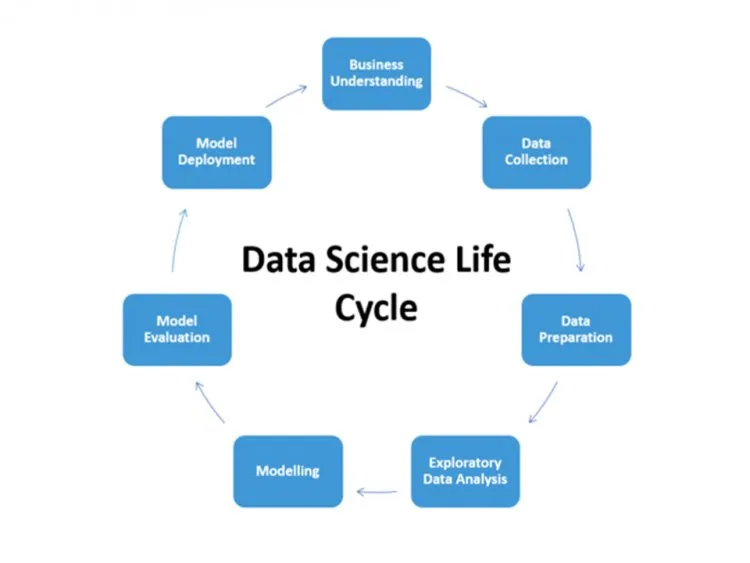
解释模型:用人类的语言描述机器学习模型输出背后的基本机制并不总是容易,但这越来越有必要。数据科学家希望他们的工作实现自动化。
部署模型:将训练好的机器学习模型部署到相关系统中可能是一个具有挑战性且耗时的过程。通过将模型实现为可扩展且安全的 API,或使用数据库内机器学习模型,可以简化这一过程。
监控模型:遗憾的是,仅仅安装模型并不是故事的终点。部署之后,必须持续检查模型,以确认其运行有效。[2]
数据科学有哪些优势?
- 它非常受欢迎。
- 大量职位
- 高薪工作
- 数据科学是一门可塑性很强的科学。
- 数据科学改进数据。
- 数据科学家备受尊重。
数据科学有哪些缺点?
- 数据科学是一个模糊的术语。
- 数据科学几乎难以掌握。
- 需要大量的领域知识。
- 任意的数据可能会导致意想不到的结果。
- 数据隐私问题
- 数据科学的目的是什么?了解其重要性。来源:https://data-flair.training/blogs/purpose-of-data-science/。
- 什么是数据科学?;来源:https://www.oracle.com/pk/data-science/what-is-data-science/。
数据科学流程
- 用业务语言定义问题。
- 收集并清洗数据,通常是耗时最长的步骤。
- 探索数据,使用图表和统计。
- 模型:选择并训练机器学习模型;参见什么是机器学习。
- 在模型未见过的数据上评估模型。
- 部署和监控,使结果持续保持有用。
技能与工具
统计学、编程(Python 或 R)、SQL、数据可视化和领域知识。常用工具包括 pandas、scikit-learn、Jupyter notebook 和 BI 仪表板。
业务示例
预测产品需求、为潜在客户评分、检测欺诈、对客户进行分组以及衡量营销回报。对于零售商,我们的 AI 分析与需求预测服务会将这些方法应用于销售数据。
快速解答
数据科学等同于 AI 吗?
它们相互重叠。数据科学侧重于从数据中提取洞察;AI 侧重于构建能够智能执行任务的系统。机器学习则同时属于两者。