परिचय:
डेटा साइंस इक्कीसवीं सदी की एक परिवर्तनकारी तकनीक बन गई है। कई लोग डेटा साइंटिस्ट बनने की आकांक्षा रखते हैं क्योंकि यह अच्छे वेतन वाला और चुनौतीपूर्ण काम है। कच्चे डेटा का अध्ययन डेटा साइंस के लिए महत्वपूर्ण है। यह प्रभाव उत्पन्न करने के लिए डेटा को निकालने, मूल्यांकन करने, प्रदर्शित करने, प्रबंधित करने और संग्रहीत करने की प्रक्रिया है। ये दृष्टिकोण व्यवसायों को सूचित, डेटा-आधारित निर्णय लेने में सहायता करते हैं। डेटा साइंस में असंरचित और संगठित दोनों प्रकार के डेटा का उपयोग आवश्यक है।
डेटा साइंस का अर्थ क्या है?
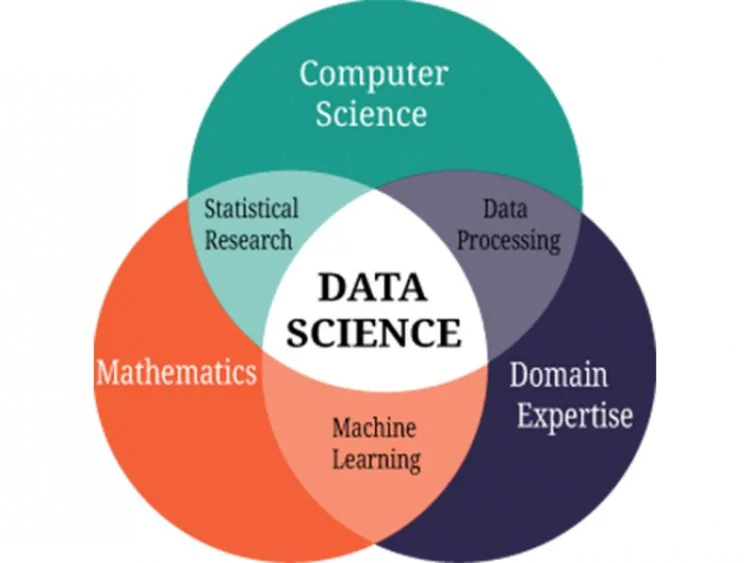
डेटा साइंस व्यावसायिक निर्णय लेने, रणनीतिक योजना बनाने और अन्य कई उपयोगों के लिए कच्चे डेटा से सार्थक जानकारी निकालने हेतु नवीन एनालिटिक्स टूल या तकनीकों के साथ-साथ वैज्ञानिक अवधारणाओं का अनुप्रयोग है।
डेटा साइंस कई विषयों का मिश्रण है, जैसे सांख्यिकी, आर्टिफ़िशियल इंटेलिजेंस (AI), वैज्ञानिक पद्धतियाँ और डेटा विश्लेषण। डेटा साइंस में इन सभी क्षेत्रों का उपयोग करके कच्चे डेटा से सार्थक डेटा निकाला जाता है।
डेटा साइंटिस्ट कौन है?
जो व्यक्ति डेटा साइंस का अभ्यास करता है, उसे डेटा साइंटिस्ट कहा जाता है।
डेटा साइंस की पर्दे के पीछे की कहानी क्या है?
1962 में अमेरिकी गणितज्ञ जॉन डब्ल्यू. टुकी ने पहली बार डेटा साइंस का लक्ष्य व्यक्त किया। 1974 में पीटर नॉर ने इसे कंप्यूटर साइंस के नाम के रूप में प्रस्तावित किया।
1980 और 1990 के दशक में पहली नॉलेज डिस्कवरी इन डेटाबेसेस (KDD) कार्यशाला और इंटरनेशनल फ़ेडरेशन ऑफ़ क्लासिफ़िकेशन सोसाइटीज़ (IFCS) की स्थापना के साथ डेटा साइंस ने काफ़ी प्रगति की।
डेटा साइंस का उद्देश्य क्या है?
डेटा साइंस का मुख्य निर्धारण डेटा के भीतर डिज़ाइन और पैटर्न खोजना है। यह डेटा की जाँच, विश्लेषण करने और उससे अंतर्दृष्टि निकालने के लिए विभिन्न सांख्यिकीय तकनीकों का उपयोग करती है। डेटा निष्कर्षण, रैंग्लिंग और प्री-प्रोसेसिंग से लेकर, डेटा साइंटिस्ट को डेटा का गहराई से निरीक्षण करना होता है।
फिर, उस पर डेटा से भविष्यवाणियाँ बनाने की जवाबदेही होती है। डेटा साइंटिस्ट का उद्देश्य डेटा से निष्कर्ष निकालना है। [1]
डेटा साइंस कैसे काम करती है?
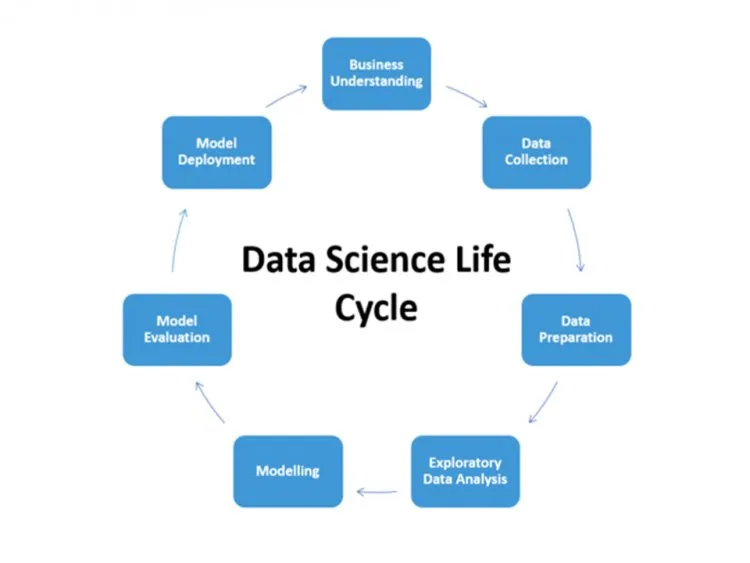
डेटा के परीक्षण और उस पर कार्रवाई की प्रक्रिया रैखिक नहीं बल्कि पुनरावृत्तिपूर्ण होती है, लेकिन डेटा मॉडलिंग प्रोजेक्ट के लिए डेटा साइंस का विकास आमतौर पर इसी प्रकार आगे बढ़ता है:
योजना: योजना चरण में हम प्रोजेक्ट को परिभाषित करते हैं और उसके विभिन्न पहलुओं पर चर्चा करते हैं।
डेटा मॉडल बनाना: डेटा साइंटिस्ट आमतौर पर मशीन लर्निंग मॉडल बनाने के लिए कई तरह की ओपन सोर्स लाइब्रेरी और डेटा टूल का उपयोग करता है। इनकी मदद से डेटा साइंटिस्ट ने एक मॉडल बनाया।
मॉडल का मूल्यांकन: डेटा साइंटिस्ट को 100% संतुष्टि और पर्याप्त विश्वास की आवश्यकता होती है ताकि वे तैनाती से पहले मॉडल का अलग-अलग पहलुओं से मूल्यांकन कर सकें।
मॉडलों की व्याख्या: मशीन लर्निंग मॉडल के आउटपुट के मूल तंत्र को मानवीय शब्दों में समझाना हमेशा आसान नहीं रहा है, लेकिन यह लगातार ज़रूरी होता जा रहा है। डेटा साइंटिस्ट चाहते हैं कि उनका काम स्वचालित हो।
मॉडल को तैनात करना: प्रशिक्षित मशीन लर्निंग मॉडल को संबंधित सिस्टम में पहुँचाना एक चुनौतीपूर्ण और समय लेने वाली प्रक्रिया हो सकती है। मॉडलों को स्केलेबल और सुरक्षित API के रूप में लागू करके, या इन-डेटाबेस मशीन लर्निंग मॉडल का उपयोग करके इसे आसान बनाया जा सकता है।
मॉडलों की निगरानी: दुर्भाग्य से, केवल मॉडल को इंस्टॉल कर देना कहानी का अंत नहीं है। तैनाती के बाद, मॉडलों की लगातार जाँच करनी चाहिए ताकि यह सुनिश्चित हो कि वे प्रभावी ढंग से काम कर रहे हैं।[2]
डेटा साइंस क्या फ़ायदे देती है?
- यह वास्तव में लोकप्रिय है।
- पदों की भरमार
- अच्छी तनख़्वाह वाला काम
- डेटा साइंस एक लचीला विज्ञान है।
- डेटा साइंस डेटा को बेहतर बनाती है।
- डेटा साइंटिस्ट को उच्च स्तर का सम्मान मिलता है।
डेटा साइंस की कमियाँ क्या हैं?
- डेटा साइंस एक धुँधला-सा शब्द है।
- डेटा साइंस को समझना लगभग कठिन है।
- काफ़ी मात्रा में डोमेन ज्ञान आवश्यक है।
- मनमाने डेटा के कारण अप्रत्याशित परिणाम आ सकते हैं।
- डेटा गोपनीयता का मुद्दा
- What is the Purpose of Data Science? Know Its Importance. यहाँ से उपलब्ध: https://data-flair.training/blogs/purpose-of-data-science/.
- What is Data Science?; यहाँ से उपलब्ध: https://www.oracle.com/pk/data-science/what-is-data-science/.
डेटा साइंस प्रक्रिया
- प्रश्न को परिभाषित करें व्यावसायिक शब्दों में।
- डेटा एकत्र करें और साफ़ करें, आमतौर पर सबसे लंबा चरण।
- चार्ट और सांख्यिकी के साथ डेटा को खंगालें।
- मॉडल: एक मशीन-लर्निंग मॉडल चुनें और प्रशिक्षित करें; देखें मशीन लर्निंग क्या है।
- मॉडल का मूल्यांकन करें उस डेटा पर जो उसने नहीं देखा है।
- तैनात करें और निगरानी करें ताकि परिणाम उपयोगी बने रहें।
कौशल और टूल
सांख्यिकी, प्रोग्रामिंग (Python या R), SQL, डेटा विज़ुअलाइज़ेशन और डोमेन ज्ञान। आम टूल में pandas, scikit-learn, Jupyter नोटबुक और BI डैशबोर्ड शामिल हैं।
व्यावसायिक उदाहरण
उत्पाद की माँग का पूर्वानुमान, लीड की स्कोरिंग, धोखाधड़ी की पहचान, ग्राहकों का समूहन और मार्केटिंग रिटर्न का मापन। रिटेलर्स के लिए, हमारी AI एनालिटिक्स और डिमांड फ़ोरकास्टिंग सेवा इन विधियों को बिक्री डेटा पर लागू करती है।
त्वरित उत्तर
क्या डेटा साइंस और AI एक ही हैं?
दोनों में आपस में समानता है। डेटा साइंस डेटा से अंतर्दृष्टि निकालने पर केंद्रित है; AI ऐसे सिस्टम बनाने पर केंद्रित है जो कार्यों को बुद्धिमानी से करें। मशीन लर्निंग दोनों में आती है।