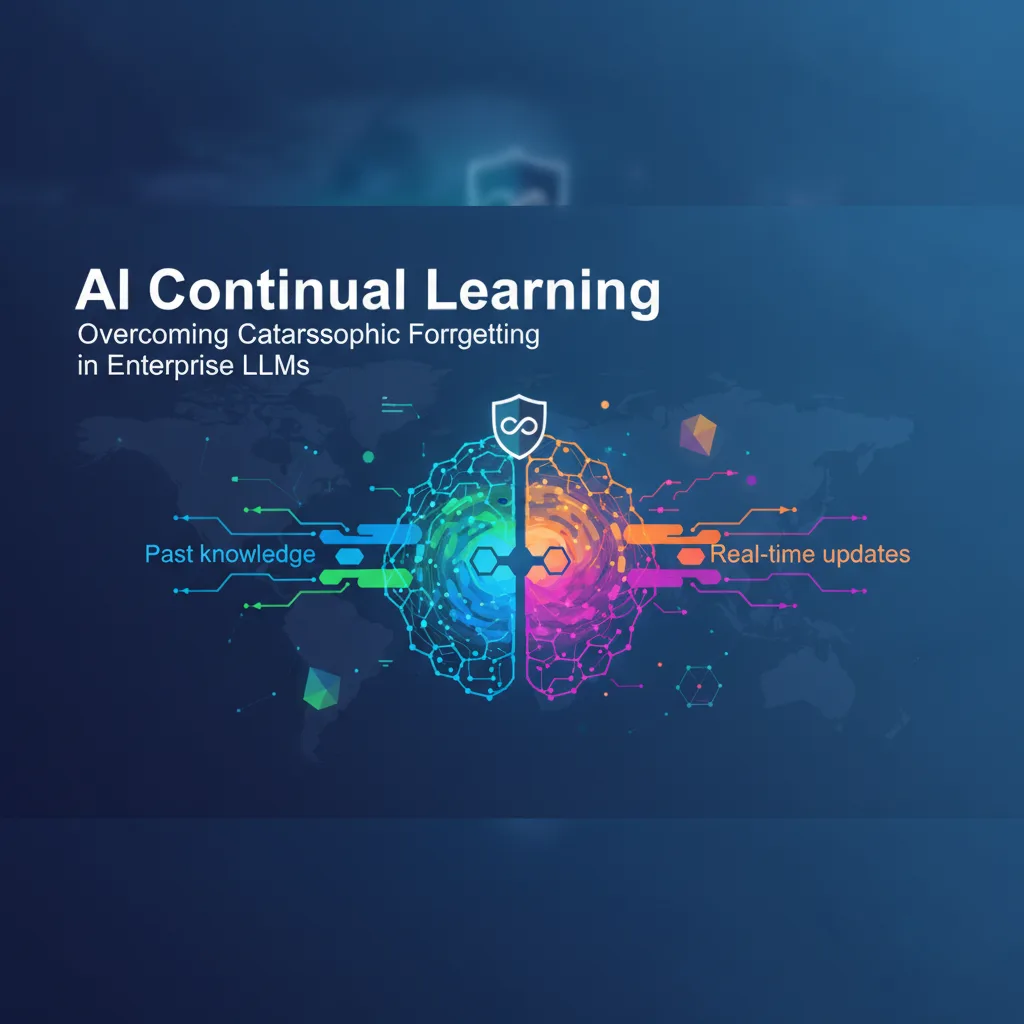
पिछले कुछ वर्षों से किसी एंटरप्राइज़ बड़े भाषा मॉडल (LLM) को अप-टू-डेट रखने का मानक तरीका दो भारी-भरकम उपायों पर टिका रहा है: शुरू से महंगा पूर्ण री-ट्रेनिंग, या एक स्थिर बेस मॉडल के ऊपर जोड़ा गया निरंतर Retrieval-Augmented Generation (RAG)। RAG बाहरी डेटाबेस के आधार पर उत्तर तय करने के लिए एक प्रभावी पुल बना रहता है, लेकिन यह आधुनिक न्यूरल नेटवर्क की मूल आर्किटेक्चरल सीमा को हल नहीं करता: जब आप किसी AI मॉडल को कुछ बिल्कुल नया सिखाते हैं, तो वह पहले सीखी हुई बातों को अक्सर मिटा देता है। इस परिघटना को कैटास्ट्रोफिक फॉरगेटिंग कहते हैं, और यह आधुनिक मशीन लर्निंग इंजीनियरिंग की सबसे जिद्दी रुकावटों में से एक है।
जैसे-जैसे संगठन स्वायत्त एजेंट और डोमेन-विशिष्ट कोपायलट तैनात कर रहे हैं, जिन्हें रोज़ बदलते कारोबार के साथ विकसित होना पड़ता है, वैसे-वैसे कैटास्ट्रोफिक फॉरगेटिंग से निपटना एक अकादमिक कंप्यूटर साइंस समस्या से बदलकर एंटरप्राइज़ की अहम प्राथमिकता बन गया है। संरचनात्मक निरंतर सीखने के फ्रेमवर्क में हाल की सफलताएँ इंजीनियरों के इस चुनौती को देखने का तरीका बदलने लगी हैं, और हमें ऐसे मॉडलों के करीब ले जा रही हैं जो इंसानी पेशेवरों की तरह समय के साथ सचमुच सीख सकें, बजाय इसके कि उन्हें बार-बार महंगे ढंग से बदलना पड़े।
मूल दुविधा: स्थिर मॉडल गतिशील एंटरप्राइज़ डेटा के साथ क्यों जूझते हैं
निरंतर सीखना इतना कठिन क्यों है, यह समझने के लिए देखना होगा कि डीप लर्निंग मॉडल जानकारी कैसे संग्रहीत करते हैं। पारंपरिक रिलेशनल डेटाबेस में नई पंक्ति को तालिका में साफ़-सुथरे ढंग से जोड़ा जा सकता है और मौजूदा रिकॉर्ड प्रभावित नहीं होते। इसके उलट, LLM ज्ञान को अरबों फ्लोटिंग-पॉइंट वेट्स में एन्कोड करता है, जो उसकी पूरी न्यूरल आर्किटेक्चर में फैले होते हैं।
जब आप पहले से प्रशिक्षित मॉडल को नए डेटा पर फाइन-ट्यून करते हैं, जैसे अपडेट की गई आंतरिक अनुपालन नीतियाँ, नए जारी उत्पाद विनिर्देश या बदलते बाज़ार नियम, तो ऑप्टिमाइज़ेशन एल्गोरिदम नए डेटासेट पर पूर्वानुमान की त्रुटि घटाने के लिए इन वेट्स को समायोजित करता है। ऐसा करते हुए वह अक्सर वेट्स को उन इष्टतम विन्यासों से दूर खिसका देता है जो पुराने कार्यों के लिए ज़रूरी थे। मॉडल नए अनुपालन दिशानिर्देशों में माहिर हो सकता है, लेकिन अचानक वह एक सप्ताह पहले तक जानी हुई बुनियादी संचालन प्रक्रियाओं के बारे में गलत जानकारी गढ़ने लगता है या उन्हें पूरी तरह भूल जाता है।
ऐतिहासिक रूप से संगठन इसका हल यह निकालते रहे हैं कि पुरानी और नई, दोनों जानकारी वाले विशाल ऐतिहासिक डेटासेट जमा करके मॉडल को शुरू से दोबारा प्रशिक्षित करें। यह तरीका न केवल कंप्यूटेशन के लिहाज़ से बेहद महंगा और पर्यावरण पर बोझ डालने वाला है, बल्कि संचालन में भी सुस्त है। जब तक करोड़ों डॉलर की ट्रेनिंग पूरी होती है, तब तक कारोबारी परिदृश्य फिर बदल चुका होता है।
उभरते समाधान: निरंतर सीखने में आर्किटेक्चर संबंधी बदलाव
हाल के शोध और फ्रेमवर्क विकास कैटास्ट्रोफिक फॉरगेटिंग से लड़ने के ऐसे परिष्कृत तरीके ला रहे हैं जिनमें पूर्ण री-ट्रेनिंग चक्र की ज़रूरत नहीं पड़ती। ये तकनीकें आम तौर पर तीन अलग-अलग पद्धतिगत श्रेणियों में आती हैं:
- रेगुलराइज़ेशन-आधारित दृष्टिकोण: ये तरीके पहले सीखे गए कार्यों के लिए मॉडल के अलग-अलग वेट्स का महत्व आँकते हैं। नया डेटा आने पर ऑप्टिमाइज़ेशन एल्गोरिदम उन वेट्स में बदलाव पर दंड लगाता है जो ऐतिहासिक ज्ञान के लिए सबसे अहम हैं, और अनुकूलन केवल कम महत्वपूर्ण पैरामीटर क्षेत्रों में होने देता है।
- मॉड्यूलर और मेमोरी-ऑग्मेंटेड आर्किटेक्चर: वेट्स के एकल विशाल समूह को बदलने के बजाय, नए फ्रेमवर्क डायनामिक सब-नेटवर्क या विशेष मेमोरी बफ़र का उपयोग करते हैं। नया ज्ञान समर्पित पैरामीटर मॉड्यूल या एपिसोडिक मेमोरी स्टोर में भेजा जाता है, और मूल तर्क-इंजन अछूता रहता है।
- रीप्ले-आधारित फ्रेमवर्क: सावधानी से तैयार किए गए सिंथेटिक डेटा या पुराने ट्रेनिंग कॉर्पस के संपीड़ित रूपों का उपयोग करते हुए, ये सिस्टम फाइन-ट्यूनिंग के दौरान ऐतिहासिक डेटा नमूनों को आने वाले रियल-टाइम अपडेट के साथ मिलाते हैं, जिससे न्यूरल नेटवर्क अतीत और वर्तमान के ज्ञान का संतुलित वितरण बनाए रखता है।
डेवलपरों और IT लीडरों के लिए निरंतर सीखने का क्या अर्थ है
इंजीनियरिंग टीमों और IT निर्णयकर्ताओं के लिए, मज़बूत निरंतर सीखने वाले फ्रेमवर्क की ओर यह विकास सॉफ़्टवेयर आर्किटेक्चर, इंफ्रास्ट्रक्चर लागत और तैनाती रणनीतियों पर गहरा असर डालता है।
पहला, यह गतिशील वर्कफ़्लो के लिए अति-जटिल RAG पाइपलाइनों पर निर्भरता घटाता है। RAG संरचित या असंरचित दस्तावेज़ों से तथ्यात्मक संदर्भ निकालने में उत्कृष्ट है, लेकिन जब किसी AI एजेंट को समय के साथ जटिल व्यवहार-पैटर्न, प्रक्रियात्मक वर्कफ़्लो या संगठन के सूक्ष्म तर्क को आत्मसात करना होता है, तो वह अक्सर संघर्ष करता है। निरंतर सीखना मॉडलों को यह तर्क सीधे अपने वेट पैरामीटर में समाहित करने देता है।
दूसरा, यह एंटरप्राइज़ AI के रखरखाव का आर्थिक समीकरण बदल देता है। पैरामीटर-कुशल तरीकों (जैसे LoRA या उसके डायनामिक उत्तराधिकारी) से निरंतर फाइन-ट्यूनिंग, निरंतर सीखने के सुरक्षा उपायों के साथ मिलकर, संगठनों को बार-बार होने वाली पूर्ण-स्तरीय ट्रेनिंग की लागत के एक अंश में विशिष्ट और अत्यंत सटीक मॉडल बनाए रखने देती है।
विकसित होते AI मॉडल लागू करने की सर्वोत्तम प्रथाएँ
यदि आपका संगठन डायनामिक मॉडल अपडेट और निरंतर सीखने की रणनीतियों पर विचार कर रहा है, तो संरचित दृष्टिकोण रखने से स्थिरता, सुरक्षा और पूर्वानुमेयता सुनिश्चित होती है। नीचे दी गई कार्यान्वयन चेकलिस्ट पर विचार करें:
- कठोर मूल्यांकन सूट बनाएँ: स्वचालित रिग्रेशन टेस्ट बेड के बिना निरंतर अपडेट कभी तैनात न करें। अपडेट प्रोडक्शन परिवेश में पहुँचने से पहले अप्रत्याशित गिरावट या भूलने को पकड़ने के लिए अपने मॉडल को ऐतिहासिक प्रॉम्प्ट के एक निश्चित सेट पर बेंचमार्क करें।
- डोमेन-विशिष्ट मॉड्यूल अलग रखें: अपने बेस रीज़निंग मॉडल को विशिष्ट कार्य के एडेप्टर से अलग रखें। छोटी, मॉड्यूलर परतों को अपडेट करने से कैटास्ट्रोफिक फॉरगेटिंग का दायरा काफ़ी घट जाता है।
- ट्रेनिंग डेटा की उत्पत्ति का ऑडिट करें: क्रमिक अपडेट में इस्तेमाल होने वाले डेटासेट पर सख़्त वर्ज़न कंट्रोल रखें। यदि मॉडल अवांछित व्यवहार दिखाने लगे, तो आपको उस बदलाव के लिए ज़िम्मेदार आने वाले डेटा के सटीक बैच तक पहुँचना होगा।
- गार्डरेल के साथ जोड़ें: निरंतर सीखना मॉडलों को अधिक अनुकूलनशील बनाता है, लेकिन यह अपने आप सुरक्षा की गारंटी नहीं देता। डायनामिक मॉडल अपडेट को रियल-टाइम आउटपुट गार्डरेल और नियतात्मक नीति इंजनों के साथ जोड़ें।
आगे की राह
स्थिर, भारी बैच वाली LLM तैनाती से तरल, लगातार सीखने वाली आर्किटेक्चर की ओर बदलाव एंटरप्राइज़ आर्टिफ़िशियल इंटेलिजेंस के परिपक्व चरण का संकेत है। जैसे-जैसे ये उन्नत मेमोरी और निरंतर सीखने के फ्रेमवर्क शोध प्रयोगशालाओं से निकलकर प्रोडक्शन-ग्रेड सॉफ़्टवेयर डेवलपमेंट किट में आ रहे हैं, कमज़ोर और जल्दी पुराने पड़ने वाले एंटरप्राइज़ मॉडल का दौर समाप्त होने की ओर है।
टेक्नोलॉजी लीडरों के लिए आगे रहने का मतलब यह समझना है कि AI रणनीति अब केवल इस बारे में नहीं है कि आज आप कौन-सा बेस मॉडल चुनते हैं, बल्कि इस बारे में भी है कि आपका इंफ्रास्ट्रक्चर उस मॉडल को कल अनुकूलित होने, सीखने और याद रखने में कितनी कुशलता से मदद कर सकता है।