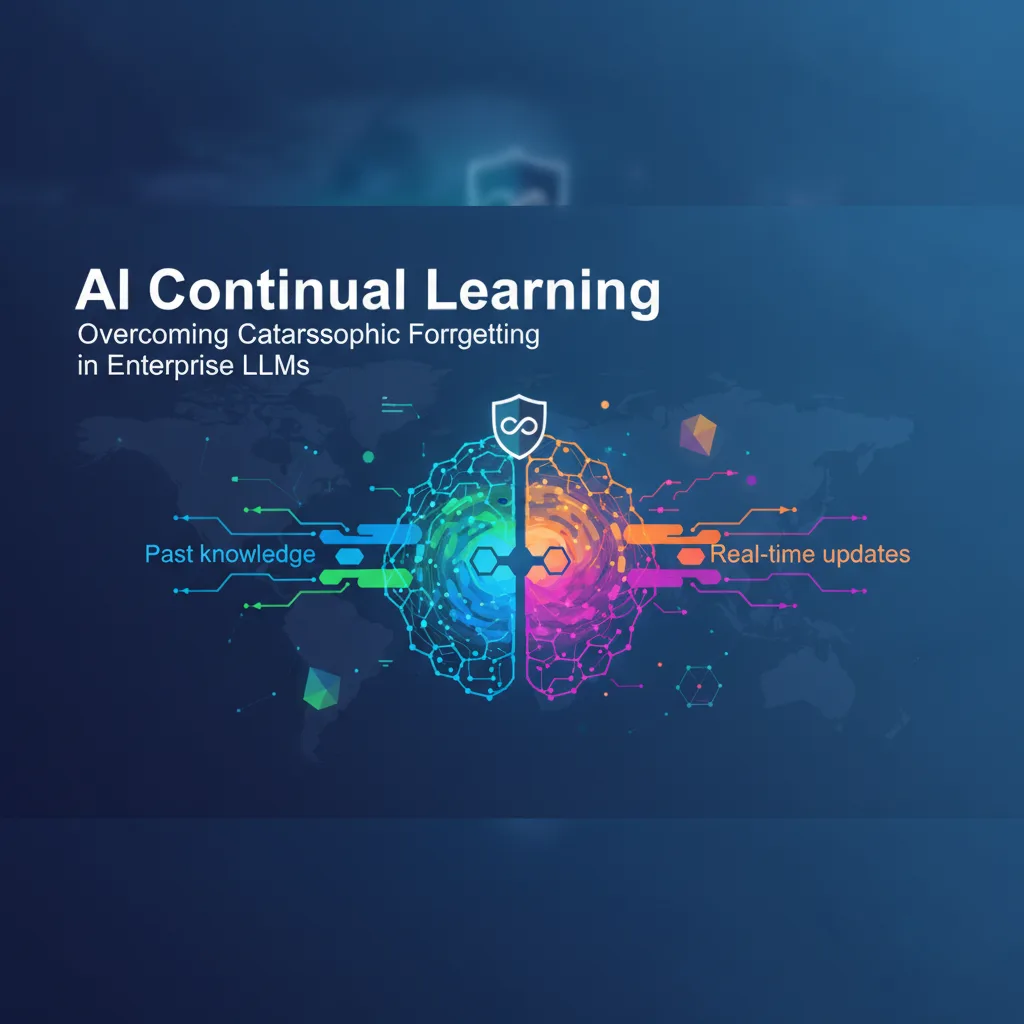
Nos últimos anos, o roteiro padrão para manter um grande modelo de linguagem (LLM) corporativo atualizado dependeu de dois métodos de força bruta: retreinamentos completos e caros, feitos do zero, ou Retrieval-Augmented Generation (RAG) contínuo acoplado a um modelo base estático. Embora o RAG continue sendo uma ponte eficaz para fundamentar respostas em bancos de dados externos, ele não resolve a limitação arquitetural central das redes neurais modernas: quando você ensina algo totalmente novo a um modelo de IA, ele tende a sobrescrever o que aprendeu antes. Esse fenômeno, conhecido como esquecimento catastrófico (catastrophic forgetting), é um dos gargalos mais teimosos da engenharia moderna de aprendizado de máquina.
À medida que as organizações buscam implantar agentes autônomos e copilotos específicos de domínio que precisam evoluir junto com as mudanças diárias do negócio, superar o esquecimento catastrófico deixou de ser um problema acadêmico da ciência da computação e passou a ser uma prioridade corporativa urgente. Avanços recentes em frameworks estruturais de aprendizado contínuo estão começando a mudar a forma como os engenheiros abordam esse desafio, aproximando-nos de modelos que realmente aprendem ao longo do tempo, como profissionais humanos, em vez de exigirem uma substituição constante e custosa.
O Dilema Central: Por Que Modelos Estáticos Têm Dificuldade com Dados Corporativos Dinâmicos
Para entender por que o aprendizado contínuo é tão difícil, ajuda observar como os modelos de aprendizado profundo armazenam informações. Diferentemente de um banco de dados relacional tradicional, em que uma nova linha pode ser inserida em uma tabela sem perturbar os registros existentes, um LLM codifica o conhecimento em bilhões de pesos de ponto flutuante distribuídos por toda a sua arquitetura neural.
Quando você faz o ajuste fino (fine-tuning) de um modelo pré-treinado com novos dados, como políticas internas de conformidade atualizadas, especificações de produtos recém-lançados ou regulamentações de mercado em mudança, o algoritmo de otimização ajusta esses pesos para minimizar o erro de previsão no novo conjunto de dados. Ao fazer isso, ele frequentemente afasta os pesos das configurações ideais exigidas pelas tarefas anteriores. O modelo pode dominar as novas diretrizes de conformidade, mas de repente alucina ou esquece por completo protocolos operacionais fundamentais que conhecia uma semana antes.
Historicamente, as organizações contornaram isso compilando enormes conjuntos de dados históricos com informações antigas e novas e retreinando o modelo desde o início. Essa abordagem não é apenas proibitiva do ponto de vista computacional e pesada para o meio ambiente, como também é lenta operacionalmente. Quando uma execução de treinamento de milhões de dólares termina, o cenário de negócios já mudou novamente.
Soluções Emergentes: Mudanças Arquiteturais no Aprendizado Contínuo
Pesquisas e desenvolvimentos de frameworks recentes estão introduzindo formas sofisticadas de combater o esquecimento catastrófico sem exigir ciclos completos de retreinamento. Essas técnicas geralmente se dividem em três categorias metodológicas distintas:
- Abordagens Baseadas em Regularização: Esses métodos calculam a importância de cada peso do modelo para tarefas aprendidas anteriormente. Quando novos dados são introduzidos, o algoritmo de otimização penaliza mudanças nos pesos mais importantes para o conhecimento histórico, permitindo adaptação apenas em espaços de parâmetros menos críticos.
- Arquiteturas Modulares e com Memória Aumentada: Em vez de modificar um conjunto monolítico de pesos, os frameworks mais novos utilizam sub-redes dinâmicas ou buffers de memória especializados. O novo conhecimento é direcionado a módulos de parâmetros dedicados ou a armazenamentos de memória episódica, deixando intacto o mecanismo central de raciocínio.
- Frameworks Baseados em Replay: Usando dados sintéticos cuidadosamente selecionados ou representações comprimidas de corpora de treinamento anteriores, esses sistemas intercalam amostras de dados históricos com as atualizações recebidas em tempo real durante o ajuste fino, induzindo a rede neural a manter uma distribuição equilibrada entre o conhecimento passado e o presente.
O Que o Aprendizado Contínuo Significa para Desenvolvedores e Líderes de TI
Para equipes de engenharia e tomadores de decisão de TI, a evolução rumo a frameworks robustos de aprendizado contínuo traz implicações significativas para a arquitetura de software, os custos de infraestrutura e as estratégias de implantação.
Primeiro, ele reduz a dependência de pipelines RAG hipercomplexos em fluxos de trabalho dinâmicos. Embora o RAG se destaque ao extrair contexto factual de documentos estruturados ou não estruturados, ele muitas vezes tem dificuldade quando um agente de IA precisa internalizar, ao longo do tempo, padrões comportamentais complexos, fluxos de trabalho procedimentais ou a lógica sutil de uma organização. O aprendizado contínuo permite que os modelos internalizem essa lógica diretamente em seus parâmetros de peso.
Segundo, ele altera a equação econômica da manutenção de IA corporativa. O ajuste fino contínuo com métodos eficientes em parâmetros (como LoRA ou seus sucessores dinâmicos), combinado com salvaguardas de aprendizado contínuo, significa que as organizações podem manter modelos especializados e altamente precisos por uma fração do custo de execuções recorrentes de treinamento em escala total.
Boas Práticas para Implementar Modelos de IA em Evolução
Se a sua organização está explorando atualizações dinâmicas de modelos e estratégias de aprendizado contínuo, manter uma abordagem estruturada garante estabilidade, segurança e previsibilidade. Considere a seguinte lista de verificação de implementação:
- Estabeleça um Conjunto de Avaliação Rigoroso: Nunca implante atualizações contínuas sem um ambiente automatizado de testes de regressão. Compare o desempenho do seu modelo com um conjunto fixo de prompts históricos para detectar degradação ou esquecimento inesperados antes que as atualizações cheguem aos ambientes de produção.
- Isole os Módulos Específicos de Domínio: Separe o seu modelo de raciocínio base dos adaptadores de tarefas especializados. Atualizar camadas menores e modulares reduz drasticamente a superfície de exposição ao esquecimento catastrófico.
- Audite a Procedência dos Dados de Treinamento: Mantenha um controle de versão rigoroso sobre os conjuntos de dados usados nas atualizações incrementais. Se um modelo começar a apresentar comportamentos indesejáveis, você precisa rastrear o lote exato de dados recebidos responsável pela mudança.
- Combine com Guardrails: O aprendizado contínuo torna os modelos mais adaptáveis, mas não garante segurança por si só. Associe as atualizações dinâmicas de modelos a guardrails de saída em tempo real e a mecanismos de políticas determinísticos.
Olhando para o Futuro
A transição de implantações de LLMs estáticas e fortemente baseadas em lotes para arquiteturas fluidas, que aprendem continuamente, marca uma fase madura da inteligência artificial corporativa. À medida que esses frameworks avançados de memória e aprendizado contínuo saem dos laboratórios de pesquisa e chegam a kits de desenvolvimento de software de nível de produção, a era do modelo corporativo frágil e rapidamente desatualizado está chegando ao fim.
Para os líderes de tecnologia, manter-se à frente significa reconhecer que a estratégia de IA não se resume mais a qual modelo base você escolhe hoje, mas a com que eficiência a sua infraestrutura pode ajudar esse modelo a se adaptar, aprender e lembrar amanhã.