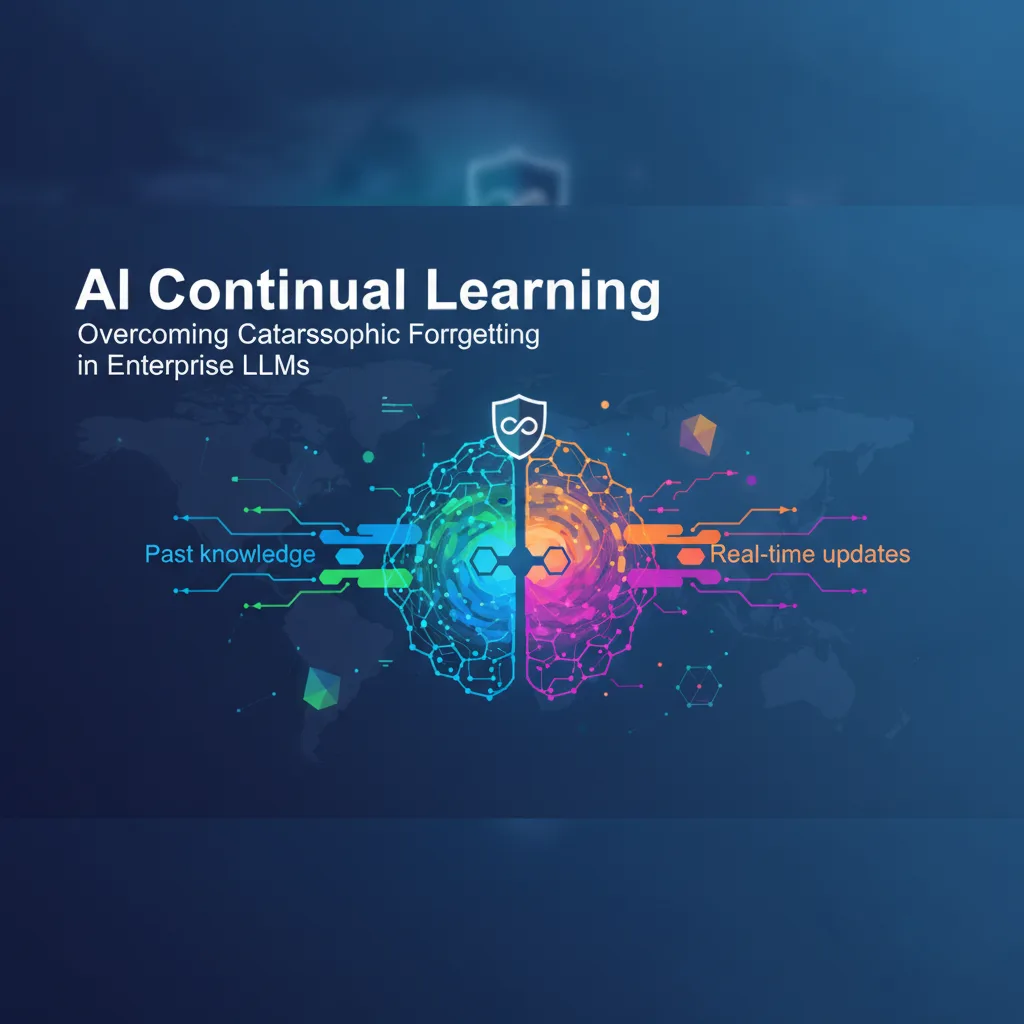
Son birkaç yıldır kurumsal bir büyük dil modelini (LLM) güncel tutmanın standart yöntemi iki kaba kuvvet yaklaşımına dayanıyordu: sıfırdan yapılan pahalı tam yeniden eğitimler ya da statik bir temel modelin üzerine eklenen sürekli Retrieval-Augmented Generation (RAG). RAG, yanıtları harici veritabanlarına dayandırmak için etkili bir köprü olmaya devam etse de modern sinir ağlarının temel mimari sınırlamasını çözmez: bir yapay zeka modeline tamamen yeni bir şey öğrettiğinizde, daha önce öğrendiklerinin üzerine yazma eğilimi gösterir. Feci unutma (catastrophic forgetting) olarak bilinen bu olgu, modern makine öğrenimi mühendisliğinin en inatçı darboğazlarından biridir.
Kuruluşlar, günlük iş değişikliklerine paralel olarak gelişmesi gereken otonom ajanları ve alana özel yardımcı pilotları devreye almaya çalıştıkça, feci unutmanın üstesinden gelmek akademik bir bilgisayar bilimi sorunundan acil bir kurumsal önceliğe dönüştü. Yapısal sürekli öğrenme çerçevelerindeki son atılımlar, mühendislerin bu soruna yaklaşımını değiştirmeye başlıyor ve bizi, sürekli ve maliyetli bir değişim gerektirmek yerine zaman içinde insan profesyoneller gibi gerçekten öğrenebilen modellere yaklaştırıyor.
Temel İkilem: Statik Modeller Dinamik Kurumsal Verilerle Neden Zorlanır?
Sürekli öğrenmenin neden bu kadar zor olduğunu anlamak için derin öğrenme modellerinin bilgiyi nasıl depoladığına bakmak gerekir. Mevcut kayıtları bozmadan bir tabloya temiz biçimde yeni bir satır eklenebilen geleneksel ilişkisel veritabanlarının aksine, bir LLM bilgiyi sinir mimarisi boyunca dağılmış milyarlarca kayan noktalı ağırlığa kodlar.
Önceden eğitilmiş bir modeli yeni verilerle (güncellenmiş iç uyumluluk politikaları, yeni yayımlanan ürün özellikleri veya değişen piyasa düzenlemeleri gibi) ince ayarladığınızda, optimizasyon algoritması yeni veri kümesindeki tahmin hatasını en aza indirmek için bu ağırlıkları ayarlar. Bunu yaparken ağırlıkları çoğu zaman eski görevler için gereken en uygun yapılandırmalardan uzaklaştırır. Model yeni uyumluluk kurallarında ustalaşabilir, ancak bir hafta önce bildiği temel operasyonel protokolleri aniden uydurmaya başlayabilir ya da tamamen unutabilir.
Geçmişte kuruluşlar bu sorunu, hem eski hem de yeni bilgileri içeren devasa tarihsel veri kümeleri derleyip modeli en baştan yeniden eğiterek aşmaya çalıştı. Bu yaklaşım yalnızca hesaplama açısından engelleyici ve çevreye yük getirici olmakla kalmaz, operasyonel olarak da yavaştır. Milyonlarca dolarlık bir eğitim süreci bittiğinde iş dünyası çoktan yeniden değişmiş olur.
Yeni Çözümler: Sürekli Öğrenmede Mimari Değişimler
Son araştırmalar ve çerçeve geliştirmeleri, tam yeniden eğitim döngülerine gerek kalmadan feci unutmayla mücadele etmenin gelişmiş yollarını sunuyor. Bu teknikler genel olarak üç ayrı yöntem kategorisine ayrılır:
- Düzenlileştirme Tabanlı Yaklaşımlar: Bu yöntemler, tek tek model ağırlıklarının daha önce öğrenilen görevler için önemini hesaplar. Yeni veriler eklendiğinde optimizasyon algoritması, geçmiş bilgi için en önemli olan ağırlıklardaki değişiklikleri cezalandırır ve uyum sağlamaya yalnızca daha az kritik parametre alanlarında izin verir.
- Modüler ve Bellek Destekli Mimariler: Yeni çerçeveler, tek parça bir ağırlık kümesini değiştirmek yerine dinamik alt ağlardan veya özel bellek tamponlarından yararlanır. Yeni bilgi, ayrılmış parametre modüllerine veya epizodik bellek depolarına yönlendirilir; çekirdek temel akıl yürütme motoruna dokunulmaz.
- Tekrar Tabanlı Çerçeveler: Özenle hazırlanmış sentetik verileri veya geçmiş eğitim derlemlerinin sıkıştırılmış temsillerini kullanan bu sistemler, ince ayar sırasında geçmiş veri örneklerini gelen gerçek zamanlı güncellemelerle iç içe geçirir ve sinir ağını geçmiş ile şimdiki bilgi arasında dengeli bir dağılımı korumaya yönlendirir.
Sürekli Öğrenmenin Geliştiriciler ve BT Liderleri İçin Anlamı
Mühendislik ekipleri ve BT karar vericileri için sağlam sürekli öğrenme çerçevelerine doğru yaşanan evrim; yazılım mimarisi, altyapı maliyetleri ve dağıtım stratejileri açısından önemli sonuçlar taşıyor.
Birincisi, dinamik iş akışlarında aşırı karmaşık RAG işlem hatlarına olan bağımlılığı azaltır. RAG, yapılandırılmış veya yapılandırılmamış belgelerden olgusal bağlam çekmede başarılı olsa da bir yapay zeka ajanının karmaşık davranış kalıplarını, prosedürel iş akışlarını veya kurumsal mantığın ince ayrıntılarını zaman içinde içselleştirmesi gerektiğinde çoğu zaman yetersiz kalır. Sürekli öğrenme, modellerin bu mantığı doğrudan ağırlık parametrelerine içselleştirmesine olanak tanır.
İkincisi, kurumsal yapay zeka bakımının ekonomik denklemini değiştirir. Parametre açısından verimli yöntemlerle (LoRA veya dinamik halefleri gibi) yapılan sürekli ince ayarın sürekli öğrenme güvenceleriyle birleştirilmesi, kuruluşların uzmanlaşmış ve son derece doğru modelleri, yinelenen tam ölçekli eğitim süreçlerinin maliyetinin çok küçük bir bölümüyle sürdürebilmesi anlamına gelir.
Gelişen Yapay Zeka Modellerini Uygulamak İçin En İyi Uygulamalar
Kuruluşunuz dinamik model güncellemelerini ve sürekli öğrenme stratejilerini inceliyorsa, yapılandırılmış bir yaklaşım sürdürmek istikrarı, güvenliği ve öngörülebilirliği sağlar. Aşağıdaki uygulama kontrol listesini göz önünde bulundurun:
- Titiz Bir Değerlendirme Paketi Oluşturun: Otomatik bir regresyon test ortamı olmadan sürekli güncellemeleri asla devreye almayın. Beklenmedik bozulmayı veya unutmayı güncellemeler üretim ortamına ulaşmadan yakalamak için modelinizi sabit bir geçmiş istem kümesine karşı ölçün.
- Alana Özel Modülleri Yalıtın: Temel akıl yürütme modelinizi özelleşmiş görev adaptörlerinden ayırın. Daha küçük, modüler katmanları güncellemek feci unutma için etki alanını önemli ölçüde daraltır.
- Eğitim Verisi Kaynağını Denetleyin: Artımlı güncellemelerde kullanılan veri kümeleri üzerinde sıkı sürüm kontrolü uygulayın. Bir model istenmeyen davranışlar sergilemeye başlarsa, değişimden sorumlu olan gelen veri grubunu tam olarak izleyebilmeniz gerekir.
- Güvenlik Bariyerleriyle Birleştirin: Sürekli öğrenme modelleri daha uyarlanabilir kılar, ancak kendiliğinden güvenliği garanti etmez. Dinamik model güncellemelerini gerçek zamanlı çıktı güvenlik bariyerleri ve deterministik politika motorlarıyla birlikte kullanın.
Geleceğe Bakış
Statik, yoğun toplu işlemeye dayalı LLM dağıtımlarından akışkan, sürekli öğrenen mimarilere geçiş, kurumsal yapay zekada olgun bir aşamaya işaret ediyor. Bu gelişmiş bellek ve sürekli öğrenme çerçeveleri araştırma laboratuvarlarından üretim düzeyindeki yazılım geliştirme kitlerine geçtikçe, kırılgan ve hızla eskiyen kurumsal modeller dönemi sona yaklaşıyor.
Teknoloji liderleri için öne geçmek, yapay zeka stratejisinin artık yalnızca bugün hangi temel modeli seçtiğinizle ilgili olmadığını, altyapınızın o modelin yarın ne kadar verimli uyum sağlamasına, öğrenmesine ve hatırlamasına yardımcı olabildiğiyle ilgili olduğunu kavramak anlamına gelir.