
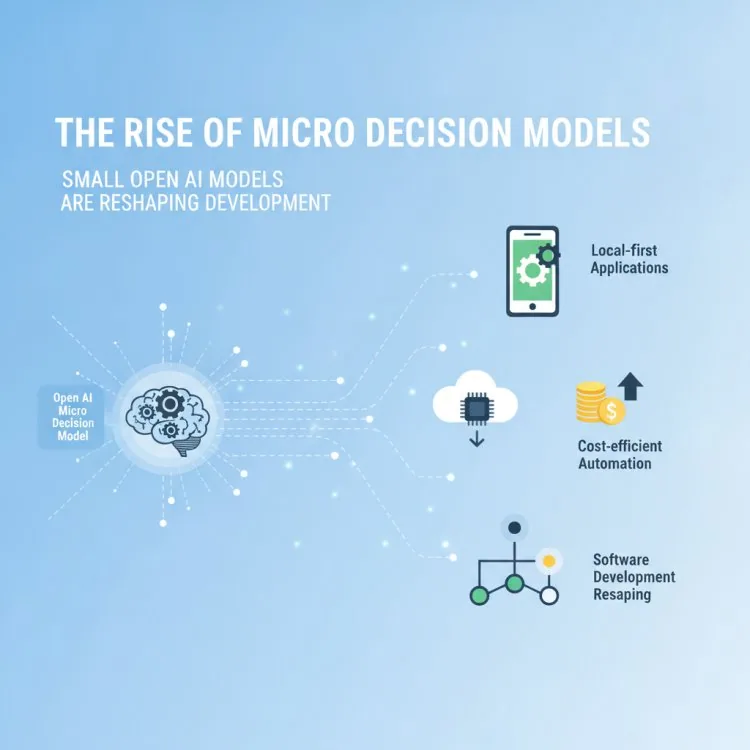
В последние годы в нарративе об искусственном интеллекте доминировал масштаб. Каждые несколько месяцев крупные лаборатории и сообщества открытого кода выпускали всё более крупные базовые модели с триллионами параметров, огромными контекстными окнами и поразительными требованиями к оборудованию. Хотя эти гиганты по-прежнему необходимы для сложных открытых рассуждений и глубокой творческой генерации, в технологическом ландшафте происходит тихая контрреволюция.
Разработчики, ИТ-руководители предприятий и системные архитекторы всё чаще обращают внимание на противоположный конец спектра: сверхмалые, узкоспециализированные ИИ-модели. Часто они находятся значительно ниже традиционных пороговых значений параметров — от языковых моделей с менее чем миллиардом параметров до компактных движков принятия решений с открытым исходным кодом — и эти микромодели доказывают, что больше не всегда лучше, когда нужно быстрое, детерминированное и экономичное выполнение.
Рассмотрим, что движет этим сдвигом к микромоделям принятия решений, почему они важны для современной программной архитектуры и как команды разработки могут интегрировать их в свои технологические стеки.
Что изменилось? Сдвиг к специализированному лёгкому ИИ
Внезапный рост популярности крошечных языковых моделей и микросистем принятия решений — это не просто экономия затрат; это фундаментальное взросление подхода к развёртыванию машинного обучения. Раньше попытка запустить локальную автоматизацию или периферийную маршрутизацию означала серьёзные компромиссы в интеллекте либо использование неуклюжего, хрупкого эвристического кода.
Сегодня сообщества открытого кода выпускают высокооптимизированные облегчённые архитектуры, которые работают заметно лучше, чем можно ожидать от их размера. Эти модели обучены или дообучены для конкретных задач — таких как логическая маршрутизация, текстовые эмбеддинги, простые деревья решений или извлечение метаданных, — а не пытаются быть универсальными. Поскольку им нужен минимальный объём памяти и они комфортно работают на стандартных процессорах или маломощных периферийных устройствах, они устраняют задержки и издержки облачной инфраструктуры, связанные с огромными API.
Кроме того, разработчики понимают, что для многих процессов программной инженерии слишком большая модель вносит лишнюю вариативность. Когда нужно, чтобы ИИ надёжно выбирал путь выполнения кода, разбирал структурированный JSON или фильтровал входящие потоки данных, небольшая узкоспециализированная модель принятия решений часто обеспечивает лучшую предсказуемость.
Почему микромодели принятия решений важны для бизнеса и разработчиков
Перенос нагрузок с огромных облачных LLM на локализованные или облегчённые микромодели даёт современным технологическим командам несколько явных преимуществ:
- Радикально меньшая задержка: исключая сетевые обращения к удалённым облачным конечным точкам и сокращая время вывода, микромодели обеспечивают отклик в реальном времени, необходимый для интерактивных инструментов, IoT-устройств и динамичных сред разработки.
- Резкое снижение затрат: запуск непрерывных циклов автоматизации или обработка больших объёмов фоновых задач на огромных моделях быстро истощает облачные бюджеты. Микромодели часто можно размещать локально или запускать на недорогой бессерверной инфраструктуре за малую долю стоимости.
- Повышенная конфиденциальность и безопасность данных: локальная обработка конфиденциальной телеметрии, внутренних кодовых баз или данных клиентов без отправки сторонним поставщикам API снижает проблемы с соответствием требованиям и риски утечки данных.
- Детерминированный контроль: меньшие модели легче ограничивать, настраивать промптами и дообучать под строгие форматы вывода, что снижает досадные галлюцинации, свойственные более крупным универсальным моделям.
Ключевые стратегии интеграции для команд разработки
Внедрение микромоделей принятия решений требует смены инженерного мышления. Вместо того чтобы считать ИИ всезнающим оракулом, разработчикам следует рассматривать малые модели как интеллектуальные микросервисы или специализированные компоненты в рамках более крупной структурированной системы. Вот четыре лучшие практики для их эффективного внедрения:
- Проверьте свои нагрузки на узкие задачи: найдите области в приложении, где тяжёлые модели используются недостаточно — например, классификация намерений, маршрутизация данных между агентами или лёгкое форматирование, — и сравните их с более компактными альтернативами.
- Внедряйте локальные и периферийные развёртывания: проверьте, как модели с менее чем миллиардом параметров работают прямо на локальных машинах разработчиков, периферийных серверах или клиентском оборудовании, чтобы сократить зависимость от внешних API.
- Сочетайте с традиционной логикой: не полагайтесь полностью на ИИ для жёсткой бизнес-логики. Используйте микромодели для неоднозначной классификации или понимания языка, а пути выполнения доверьте детерминированному коду.
- Отдавайте приоритет экосистемам с открытым исходным кодом: используйте прозрачные веса моделей, разрабатываемые сообществом, которые позволяют проверять, дообучать и размещать модели у себя без привязки к экосистеме или ценовой модели закрытого поставщика.
Будущее облегчённого машинного обучения
Взросление небольших ИИ-моделей с открытым исходным кодом свидетельствует о здоровой стабилизации рынка искусственного интеллекта. По мере того как отрасль выходит за пределы начальной фазы простого наращивания параметров, фокус смещается на эффективность, доступность и практическую пользу. Используя микромодели принятия решений, инженерные команды могут создавать более быстрые, дешёвые и конфиденциальные функции на основе ИИ, которые бесшовно интегрируются в существующие программные архитектуры.
Проектируете ли вы периферийную инфраструктуру, оптимизируете корпоративные облачные конвейеры или создаёте инструменты для разработчиков, включение облегчённых моделей в ваш набор инструментов — уже не просто эксперимент, а конкурентное преимущество.
More about micro decision models
Want to go further with micro decision models? These Netstech guides and services are a good next step:


