
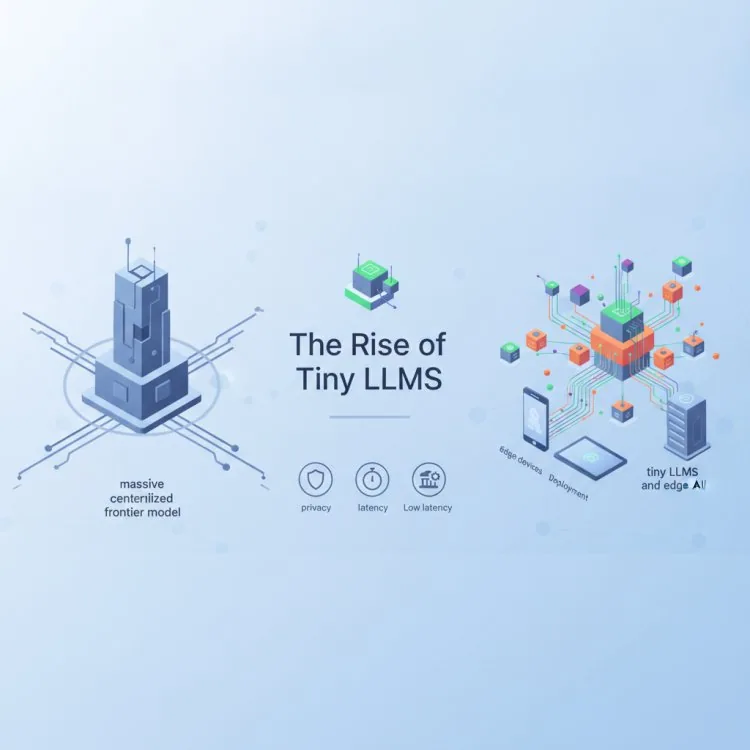
В последние несколько лет ландшафт искусственного интеллекта определялся неутомимой гонкой вверх. Технологические гиганты и элитные лаборатории вкладывали миллиарды долларов в обучение всё более крупных передовых моделей с триллионами параметров, огромными требованиями к облачным кластерам и возможностями, постоянно раздвигавшими границы генерации естественного языка. Нам говорили, что больше — всегда лучше.
Тем не менее в сообществе ИИ сейчас происходит тихая контрреволюция. Разработчики, исследователи и ИТ-руководители всё чаще отворачиваются от огромных облачных API и обращаются к принципиально иной парадигме: крошечным LLM и нативному периферийному искусственному интеллекту. Благодаря прорывам в квантизации, дистилляции и специализированных архитектурах моделей модели с менее чем миллиардом параметров доказывают, что способны решать сложные задачи локально, часто за считаные миллисекунды и полностью на потребительском оборудовании или прямо в веб-браузере.
Этот сдвиг — не просто новизна или демонстрация технических возможностей. Это фундаментальный пересмотр того, как бизнес и разработчики внедряют машинное обучение в реальном мире, отдавая приоритет экономической эффективности, низкой задержке и суверенитету данных перед грубой силой масштаба.
Что изменилось? Переход к эффективности
Переход от монолитных облачных моделей к микроязыковым моделям был ускорен несколькими сходящимися техническими тенденциями:
- Продвинутая дистилляция знаний: исследователи достигли исключительных успехов в обучении небольших «студенческих» моделей имитировать паттерны рассуждений и результаты огромных «учительских» моделей, сохраняя удивительно высокий процент производительности при многократно меньшем размере.
- Агрессивная квантизация: методы, снижающие точность весов модели (например, до 4-битных или ещё более низких форматов), позволяют моделям с менее чем миллиардом параметров плавно работать на обычных CPU, локальных микроконтроллерах и мобильных устройствах без дорогих выделенных GPU.
- Растущие требования к задержке: для приложений реального времени — от автономных агентов и робототехники до отзывчивых пользовательских интерфейсов — сетевой вызов удалённого облачного API создаёт неприемлемую задержку. Локальное выполнение полностью устраняет сетевые узкие места.
- Усиление требований к конфиденциальности и регулированию: предприятия всё неохотнее отправляют проприетарный код, финансовые записи или чувствительные персональные данные на сторонние облачные серверы. Периферийный ИИ гарантирует, что данные никогда не покидают локальное устройство или защищённый корпоративный периметр.
Почему микромодели важны для разработчиков и ИТ-руководителей
Для ИТ-руководителей и инженеров-программистов зрелость крошечных LLM открывает совершенно новые архитектурные возможности. Вместо того чтобы направлять каждую простую задачу классификации текста, форматирования или принятия решений через дорогой облачный эндпоинт с ограничением частоты запросов, системы теперь могут встраивать интеллект непосредственно в прикладной уровень.
Рассмотрим последствия для локальной автоматизации и агентов принятия решений. Когда ИИ-агенту нужно оценить условный шаг или разобрать входящие данные телеметрии, выполнение этого локально за 30 миллисекунд — вместо ожидания ответа от облака в течение 800 миллисекунд — превращает медленный процесс в плавный, сверхотзывчивый. Более того, поскольку такие модели можно обучать, дообучать или запускать локально, организации возвращают себе полный контроль над своими программными стеками.
Команды безопасности и комплаенса также получают огромную выгоду. Когда ИИ работает на устройстве, соблюдение строгих норм защиты данных, таких как GDPR или HIPAA, становится значительно проще, так как поверхность потенциальных утечек данных или несанкционированного стороннего логирования резко сокращается.
Практический чек-лист: оценка крошечных LLM для вашего следующего проекта
Если вы рассматриваете возможность включить модели с менее чем миллиардом параметров или периферийные модели в архитектуру вашего будущего ПО, воспользуйтесь этим практическим чек-листом для оценки:
- Определите область применения: убедитесь, что от модели требуется выполнять ограниченную задачу (например, извлечение сущностей, маршрутизацию, проверку синтаксиса или локализованную классификацию), а не открытые творческие рассуждения.
- Проведите бенчмарк задержки и потребления ресурсов: протестируйте модель в реалистичных аппаратных ограничениях, включая среды только с CPU и мобильные или периферийные устройства с ограниченной памятью, чтобы измерить точное время выполнения и потребление RAM.
- Оцените влияние квантизации: сравните точность версий с полной точностью и квантизованных форматов (таких как варианты GGUF или ONNX), чтобы найти оптимальный баланс между производительностью и размером файла.
- Проверьте лицензии и происхождение: изучите обучающие данные и условия лицензирования с открытым исходным кодом любой микромодели, которую вы планируете использовать в коммерческих целях, чтобы обеспечить соответствие требованиям и избежать юридических рисков.
- Предусмотрите резервные механизмы: проектируйте архитектуру приложения так, чтобы при низкой уверенности крошечной модели оно плавно переключалось на более крупную облачную модель или очередь проверки человеком.
Взгляд в будущее: распределённое будущее ИИ
Будущее искусственного интеллекта будет определяться не только тем, кто владеет крупнейшим дата-центром или самым дорогим кластером GPU. По мере того как микромодели продолжают улучшать способности к рассуждению и эффективность, граница инноваций расширяется к периферии.
Для компаний и разработчиков, готовых заглянуть за шумиху вокруг огромных облачных LLM, периферийный ИИ открывает убедительный путь вперёд: более быстрые приложения, более надёжная защита данных, резко сниженные операционные расходы и настоящая независимость от централизованной инфраструктуры. Интеллектуальная революция уменьшается в масштабе, и во многих случаях меньшее оказывается удивительно лучшим.
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:


