
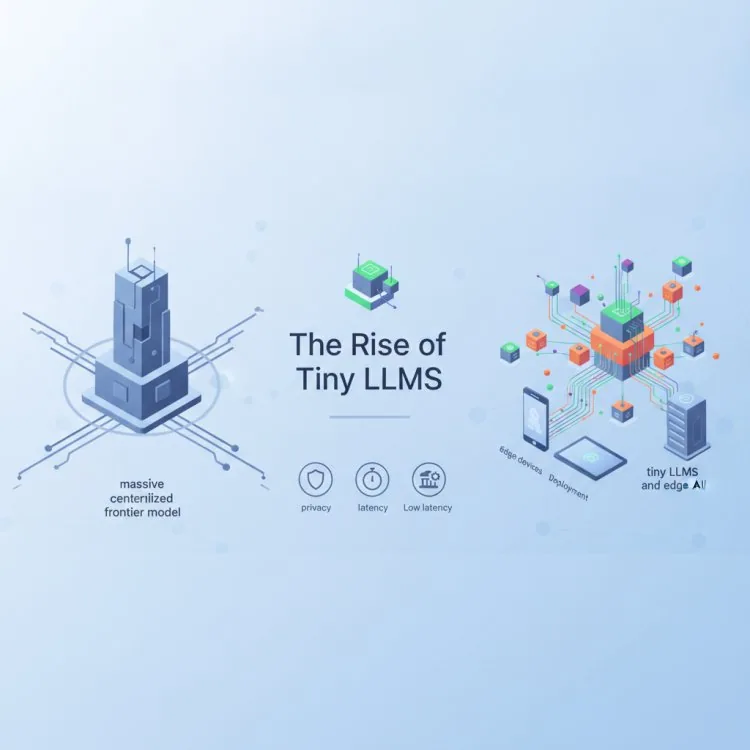
Son birkaç yıldır yapay zekâ dünyasına yukarı doğru acımasız bir yarış hâkim oldu. Teknoloji devleri ve seçkin laboratuvarlar, trilyonlarca parametreyle, devasa bulut küme gereksinimleriyle ve doğal dil üretiminin sınırlarını sürekli zorlayan yeteneklerle övünen, giderek büyüyen sınır modelleri eğitmek için milyarlarca dolar harcadı. Bize daha büyüğün her zaman daha iyi olduğu söylendi.
Ancak yapay zekâ topluluğunda şu anda sessiz bir karşı devrim sürüyor. Geliştiriciler, araştırmacılar ve BT karar vericileri dikkatlerini giderek devasa buluta bağlı API'lerden uzaklaştırıp temelden farklı bir paradigmaya, yani küçük LLM'lere ve uca özgü yapay zekâya çeviriyor. Nicemleme, damıtma ve özel model mimarilerindeki atılımlarla desteklenen milyar altı parametreli modeller, sofistike görevleri çoğu zaman yalnızca milisaniyeler içinde ve tamamen tüketici sınıfı donanımda ya da doğrudan bir web tarayıcısının içinde yerel olarak yürütebildiklerini kanıtlıyor.
Bu değişim yalnızca yenilik veya teknik gösteriş meselesi değil. İşletmelerin ve geliştiricilerin makine öğrenimini gerçek dünyada nasıl devreye aldığının, ham ve kaba kuvvete dayalı ölçek yerine maliyet verimliliğine, düşük gecikmeye ve veri egemenliğine öncelik veren temel bir yeniden değerlendirmesini temsil ediyor.
Ne Değişti? Verimliliğe Doğru Kayış
Monolitik bulut modellerinden mikro dil modellerine geçişi birbirine yakınsayan çeşitli teknik eğilimler hızlandırdı:
- Gelişmiş Bilgi Damıtma: Araştırmacılar, daha küçük "öğrenci" modelleri devasa "öğretmen" modellerin akıl yürütme kalıplarını ve çıktılarını taklit edecek şekilde eğitmekte olağanüstü başarılı hâle geldi; boyutun çok küçük bir kısmıyla şaşırtıcı bir performans yüzdesini koruyor.
- Agresif Nicemleme: Model ağırlıklarının hassasiyetini düşüren teknikler (4 bit veya daha düşük biçimlere indirme gibi), bir milyar parametre altındaki modellerin pahalı özel GPU'lara gerek kalmadan standart CPU'larda, yerel mikrodenetleyicilerde ve mobil cihazlarda akıcı çalışmasını sağlar.
- Artan Gecikme Talepleri: Otonom ajanlardan robotiğe ve duyarlı kullanıcı arayüzlerine kadar gerçek zamanlı uygulamalarda, uzak bir bulut API'sine yapılan gidiş-dönüş ağ çağrısı kabul edilemez gecikme getirir. Yerel yürütme ağ darboğazlarını tamamen ortadan kaldırır.
- Yoğunlaşan Gizlilik ve Düzenleyici Baskılar: Kuruluşlar, tescilli kodu, mali kayıtları veya hassas kişisel verileri üçüncü taraf bulut sunucularına göndermekte giderek daha fazla tereddüt ediyor. Uç yapay zekâ, verinin yerel cihazdan veya güvenli kurumsal çevreden asla çıkmamasını garanti eder.
Mikro Modeller Geliştiriciler ve BT Liderleri İçin Neden Önemli
BT karar vericileri ve yazılım mühendisleri için küçük LLM'lerin olgunlaşması tamamen yeni mimari olasılıkların kapısını açıyor. Her basit metin sınıflandırma, biçimlendirme veya karar verme görevini pahalı, hız sınırlı bir bulut uç noktasından geçirmek yerine, sistemler artık zekâyı doğrudan uygulama katmanına gömebilir.
Yerel otomasyon ve karar ajanları için sonuçları düşünün. Bir yapay zekâ ajanının koşullu bir adımı değerlendirmesi veya gelen telemetri verilerini ayrıştırması gerektiğinde, bunu bulut yanıtı için 800 milisaniye beklemek yerine yerel olarak 30 milisaniye içinde yapmak, ağır bir iş akışını kesintisiz, son derece duyarlı bir deneyime dönüştürür. Dahası, bu modeller yerel olarak eğitilebildiği, ince ayar yapılabildiği veya çalıştırılabildiği için kuruluşlar yazılım yığınları üzerindeki tam kontrolü geri kazanır.
Güvenlik ve uyumluluk ekipleri de büyük fayda sağlayacak. Yapay zekâ cihaz üzerinde çalıştığında, olası veri sızıntılarının veya yetkisiz üçüncü taraf kayıtlarının yüzey alanı büyük ölçüde azaldığı için GDPR veya HIPAA gibi katı veri koruma çerçevelerine uyum belirgin biçimde kolaylaşır.
Pratik Kontrol Listesi: Bir Sonraki Projeniz İçin Küçük LLM'leri Değerlendirme
Yaklaşan yazılım mimarinize milyar altı parametreli veya uç modelleri dahil etmeyi düşünüyorsanız, değerlendirme sürecinize yol göstermesi için bu pratik kontrol listesini kullanın:
- Kapsamı Tanımlayın: Modelden açık uçlu yaratıcı akıl yürütme yerine sınırlı bir görevi (varlık çıkarımı, yönlendirme, söz dizimi denetimi veya yerelleştirilmiş sınıflandırma gibi) yerine getirmesinin istendiğinden emin olun.
- Gecikmeyi ve Ayak İzini Kıyaslayın: Kesin yürütme süresini ve RAM tüketimini ölçmek için modeli gerçekçi donanım kısıtları altında (yalnızca CPU ortamları ve belleği kısıtlı mobil veya uç cihazlar dahil) test edin.
- Nicemlemenin Etkisini Değerlendirin: Performans ile dosya boyutu arasındaki en uygun dengeyi bulmak için tam hassasiyetli sürümlerin doğruluğunu nicemlenmiş biçimlerle (GGUF veya ONNX varyantları gibi) karşılaştırın.
- Lisansı ve Kaynağı Doğrulayın: Uyumluluğu sağlamak ve sonraki hukuki risklerden kaçınmak için ticari olarak devreye almayı planladığınız her mikro modelin eğitim verilerini ve açık kaynak lisans koşullarını kontrol edin.
- Yedekleme Mekanizmaları Oluşturun: Küçük model düşük güvenli senaryolarla karşılaştığında, uygulama mimarinizi daha büyük bir bulut modeline veya insan inceleme kuyruğuna sorunsuzca geri dönecek şekilde tasarlayın.
İleriye Bakış: Yapay Zekânın Dağıtık Geleceği
Yapay zekânın geleceğini yalnızca en büyük veri merkezine veya en pahalı GPU kümesine kimin sahip olduğu belirlemeyecek. Mikro modeller akıl yürütme yeteneği ve verimlilik açısından gelişmeye devam ettikçe, inovasyonun sınırı dışa, uca doğru genişliyor.
Devasa bulut tabanlı LLM'lerin abartısının ötesine bakmaya istekli işletmeler ve geliştiriciler için uç yapay zekâyı benimsemek ikna edici bir yol sunar: daha hızlı uygulamalar, daha sıkı veri güvenliği, büyük ölçüde azalan operasyonel maliyetler ve merkezi altyapıdan gerçek bağımsızlık. Zekâ devrimi küçülüyor ve birçok durumda küçük olan olağanüstü ölçüde daha iyi çıkıyor.
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:


