
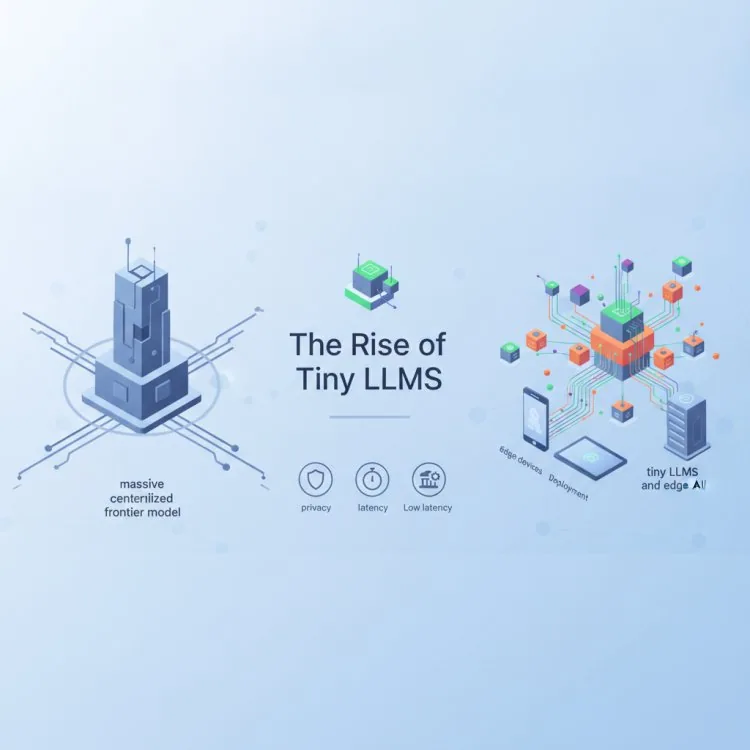
Ces dernières années, le paysage de l'intelligence artificielle a été dominé par une course incessante vers le haut. Les géants de la tech et les laboratoires d'élite ont investi des milliards de dollars dans l'entraînement de modèles de pointe toujours plus grands, vantant des milliers de milliards de paramètres, d'énormes besoins en clusters cloud et des capacités repoussant sans cesse les limites de la génération de langage naturel. Plus grand, nous disait-on, était toujours mieux.
Pourtant, une discrète contre-révolution est en cours dans la communauté de l'IA. Les développeurs, les chercheurs et les décideurs informatiques se détournent de plus en plus des API massives liées au cloud pour se tourner vers un paradigme fondamentalement différent : les petits LLM et l'intelligence artificielle native de la périphérie. Portés par des avancées en quantification, en distillation et en architectures de modèles spécialisées, les modèles de moins d'un milliard de paramètres se montrent capables de gérer localement des tâches sophistiquées, souvent en quelques millisecondes et entièrement sur du matériel grand public ou directement dans un navigateur web.
Ce changement ne relève pas de la simple nouveauté ni de la démonstration technique. Il représente une réévaluation fondamentale de la manière dont les entreprises et les développeurs déploient l'apprentissage automatique dans le monde réel, en privilégiant l'efficacité des coûts, la faible latence et la souveraineté des données plutôt que l'échelle brute obtenue par la force.
Qu'est-ce qui a changé ? Le virage vers l'efficacité
Le passage des modèles cloud monolithiques aux micro-modèles de langage a été catalysé par plusieurs tendances techniques convergentes :
- Distillation de connaissances avancée : les chercheurs sont devenus exceptionnellement doués pour entraîner de plus petits modèles « élèves » à imiter les schémas de raisonnement et les résultats de modèles « enseignants » massifs, en conservant un pourcentage étonnant de performance pour une fraction de la taille.
- Quantification agressive : les techniques qui réduisent la précision des poids du modèle (par exemple jusqu'à 4 bits ou des formats encore plus faibles) permettent à des modèles de moins d'un milliard de paramètres de s'exécuter de façon fluide sur des CPU standard, des microcontrôleurs locaux et des appareils mobiles, sans exiger de GPU dédiés coûteux.
- Exigences de latence croissantes : pour les applications en temps réel, des agents autonomes et de la robotique aux interfaces utilisateur réactives, un appel réseau aller-retour vers une API cloud distante introduit une latence inacceptable. L'exécution locale supprime entièrement les goulots d'étranglement du réseau.
- Pressions croissantes en matière de confidentialité et de réglementation : les entreprises hésitent de plus en plus à envoyer du code propriétaire, des dossiers financiers ou des données personnelles sensibles vers des serveurs cloud tiers. L'IA en périphérie garantit que les données ne quittent jamais l'appareil local ni le périmètre sécurisé de l'entreprise.
Pourquoi les micro-modèles comptent pour les développeurs et les responsables informatiques
Pour les décideurs informatiques et les ingénieurs logiciels, la maturation des petits LLM ouvre des possibilités architecturales entièrement nouvelles. Au lieu d'acheminer chaque tâche simple de classification de texte, de mise en forme ou de prise de décision via un point de terminaison cloud coûteux et limité en débit, les systèmes peuvent désormais intégrer l'intelligence directement dans la couche applicative.
Pensez aux implications pour l'automatisation locale et les agents de décision. Lorsqu'un agent d'IA doit évaluer une étape conditionnelle ou analyser des données de télémétrie entrantes, le faire localement en 30 millisecondes, plutôt que d'attendre 800 millisecondes une réponse du cloud, transforme un flux de travail poussif en une expérience fluide et ultra-réactive. De plus, comme ces modèles peuvent être entraînés, affinés ou exécutés localement, les organisations reprennent le contrôle total de leurs piles logicielles.
Les équipes de sécurité et de conformité ont également énormément à y gagner. Lorsque l'IA s'exécute sur l'appareil, la conformité à des cadres stricts de protection des données comme le RGPD ou HIPAA devient nettement plus simple, car la surface de fuites de données potentielles ou de journalisation non autorisée par des tiers est considérablement réduite.
Liste de contrôle pratique : évaluer les petits LLM pour votre prochain projet
Si vous envisagez d'intégrer des modèles de moins d'un milliard de paramètres ou des modèles de périphérie à votre future architecture logicielle, utilisez cette liste de contrôle pratique pour guider votre évaluation :
- Définissez le périmètre : assurez-vous que l'on demande au modèle d'exécuter une tâche bornée (comme l'extraction d'entités, le routage, la vérification de syntaxe ou la classification localisée) plutôt qu'un raisonnement créatif ouvert.
- Mesurez la latence et l'empreinte : testez le modèle dans des contraintes matérielles réalistes, y compris des environnements CPU uniquement et des appareils mobiles ou périphériques à mémoire limitée, afin de mesurer précisément le temps d'exécution et la consommation de RAM.
- Évaluez l'impact de la quantification : comparez la précision des versions en pleine précision à celle des formats quantifiés (comme les variantes GGUF ou ONNX) afin de trouver l'équilibre optimal entre performance et taille de fichier.
- Vérifiez les licences et la provenance : examinez les données d'entraînement et les conditions de licence open source de tout micro-modèle que vous prévoyez de déployer commercialement afin de garantir la conformité et d'éviter des risques juridiques en aval.
- Prévoyez des mécanismes de repli : concevez l'architecture de votre application pour basculer en douceur vers un modèle cloud plus grand ou une file de révision humaine lorsque le petit modèle rencontre des scénarios à faible niveau de confiance.
Perspectives : l'avenir distribué de l'IA
L'avenir de l'intelligence artificielle ne sera pas dicté uniquement par celui qui possède le plus grand centre de données ou le cluster de GPU le plus coûteux. À mesure que les micro-modèles continuent d'améliorer leur capacité de raisonnement et leur efficacité, la frontière de l'innovation s'étend vers la périphérie.
Pour les entreprises et les développeurs prêts à regarder au-delà du battage autour des LLM massifs hébergés dans le cloud, adopter l'IA en périphérie offre une voie prometteuse : des applications plus rapides, une sécurité des données renforcée, des coûts d'exploitation considérablement réduits et une véritable indépendance vis-à-vis de l'infrastructure centralisée. La révolution de l'intelligence se miniaturise, et dans bien des cas, plus petit s'avère remarquablement meilleur.
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:
- L’essor des micro-modèles de décision : pourquoi les petits modèles d’IA ouverts transforment le développement
- Matériel open source et micro-automatisation : au-delà du battage de l’IoT en périphérie
- L’essor des applications mobiles compilées : performances et évolutions de l’écosystème
- AI services and automation


