
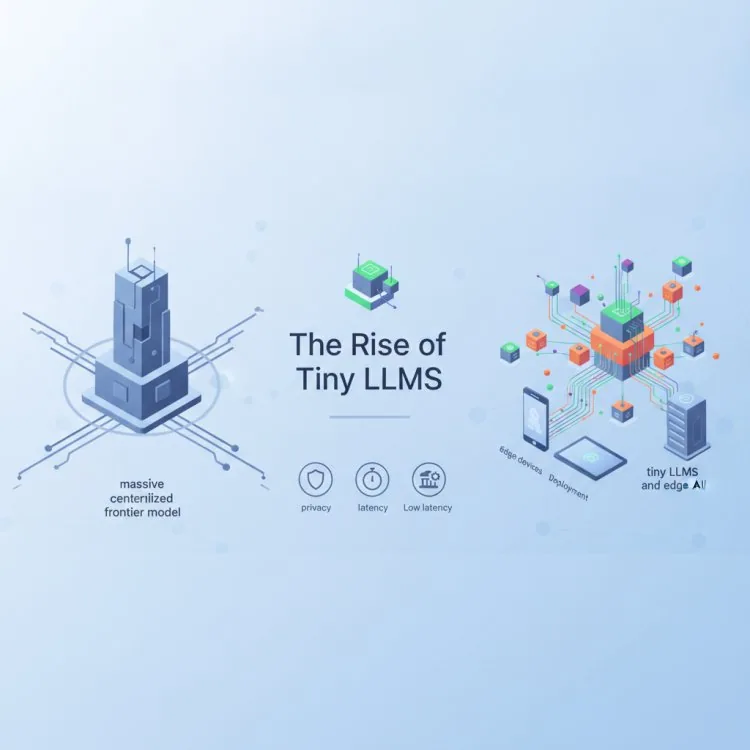
Selama beberapa tahun terakhir, lanskap kecerdasan buatan didominasi oleh perlombaan ke atas yang tak kenal henti. Raksasa teknologi dan laboratorium elit menggelontorkan miliaran dolar untuk melatih model frontier yang kian besar, dengan triliunan parameter, kebutuhan klaster cloud yang masif, dan kemampuan yang terus mendorong batas pembuatan bahasa alami. Kita diberi tahu bahwa lebih besar selalu lebih baik.
Namun, sebuah kontra-revolusi yang tenang kini sedang berlangsung di komunitas AI. Developer, peneliti, dan pengambil keputusan IT semakin mengalihkan perhatian dari API masif yang terikat cloud menuju paradigma yang sangat berbeda: tiny LLM dan kecerdasan buatan edge-native. Didorong oleh terobosan dalam kuantisasi, distilasi, dan arsitektur model khusus, model berparameter di bawah satu miliar terbukti mampu menangani tugas-tugas canggih secara lokal, sering kali hanya dalam hitungan milidetik dan sepenuhnya pada perangkat keras kelas konsumen atau langsung di dalam browser web.
Pergeseran ini bukan sekadar soal kebaruan atau pamer teknis. Ini mewakili evaluasi ulang mendasar tentang bagaimana bisnis dan developer menerapkan machine learning di dunia nyata, dengan mengutamakan efisiensi biaya, latensi rendah, dan kedaulatan data di atas skala mentah yang mengandalkan kekuatan kasar.
Apa yang Berubah? Pergeseran Menuju Efisiensi
Peralihan dari model cloud monolitik ke model bahasa mikro dipicu oleh beberapa tren teknis yang saling bertemu:
- Distilasi Pengetahuan Tingkat Lanjut: Para peneliti sangat mahir melatih model "murid" yang lebih kecil untuk meniru pola penalaran dan keluaran model "guru" yang masif, dengan mempertahankan persentase kinerja yang mengejutkan pada sebagian kecil ukurannya.
- Kuantisasi Agresif: Teknik yang menurunkan presisi bobot model (seperti hingga 4-bit atau format yang lebih rendah) memungkinkan model di bawah satu miliar parameter berjalan lancar di CPU standar, mikrokontroler lokal, dan perangkat seluler tanpa memerlukan GPU khusus yang mahal.
- Tuntutan Latensi yang Meningkat: Untuk aplikasi real-time—mulai dari agen otonom dan robotika hingga antarmuka pengguna yang responsif—panggilan jaringan pulang-pergi ke API cloud jarak jauh menimbulkan latensi yang tidak dapat diterima. Eksekusi lokal menghilangkan hambatan jaringan sepenuhnya.
- Tekanan Privasi dan Regulasi yang Semakin Kuat: Perusahaan semakin enggan mengirim kode proprietary, catatan keuangan, atau data pribadi sensitif ke server cloud pihak ketiga. AI edge menjamin data tidak pernah meninggalkan perangkat lokal atau perimeter perusahaan yang aman.
Mengapa Model Mikro Penting bagi Developer dan Pemimpin IT
Bagi pengambil keputusan IT dan software engineer, kematangan tiny LLM membuka kemungkinan arsitektur yang sepenuhnya baru. Alih-alih mengarahkan setiap tugas klasifikasi teks sederhana, pemformatan, atau pengambilan keputusan melalui endpoint cloud yang mahal dan dibatasi laju, sistem kini dapat menanamkan kecerdasan langsung ke lapisan aplikasi.
Pertimbangkan implikasinya bagi otomasi lokal dan agen keputusan. Ketika agen AI perlu mengevaluasi langkah bersyarat atau mengurai data telemetri masuk, melakukannya secara lokal dalam 30 milidetik—alih-alih menunggu 800 milidetik respons cloud—mengubah alur kerja yang lamban menjadi pengalaman yang mulus dan sangat responsif. Selain itu, karena model ini dapat dilatih, di-fine-tune, atau dijalankan secara lokal, organisasi mendapatkan kembali kendali penuh atas stack perangkat lunak mereka.
Tim keamanan dan kepatuhan juga akan sangat diuntungkan. Ketika AI berjalan di perangkat, kepatuhan terhadap kerangka perlindungan data yang ketat seperti GDPR atau HIPAA menjadi jauh lebih mudah, karena permukaan potensi kebocoran data atau pencatatan pihak ketiga tanpa izin berkurang drastis.
Daftar Periksa Praktis: Mengevaluasi Tiny LLM untuk Proyek Anda Berikutnya
Jika Anda mempertimbangkan untuk memasukkan model berparameter di bawah satu miliar atau model edge ke arsitektur perangkat lunak Anda mendatang, gunakan daftar periksa praktis ini sebagai panduan proses evaluasi Anda:
- Tentukan Cakupan: Pastikan model diminta menjalankan tugas yang terbatas (seperti ekstraksi entitas, routing, pemeriksaan sintaks, atau klasifikasi terlokalisasi), bukan penalaran kreatif terbuka.
- Benchmark Latensi dan Jejak Sumber Daya: Uji model di bawah batasan perangkat keras yang realistis—termasuk lingkungan hanya-CPU dan perangkat seluler atau edge dengan memori terbatas—untuk mengukur waktu eksekusi dan konsumsi RAM secara tepat.
- Nilai Dampak Kuantisasi: Bandingkan akurasi versi presisi penuh dengan format terkuantisasi (seperti varian GGUF atau ONNX) untuk menemukan keseimbangan optimal antara kinerja dan ukuran file.
- Verifikasi Lisensi dan Asal-Usul: Periksa data pelatihan dan ketentuan lisensi open-source dari setiap model mikro yang Anda rencanakan untuk di-deploy secara komersial guna memastikan kepatuhan dan menghindari risiko hukum di kemudian hari.
- Siapkan Mekanisme Fallback: Rancang arsitektur aplikasi Anda agar dapat beralih dengan mulus ke model cloud yang lebih besar atau antrean tinjauan manusia ketika model kecil menemui skenario dengan tingkat keyakinan rendah.
Menatap ke Depan: Masa Depan AI yang Terdistribusi
Masa depan kecerdasan buatan tidak akan ditentukan semata-mata oleh siapa yang memiliki pusat data terbesar atau klaster GPU termahal. Seiring model mikro terus meningkat dalam kemampuan penalaran dan efisiensi, garda depan inovasi meluas ke arah edge.
Bagi bisnis dan developer yang bersedia melihat melampaui hype LLM berbasis cloud yang masif, merangkul AI edge menawarkan jalan ke depan yang menarik: aplikasi lebih cepat, keamanan data lebih ketat, biaya operasional jauh lebih rendah, dan kemandirian sejati dari infrastruktur terpusat. Revolusi kecerdasan sedang mengecil skalanya, dan dalam banyak kasus, yang lebih kecil ternyata jauh lebih baik.
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:


