
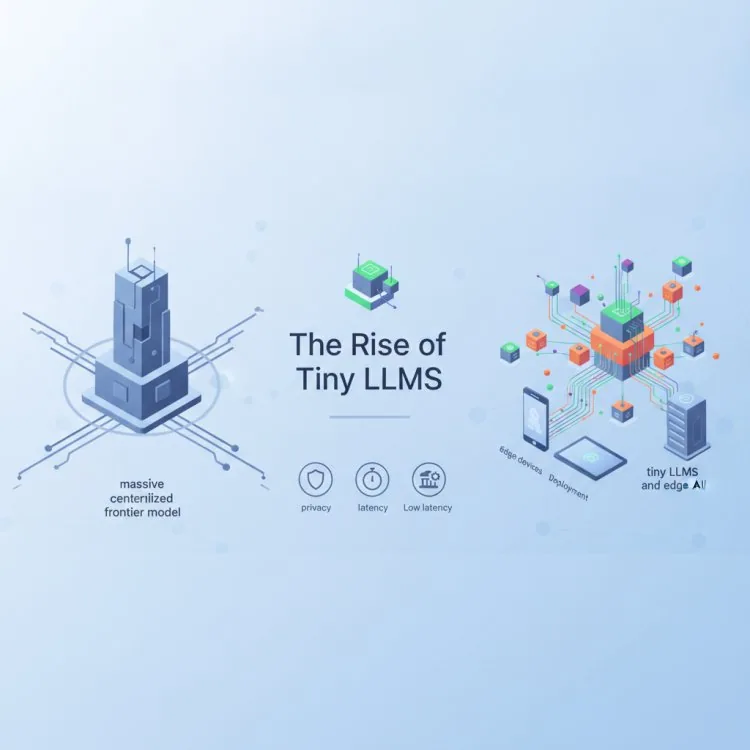
In den vergangenen Jahren wurde die KI-Landschaft von einem unerbittlichen Wettlauf nach oben geprägt. Tech-Giganten und Elite-Labore steckten Milliarden von Dollar in das Training immer größerer Frontier-Modelle mit Billionen von Parametern, enormem Cloud-Cluster-Bedarf und Fähigkeiten, die die Grenzen der natürlichen Sprachgenerierung immer weiter verschoben. Größer, so hieß es, sei immer besser.
Doch in der KI-Community vollzieht sich derzeit eine stille Gegenrevolution. Entwickler, Forscher und IT-Entscheider wenden sich zunehmend von riesigen, cloudgebundenen APIs ab und einem grundlegend anderen Paradigma zu: Tiny LLMs und Edge-native künstliche Intelligenz. Dank Durchbrüchen bei Quantisierung, Destillation und spezialisierten Modellarchitekturen erweisen sich Modelle mit weniger als einer Milliarde Parametern als fähig, anspruchsvolle Aufgaben lokal zu bewältigen, oft in wenigen Millisekunden und vollständig auf Verbraucherhardware oder direkt im Webbrowser.
Bei diesem Wandel geht es nicht bloß um Neuheit oder technisches Imponiergehabe. Er stellt eine grundlegende Neubewertung dar, wie Unternehmen und Entwickler maschinelles Lernen in der Praxis einsetzen, und priorisiert Kosteneffizienz, geringe Latenz und Datensouveränität gegenüber roher Brute-Force-Skalierung.
Was hat sich geändert? Der Wandel hin zur Effizienz
Der Wechsel von monolithischen Cloud-Modellen zu Mikro-Sprachmodellen wurde durch mehrere zusammenlaufende technische Trends angestoßen:
- Fortgeschrittene Wissensdestillation: Forscher sind außerordentlich gut darin geworden, kleinere „Schüler“-Modelle zu trainieren, die die Denkmuster und Ausgaben riesiger „Lehrer“-Modelle nachahmen und dabei einen erstaunlichen Prozentsatz der Leistung bei einem Bruchteil der Größe behalten.
- Aggressive Quantisierung: Techniken, die die Präzision der Modellgewichte reduzieren (etwa auf 4-Bit- oder noch niedrigere Formate), ermöglichen es Modellen mit weniger als einer Milliarde Parametern, flüssig auf gewöhnlichen CPUs, lokalen Mikrocontrollern und mobilen Geräten zu laufen, ohne teure dedizierte GPUs zu benötigen.
- Wachsende Latenzanforderungen: Bei Echtzeitanwendungen – von autonomen Agenten und Robotik bis zu reaktionsschnellen Benutzeroberflächen – verursacht ein Netzwerkaufruf zu einer entfernten Cloud-API inakzeptable Latenz. Die lokale Ausführung beseitigt Netzwerkengpässe vollständig.
- Wachsender Datenschutz- und Regulierungsdruck: Unternehmen zögern zunehmend, proprietären Code, Finanzunterlagen oder sensible personenbezogene Daten an Cloud-Server von Drittanbietern zu senden. Edge-KI garantiert, dass Daten das lokale Gerät oder den gesicherten Unternehmensperimeter nie verlassen.
Warum Mikromodelle für Entwickler und IT-Verantwortliche wichtig sind
Für IT-Entscheider und Softwareentwickler eröffnet die Reife von Tiny LLMs völlig neue architektonische Möglichkeiten. Statt jede einfache Textklassifizierung, Formatierung oder Entscheidungsaufgabe über einen teuren, ratenbegrenzten Cloud-Endpunkt zu leiten, können Systeme die Intelligenz jetzt direkt in die Anwendungsschicht einbetten.
Denken Sie an die Auswirkungen auf lokale Automatisierungs- und Entscheidungsagenten. Wenn ein KI-Agent einen bedingten Schritt auswerten oder eingehende Telemetriedaten parsen muss, verwandelt die lokale Ausführung innerhalb von 30 Millisekunden – statt 800 Millisekunden auf eine Cloud-Antwort zu warten – einen trägen Workflow in ein nahtloses, hochreaktives Erlebnis. Da diese Modelle zudem lokal trainiert, feinabgestimmt oder betrieben werden können, gewinnen Unternehmen die vollständige Kontrolle über ihre Software-Stacks zurück.
Auch Sicherheits- und Compliance-Teams profitieren enorm. Läuft KI direkt auf dem Gerät, wird die Einhaltung strenger Datenschutzrahmen wie DSGVO oder HIPAA deutlich einfacher, da die Angriffsfläche für mögliche Datenlecks oder unbefugte Protokollierung durch Dritte drastisch sinkt.
Praxis-Checkliste: Tiny LLMs für Ihr nächstes Projekt bewerten
Wenn Sie erwägen, Modelle mit weniger als einer Milliarde Parametern oder Edge-Modelle in Ihre kommende Softwarearchitektur aufzunehmen, hilft Ihnen diese praktische Checkliste bei der Bewertung:
- Den Umfang definieren: Stellen Sie sicher, dass das Modell eine klar abgegrenzte Aufgabe erfüllen soll (etwa Entitätsextraktion, Routing, Syntaxprüfung oder lokalisierte Klassifizierung) und nicht offenes, kreatives Schlussfolgern.
- Latenz und Ressourcenbedarf benchmarken: Testen Sie das Modell unter realistischen Hardware-Einschränkungen – einschließlich reiner CPU-Umgebungen und speicherbeschränkter mobiler oder Edge-Geräte –, um exakte Ausführungszeit und RAM-Verbrauch zu messen.
- Auswirkungen der Quantisierung bewerten: Vergleichen Sie die Genauigkeit von Versionen mit voller Präzision mit quantisierten Formaten (wie GGUF- oder ONNX-Varianten), um die optimale Balance zwischen Leistung und Dateigröße zu finden.
- Lizenzierung und Herkunft verifizieren: Prüfen Sie die Trainingsdaten und die Open-Source-Lizenzbedingungen jedes Mikromodells, das Sie kommerziell einsetzen möchten, um Compliance sicherzustellen und nachgelagerte rechtliche Risiken zu vermeiden.
- Fallback-Mechanismen einrichten: Gestalten Sie Ihre Anwendungsarchitektur so, dass sie bei Szenarien mit geringer Konfidenz des kleinen Modells elegant auf ein größeres Cloud-Modell oder eine menschliche Prüfwarteschlange zurückfällt.
Ausblick: Die verteilte Zukunft der KI
Die Zukunft der künstlichen Intelligenz wird nicht allein davon bestimmt, wer das größte Rechenzentrum oder den teuersten GPU-Cluster besitzt. Da Mikromodelle bei Denkfähigkeit und Effizienz weiter besser werden, dehnt sich die Innovationsgrenze nach außen an den Rand (Edge) aus.
Für Unternehmen und Entwickler, die bereit sind, über den Hype um riesige cloudbasierte LLMs hinauszublicken, bietet Edge-KI einen überzeugenden Weg nach vorn: schnellere Anwendungen, bessere Datensicherheit, drastisch gesenkte Betriebskosten und echte Unabhängigkeit von zentralisierter Infrastruktur. Die Intelligenzrevolution skaliert nach unten, und in vielen Fällen erweist sich kleiner als bemerkenswert besser.
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:


