
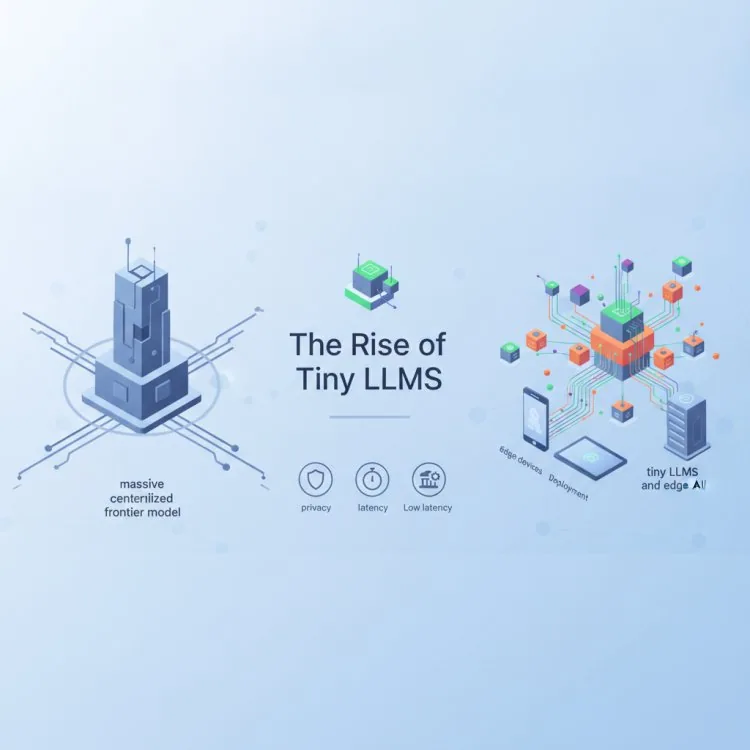
على مدى السنوات القليلة الماضية، هيمن على مشهد الذكاء الاصطناعي سباق لا يلين نحو الأعلى. ضخّت عمالقة التقنية والمختبرات النخبوية مليارات الدولارات في تدريب نماذج حدودية أكبر فأكبر، تفخر بتريليونات المعاملات ومتطلبات عناقيد سحابية ضخمة وقدرات تدفع باستمرار حدود توليد اللغة الطبيعية. قيل لنا إن الأكبر هو الأفضل دائماً.
ومع ذلك، تجري حالياً ثورة مضادة هادئة في مجتمع الذكاء الاصطناعي. يوجّه المطورون والباحثون وصنّاع القرار في تقنية المعلومات اهتمامهم بشكل متزايد بعيداً عن واجهات API السحابية الضخمة ونحو نموذج مختلف جذرياً: النماذج اللغوية الصغيرة والذكاء الاصطناعي الأصلي للحافة. وبفضل اختراقات في التكميم والتقطير والبنى النموذجية المتخصصة، تثبت النماذج التي تقل عن مليار معامل قدرتها على التعامل مع مهام متطورة محلياً، غالباً في ميلي ثوانٍ معدودة وعلى أجهزة استهلاكية بالكامل أو مباشرة داخل متصفح الويب.
هذا التحول ليس مجرد جِدّة أو استعراض تقني. إنه يمثل إعادة تقييم جوهرية لكيفية نشر الشركات والمطورين للتعلم الآلي في العالم الحقيقي، مع إعطاء الأولوية لكفاءة التكلفة وانخفاض زمن الاستجابة وسيادة البيانات على الحجم الخام بالقوة الغاشمة.
ما الذي تغيّر؟ التحول نحو الكفاءة
تسارع التحول من النماذج السحابية المتجانسة إلى النماذج اللغوية الصغيرة بفعل عدة اتجاهات تقنية متلاقية:
- التقطير المعرفي المتقدم: أصبح الباحثون بارعين للغاية في تدريب نماذج "طالبة" أصغر لمحاكاة أنماط الاستدلال ومخرجات نماذج "معلمة" ضخمة، مع الاحتفاظ بنسبة مدهشة من الأداء بجزء من الحجم.
- التكميم المكثف: تتيح التقنيات التي تقلل دقة أوزان النموذج (مثل الانخفاض إلى 4 بت أو صيغ أدنى) للنماذج التي تقل عن مليار معامل أن تعمل بسلاسة على المعالجات القياسية والمتحكمات الدقيقة المحلية والأجهزة المحمولة دون الحاجة إلى وحدات GPU مخصصة مكلفة.
- تزايد متطلبات زمن الاستجابة: للتطبيقات الفورية—من الوكلاء المستقلين والروبوتات إلى واجهات المستخدم المتجاوبة—تُدخل مكالمة شبكة ذهاباً وإياباً إلى API سحابي بعيد زمن استجابة غير مقبول. ويزيل التنفيذ المحلي اختناقات الشبكة تماماً.
- تصاعد ضغوط الخصوصية والتنظيم: تتردد المؤسسات بشكل متزايد في إرسال الشيفرة الملكية أو السجلات المالية أو البيانات الشخصية الحساسة إلى خوادم سحابية تابعة لأطراف ثالثة. ويضمن ذكاء الحافة الاصطناعي ألا تغادر البيانات الجهاز المحلي أو المحيط المؤسسي الآمن أبداً.
لماذا تهم النماذج الصغيرة المطورين وقادة تقنية المعلومات
بالنسبة لصنّاع القرار في تقنية المعلومات ومهندسي البرمجيات، يفتح نضج النماذج اللغوية الصغيرة إمكانيات معمارية جديدة كلياً. فبدلاً من تمرير كل مهمة تصنيف نصوص بسيطة أو تنسيق أو اتخاذ قرار عبر نقطة نهاية سحابية مكلفة ومحدودة المعدل، يمكن للأنظمة الآن تضمين الذكاء مباشرة في طبقة التطبيق.
فكّر في الآثار المترتبة على الأتمتة المحلية ووكلاء القرار. فعندما يحتاج وكيل ذكاء اصطناعي إلى تقييم خطوة شرطية أو تحليل بيانات قياس واردة، فإن القيام بذلك محلياً خلال 30 ميلي ثانية—بدلاً من انتظار 800 ميلي ثانية لرد السحابة—يحوّل سير عمل بطيئاً إلى تجربة سلسة فائقة الاستجابة. علاوة على ذلك، ولأن هذه النماذج يمكن تدريبها أو ضبطها أو تشغيلها محلياً، تستعيد المؤسسات السيطرة الكاملة على حزمها البرمجية.
ستستفيد فرق الأمان والامتثال أيضاً بشكل هائل. فعندما يعمل الذكاء الاصطناعي على الجهاز، يصبح الامتثال لأطر حماية البيانات الصارمة مثل GDPR أو HIPAA أكثر بساطة بكثير، إذ تتقلص بشدة مساحة التسريبات المحتملة للبيانات أو التسجيل غير المصرح به من أطراف ثالثة.
قائمة مراجعة عملية: تقييم النماذج اللغوية الصغيرة لمشروعك القادم
إذا كنت تفكر في دمج نماذج بأقل من مليار معامل أو نماذج الحافة في بنية برمجياتك القادمة، فاستخدم قائمة المراجعة العملية هذه لتوجيه عملية التقييم:
- حدد النطاق: تأكد من أن النموذج يُطلب منه أداء مهمة محدودة (مثل استخراج الكيانات أو التوجيه أو فحص الصياغة أو التصنيف المحلي) لا استدلالاً إبداعياً مفتوحاً.
- قِس زمن الاستجابة والبصمة: اختبر النموذج تحت قيود أجهزة واقعية—بما في ذلك البيئات المعتمدة على المعالج فقط والأجهزة المحمولة أو الطرفية محدودة الذاكرة—لقياس زمن التنفيذ واستهلاك الذاكرة بدقة.
- قيّم أثر التكميم: قارن دقة الإصدارات كاملة الدقة بالصيغ المكممة (مثل متغيرات GGUF أو ONNX) لإيجاد التوازن الأمثل بين الأداء وحجم الملف.
- تحقق من الترخيص والمصدر: افحص بيانات التدريب وشروط الترخيص مفتوحة المصدر لأي نموذج صغير تخطط لنشره تجارياً لضمان الامتثال وتجنب المخاطر القانونية اللاحقة.
- ضع آليات احتياطية: صمم بنية تطبيقك بحيث يتراجع بسلاسة إلى نموذج سحابي أكبر أو طابور مراجعة بشرية عندما يواجه النموذج الصغير سيناريوهات منخفضة الثقة.
نظرة إلى الأمام: المستقبل الموزع للذكاء الاصطناعي
لن يُملي مستقبل الذكاء الاصطناعي من يملك أكبر مركز بيانات أو أغلى عنقود من وحدات GPU فحسب. فمع استمرار تحسن النماذج الصغيرة في قدرة الاستدلال والكفاءة، تتوسع حدود الابتكار نحو الأطراف.
للشركات والمطورين المستعدين للنظر ما وراء ضجيج النماذج اللغوية السحابية الضخمة، يقدم تبني ذكاء الحافة الاصطناعي مساراً مقنعاً للمستقبل: تطبيقات أسرع، وأمان بيانات أشد، وتكاليف تشغيل أقل بشكل كبير، واستقلالية حقيقية عن البنية التحتية المركزية. إن ثورة الذكاء تتقلص حجماً، وفي كثير من الحالات يتبين أن الأصغر أفضل بشكل لافت.
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:


