
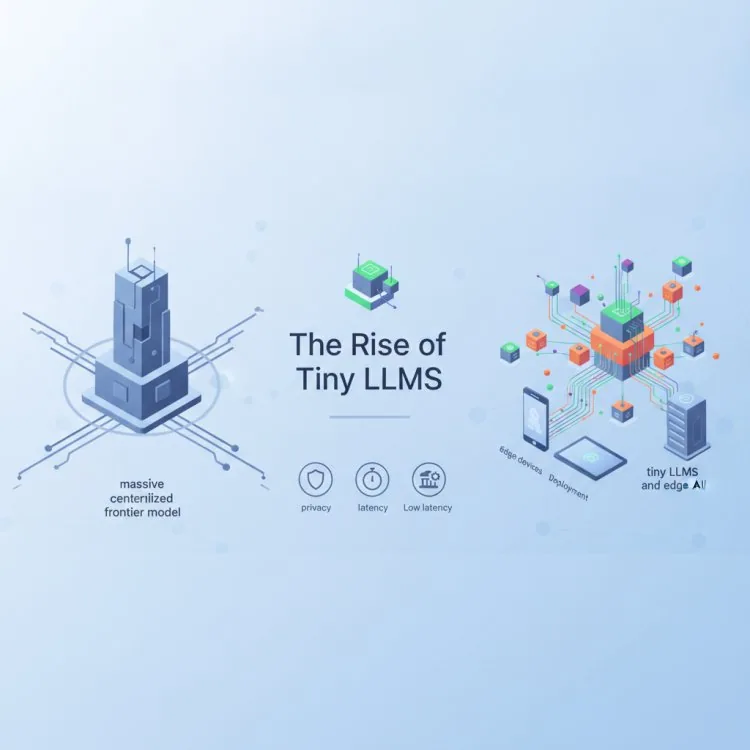
पिछले कई वर्षों में आर्टिफ़िशियल इंटेलिजेंस परिदृश्य पर ऊपर की ओर एक अथक दौड़ हावी रही है। टेक दिग्गजों और अभिजात प्रयोगशालाओं ने अरबों डॉलर लगाकर लगातार बड़े होते फ़्रंटियर मॉडल ट्रेन किए, जिनमें खरबों पैरामीटर, विशाल क्लाउड क्लस्टर की ज़रूरतें और ऐसी क्षमताएँ थीं जो प्राकृतिक भाषा निर्माण की सीमाओं को लगातार आगे धकेलती रहीं। हमें बताया गया कि बड़ा हमेशा बेहतर होता है।
फिर भी, AI समुदाय में इस समय एक शांत प्रति-क्रांति चल रही है। डेवलपर्स, शोधकर्ता और IT निर्णयकर्ता विशाल क्लाउड-बद्ध API से ध्यान हटाकर एक बुनियादी रूप से अलग प्रतिमान की ओर मुड़ रहे हैं: टिनी LLM और एज-नेटिव आर्टिफ़िशियल इंटेलिजेंस। क्वांटाइज़ेशन, डिस्टिलेशन और विशेष मॉडल आर्किटेक्चर में सफलताओं से प्रेरित होकर, सब-बिलियन पैरामीटर मॉडल परिष्कृत कार्यों को लोकल रूप से, अक्सर महज़ मिलीसेकंड में और पूरी तरह उपभोक्ता-ग्रेड हार्डवेयर पर या सीधे वेब ब्राउज़र के भीतर संभालने में सक्षम साबित हो रहे हैं।
यह बदलाव केवल नवीनता या तकनीकी प्रदर्शन के बारे में नहीं है। यह इस बात का बुनियादी पुनर्मूल्यांकन है कि व्यवसाय और डेवलपर्स वास्तविक दुनिया में मशीन लर्निंग कैसे तैनात करते हैं, जिसमें कच्चे, बलपूर्वक पैमाने के बजाय लागत दक्षता, कम लेटेंसी और डेटा संप्रभुता को प्राथमिकता दी जाती है।
क्या बदला? दक्षता की ओर बदलाव
मोनोलिथिक क्लाउड मॉडल से माइक्रो भाषा मॉडल की ओर यह बदलाव कई एक साथ आए तकनीकी रुझानों से तेज़ हुआ है:
- उन्नत नॉलेज डिस्टिलेशन: शोधकर्ताओं ने छोटे "स्टूडेंट" मॉडल को विशाल "टीचर" मॉडल के तर्क-पैटर्न और आउटपुट की नक़ल करने के लिए ट्रेन करने में असाधारण महारत हासिल कर ली है, जिससे वे आकार के एक अंश में प्रदर्शन का आश्चर्यजनक प्रतिशत बनाए रखते हैं।
- आक्रामक क्वांटाइज़ेशन: मॉडल वज़न की सटीकता घटाने वाली तकनीकें (जैसे 4-बिट या उससे भी कम फ़ॉर्मेट तक) एक अरब से कम पैरामीटर वाले मॉडल को महँगे समर्पित GPU के बिना सामान्य CPU, लोकल माइक्रोकंट्रोलर और मोबाइल डिवाइस पर सहजता से चलने देती हैं।
- बढ़ती लेटेंसी माँगें: रियल-टाइम एप्लिकेशन के लिए—स्वायत्त एजेंट और रोबोटिक्स से लेकर प्रतिक्रियाशील यूज़र इंटरफ़ेस तक—दूरस्थ क्लाउड API को राउंड-ट्रिप नेटवर्क कॉल अस्वीकार्य लेटेंसी लाती है। लोकल निष्पादन नेटवर्क बाधाओं को पूरी तरह समाप्त कर देता है।
- बढ़ता गोपनीयता और नियामकीय दबाव: उद्यम मालिकाना कोड, वित्तीय रिकॉर्ड या संवेदनशील व्यक्तिगत डेटा थर्ड-पार्टी क्लाउड सर्वर पर भेजने में अधिकाधिक हिचकिचा रहे हैं। एज AI गारंटी देता है कि डेटा कभी लोकल डिवाइस या सुरक्षित कॉर्पोरेट परिमिति से बाहर नहीं जाता।
डेवलपर्स और IT लीडर्स के लिए माइक्रो मॉडल क्यों मायने रखते हैं
IT निर्णयकर्ताओं और सॉफ़्टवेयर इंजीनियरों के लिए टिनी LLM की परिपक्वता बिल्कुल नई आर्किटेक्चरल संभावनाएँ खोलती है। हर साधारण टेक्स्ट वर्गीकरण, फ़ॉर्मेटिंग या निर्णय-कार्य को महँगे, रेट-लिमिटेड क्लाउड एंडपॉइंट से गुज़ारने के बजाय, सिस्टम अब इंटेलिजेंस को सीधे एप्लिकेशन लेयर में एम्बेड कर सकते हैं।
लोकल ऑटोमेशन और निर्णय एजेंट के निहितार्थ पर विचार करें। जब कोई AI एजेंट किसी शर्तबद्ध चरण का मूल्यांकन करता है या आने वाले टेलीमेट्री डेटा को पार्स करता है, तो क्लाउड रिस्पॉन्स के लिए 800 मिलीसेकंड प्रतीक्षा करने के बजाय उसे 30 मिलीसेकंड में लोकल रूप से करना सुस्त वर्कफ़्लो को सहज, अति-प्रतिक्रियाशील अनुभव में बदल देता है। इसके अलावा, क्योंकि इन मॉडलों को लोकल रूप से ट्रेन, फ़ाइन-ट्यून या चलाया जा सकता है, संगठन अपने सॉफ़्टवेयर स्टैक पर पूर्ण नियंत्रण वापस पा लेते हैं।
सुरक्षा और अनुपालन टीमों को भी भारी लाभ होगा। जब AI डिवाइस पर चलता है, तो GDPR या HIPAA जैसे सख़्त डेटा संरक्षण ढाँचों का अनुपालन काफ़ी सरल हो जाता है, क्योंकि संभावित डेटा लीक या अनधिकृत थर्ड-पार्टी लॉगिंग की सतह बहुत घट जाती है।
व्यावहारिक चेकलिस्ट: आपके अगले प्रोजेक्ट के लिए टिनी LLM का मूल्यांकन
यदि आप अपने आगामी सॉफ़्टवेयर आर्किटेक्चर में सब-बिलियन पैरामीटर या एज मॉडल शामिल करने पर विचार कर रहे हैं, तो अपनी मूल्यांकन प्रक्रिया का मार्गदर्शन करने के लिए इस व्यावहारिक चेकलिस्ट का उपयोग करें:
- दायरा तय करें: सुनिश्चित करें कि मॉडल से कोई सीमित कार्य (जैसे एंटिटी एक्सट्रैक्शन, रूटिंग, सिंटैक्स जाँच या स्थानीयकृत वर्गीकरण) कराया जा रहा है, न कि खुले-अंत वाला रचनात्मक तर्क।
- लेटेंसी और फ़ुटप्रिंट बेंचमार्क करें: सटीक निष्पादन समय और RAM खपत मापने के लिए मॉडल को यथार्थवादी हार्डवेयर सीमाओं—केवल-CPU वातावरण और मेमोरी-सीमित मोबाइल या एज डिवाइस सहित—के तहत परखें।
- क्वांटाइज़ेशन प्रभाव का आकलन करें: प्रदर्शन और फ़ाइल आकार के बीच इष्टतम संतुलन पाने के लिए फ़ुल-प्रिसिशन संस्करणों की सटीकता की क्वांटाइज़्ड फ़ॉर्मेट (जैसे GGUF या ONNX वेरिएंट) से तुलना करें।
- लाइसेंसिंग और उत्पत्ति सत्यापित करें: जिस भी माइक्रो मॉडल को आप व्यावसायिक रूप से तैनात करने की योजना बना रहे हैं, उसके ट्रेनिंग डेटा और ओपन-सोर्स लाइसेंसिंग शर्तों की जाँच करें ताकि अनुपालन सुनिश्चित हो और आगे के कानूनी जोखिम से बचा जा सके।
- फ़ॉलबैक तंत्र स्थापित करें: अपने एप्लिकेशन आर्किटेक्चर को ऐसे डिज़ाइन करें कि छोटा मॉडल कम-विश्वास वाली स्थितियों का सामना करे तो वह सहजता से बड़े क्लाउड मॉडल या मानवीय समीक्षा कतार पर लौट जाए।
आगे की राह: AI का वितरित भविष्य
आर्टिफ़िशियल इंटेलिजेंस का भविष्य केवल इससे तय नहीं होगा कि किसके पास सबसे बड़ा डेटा सेंटर या GPU का सबसे महँगा क्लस्टर है। जैसे-जैसे माइक्रो मॉडल तर्क-क्षमता और दक्षता में सुधार करते जा रहे हैं, नवाचार की सीमा बाहर की ओर एज तक फैल रही है।
जो व्यवसाय और डेवलपर्स विशाल क्लाउड-आधारित LLM के प्रचार से आगे देखने को तैयार हैं, उनके लिए एज AI अपनाना एक सशक्त राह है: तेज़ एप्लिकेशन, कड़ी डेटा सुरक्षा, काफ़ी घटी परिचालन लागत और केंद्रीकृत इंफ्रास्ट्रक्चर से सच्ची स्वतंत्रता। इंटेलिजेंस क्रांति छोटे आकार की ओर बढ़ रही है, और कई मामलों में छोटा होना उल्लेखनीय रूप से बेहतर साबित हो रहा है।
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:


