
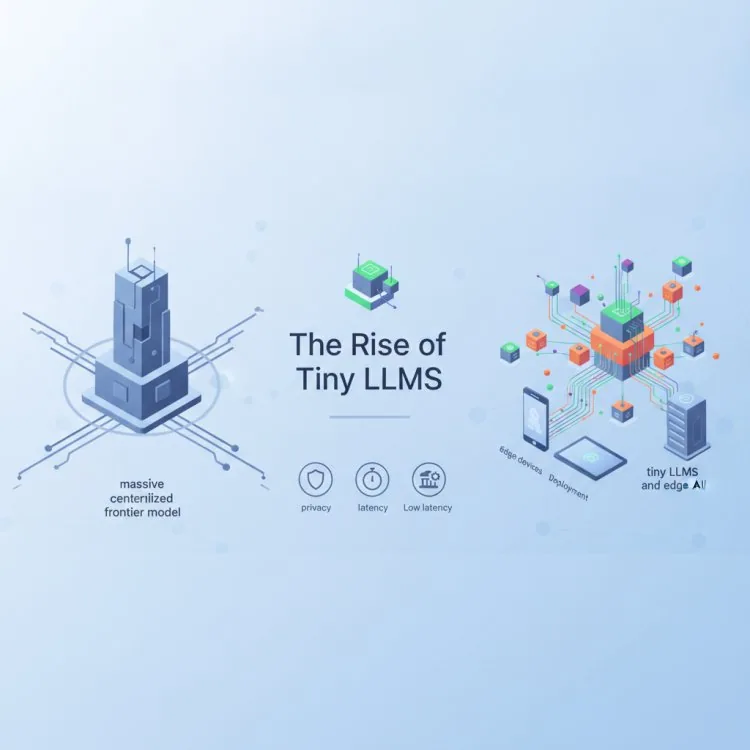
过去几年里,人工智能领域一直被一场不断向上的激烈竞赛所主导。科技巨头和顶尖实验室投入数十亿美元训练越来越大的前沿模型,它们拥有数万亿参数、庞大的云集群需求,以及不断突破自然语言生成边界的能力。我们被告知,越大总是越好。
然而,AI 社区正悄然发生一场反向革命。开发者、研究人员和 IT 决策者越来越多地把注意力从庞大的云端 API 上移开,转向一种截然不同的范式:微型 LLM 和边缘原生人工智能。在量化、蒸馏和专用模型架构突破的推动下,参数少于十亿的模型已被证明能够在本地处理复杂任务,往往只需短短几毫秒,且完全在消费级硬件上或直接在网页浏览器内运行。
这一转变不仅仅是追求新奇或炫技。它代表着对企业和开发者如何在现实世界中部署机器学习的根本性重新评估,把成本效益、低延迟和数据主权置于单纯的蛮力规模之上。
发生了什么变化?转向效率
从庞大的单体云模型转向微型语言模型,是由几个相互交汇的技术趋势推动的:
- 先进的知识蒸馏:研究人员已经非常擅长训练较小的“学生”模型来模仿庞大“教师”模型的推理模式和输出,以极小的体积保留了令人惊讶的高比例性能。
- 激进量化:降低模型权重精度的技术(如降至 4 位甚至更低的格式),使参数少于十亿的模型能够在标准 CPU、本地微控制器和移动设备上流畅运行,而无需昂贵的专用 GPU。
- 不断增长的延迟需求:对于从自主代理、机器人到响应式用户界面的实时应用而言,往返远程云 API 的网络调用会带来无法接受的延迟。本地执行则彻底消除了网络瓶颈。
- 日益加剧的隐私与监管压力:企业越来越不愿意把专有代码、财务记录或敏感个人数据发送到第三方云服务器。边缘 AI 保证数据永远不会离开本地设备或安全的企业边界。
微型模型为何对开发者和 IT 负责人至关重要
对于 IT 决策者和软件工程师来说,微型 LLM 的成熟开启了全新的架构可能性。系统不必再把每一个简单的文本分类、格式化或决策任务都路由到昂贵且有速率限制的云端点,而是可以将智能直接嵌入应用层。
想想这对本地自动化和决策代理意味着什么。当 AI 代理需要评估条件步骤或解析传入的遥测数据时,在本地 30 毫秒内完成,而不是等待云端 800 毫秒的响应,就能把迟缓的工作流变成无缝、极速响应的体验。此外,由于这些模型可以在本地训练、微调或运行,组织得以重新掌控其软件栈。
安全与合规团队同样将受益匪浅。当 AI 在设备端运行时,遵守 GDPR 或 HIPAA 等严格的数据保护框架会变得简单得多,因为潜在数据泄露或未经授权的第三方日志记录的攻击面被大幅缩小。
实用清单:为您的下一个项目评估微型 LLM
如果您正在考虑将十亿参数以下的模型或边缘模型纳入您即将开展的软件架构,请使用这份实用清单来指导您的评估过程:
- 界定范围:确保要求模型执行的是有边界的任务(如实体提取、路由、语法检查或局部分类),而不是开放式的创造性推理。
- 对延迟和占用进行基准测试:在真实的硬件约束下测试模型——包括仅 CPU 环境以及内存受限的移动或边缘设备——以测量准确的执行时间和 RAM 消耗。
- 评估量化影响:比较全精度版本与量化格式(如 GGUF 或 ONNX 变体)的准确度,以找到性能与文件大小之间的最佳平衡。
- 核实许可与来源:检查您计划商业部署的任何微型模型的训练数据和开源许可条款,以确保合规并避免下游法律风险。
- 建立回退机制:设计您的应用架构,使微型模型遇到低置信度场景时,能够平稳回退到更大的云端模型或人工审核队列。
展望未来:AI 的分布式未来
人工智能的未来不会仅仅取决于谁拥有最大的数据中心或最昂贵的 GPU 集群。随着微型模型在推理能力和效率上不断提升,创新的前沿正向边缘扩展。
对于愿意超越大型云端 LLM 炒作的企业和开发者而言,拥抱边缘 AI 提供了一条引人注目的前进之路:更快的应用、更严密的数据安全、大幅降低的运营成本,以及真正摆脱对集中式基础设施的依赖。智能革命正在向小型化发展,而且在许多情况下,越小反而越出色。
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:


