
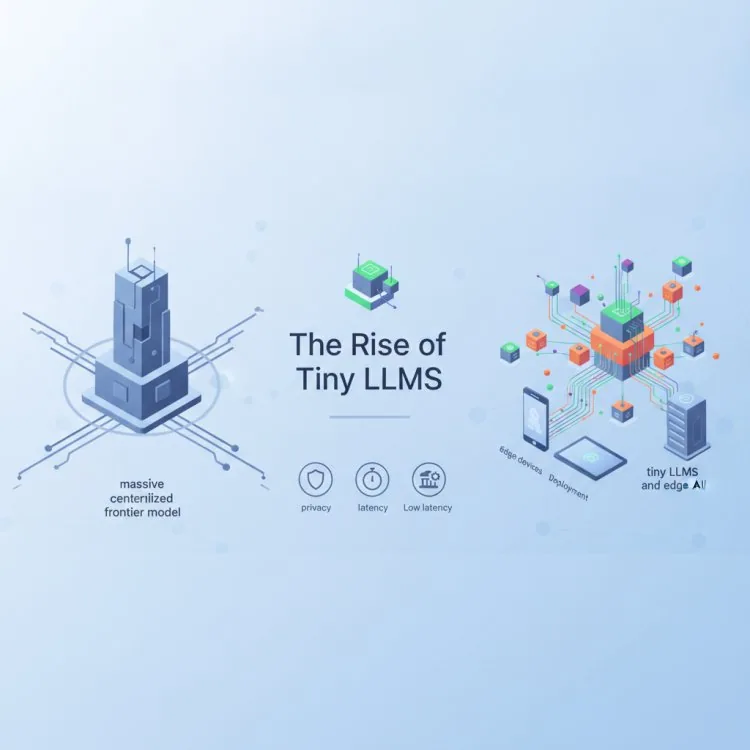
Durante los últimos años, el panorama de la inteligencia artificial ha estado dominado por una carrera implacable hacia arriba. Los gigantes tecnológicos y los laboratorios de élite invirtieron miles de millones de dólares en entrenar modelos de vanguardia cada vez más grandes, con billones de parámetros, enormes requisitos de clústeres en la nube y capacidades que empujaban continuamente los límites de la generación de lenguaje natural. Nos dijeron que más grande era siempre mejor.
Sin embargo, actualmente se está gestando una silenciosa contrarrevolución en la comunidad de la IA. Desarrolladores, investigadores y responsables de TI apartan cada vez más su atención de las enormes API ligadas a la nube y la dirigen hacia un paradigma fundamentalmente distinto: los LLM diminutos y la inteligencia artificial nativa del edge. Impulsados por avances en cuantización, destilación y arquitecturas de modelos especializadas, los modelos de menos de mil millones de parámetros demuestran ser capaces de gestionar tareas sofisticadas de forma local, a menudo en meros milisegundos y íntegramente en hardware de consumo o directamente dentro de un navegador web.
Este cambio no es solo cuestión de novedad o de exhibición técnica. Representa una reevaluación fundamental de cómo las empresas y los desarrolladores despliegan el aprendizaje automático en el mundo real, priorizando la eficiencia de costes, la baja latencia y la soberanía de los datos sobre la escala bruta y de fuerza bruta.
¿Qué ha cambiado? El giro hacia la eficiencia
El giro de los modelos monolíticos en la nube hacia los micromodelos de lenguaje ha sido catalizado por varias tendencias técnicas convergentes:
- Destilación de conocimiento avanzada: Los investigadores se han vuelto excepcionalmente buenos entrenando modelos "estudiantes" más pequeños para imitar los patrones de razonamiento y los resultados de enormes modelos "maestros", conservando un porcentaje sorprendente del rendimiento con una fracción del tamaño.
- Cuantización agresiva: Las técnicas que reducen la precisión de los pesos del modelo (por ejemplo, hasta 4 bits o incluso formatos inferiores) permiten que modelos de menos de mil millones de parámetros se ejecuten con fluidez en CPU estándar, microcontroladores locales y dispositivos móviles sin necesidad de costosas GPU dedicadas.
- Crecientes exigencias de latencia: Para las aplicaciones en tiempo real, desde agentes autónomos y robótica hasta interfaces de usuario reactivas, una llamada de red de ida y vuelta a una API remota en la nube introduce una latencia inaceptable. La ejecución local elimina por completo los cuellos de botella de la red.
- Presiones crecientes de privacidad y regulación: Las empresas dudan cada vez más en enviar código propietario, registros financieros o datos personales sensibles a servidores en la nube de terceros. La IA edge garantiza que los datos nunca salgan del dispositivo local ni del perímetro corporativo seguro.
Por qué los micromodelos importan a desarrolladores y líderes de TI
Para los responsables de TI y los ingenieros de software, la maduración de los LLM diminutos abre posibilidades arquitectónicas totalmente nuevas. En lugar de enviar cada tarea sencilla de clasificación de texto, formateo o toma de decisiones a un endpoint en la nube costoso y con límites de uso, los sistemas ahora pueden incorporar la inteligencia directamente en la capa de aplicación.
Considera las implicaciones para la automatización local y los agentes de decisión. Cuando un agente de IA necesita evaluar un paso condicional o analizar datos de telemetría entrantes, hacerlo localmente en 30 milisegundos, en lugar de esperar 800 milisegundos por una respuesta de la nube, convierte un flujo de trabajo lento en una experiencia fluida e hiperreactiva. Además, como estos modelos pueden entrenarse, ajustarse o ejecutarse localmente, las organizaciones recuperan el control total de sus pilas de software.
Los equipos de seguridad y cumplimiento también se beneficiarán enormemente. Cuando la IA se ejecuta en el dispositivo, el cumplimiento de marcos estrictos de protección de datos como el RGPD o HIPAA resulta mucho más sencillo, ya que la superficie de posibles fugas de datos o de registros no autorizados por terceros se reduce drásticamente.
Lista de verificación práctica: evaluar los LLM diminutos para tu próximo proyecto
Si estás considerando incorporar modelos de menos de mil millones de parámetros o modelos edge en tu próxima arquitectura de software, usa esta lista de verificación práctica para guiar tu proceso de evaluación:
- Define el alcance: Asegúrate de que al modelo se le pide realizar una tarea acotada (como extracción de entidades, enrutamiento, comprobación de sintaxis o clasificación localizada) y no un razonamiento creativo abierto.
- Mide la latencia y la huella: Prueba el modelo bajo restricciones de hardware realistas, incluidos entornos solo con CPU y dispositivos móviles o edge con memoria limitada, para medir el tiempo de ejecución exacto y el consumo de RAM.
- Evalúa el impacto de la cuantización: Compara la precisión de las versiones de precisión completa con los formatos cuantizados (como las variantes GGUF u ONNX) para encontrar el equilibrio óptimo entre rendimiento y tamaño de archivo.
- Verifica las licencias y la procedencia: Comprueba los datos de entrenamiento y los términos de licencia de código abierto de cualquier micromodelo que planees desplegar comercialmente para garantizar el cumplimiento y evitar riesgos legales posteriores.
- Establece mecanismos de respaldo: Diseña la arquitectura de tu aplicación para recurrir con elegancia a un modelo más grande en la nube o a una cola de revisión humana cuando el modelo diminuto se encuentre con escenarios de baja confianza.
Una mirada al futuro: el futuro distribuido de la IA
El futuro de la inteligencia artificial no lo dictará únicamente quien posea el mayor centro de datos o el clúster de GPU más caro. A medida que los micromodelos siguen mejorando en capacidad de razonamiento y eficiencia, la frontera de la innovación se expande hacia el borde.
Para las empresas y los desarrolladores dispuestos a mirar más allá del bombo de los enormes LLM basados en la nube, adoptar la IA edge ofrece un camino convincente: aplicaciones más rápidas, mayor seguridad de los datos, costes operativos drásticamente reducidos y verdadera independencia de la infraestructura centralizada. La revolución de la inteligencia se está reduciendo de escala y, en muchos casos, lo pequeño resulta ser notablemente mejor.
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:
- El auge de los micromodelos de decisión: por qué los pequeños modelos de IA abiertos están transformando el desarrollo
- Hardware de código abierto y microautomatización: más allá del bombo del IoT en el borde
- El auge de las apps móviles compiladas: cambios en rendimiento y ecosistema
- AI services and automation


