
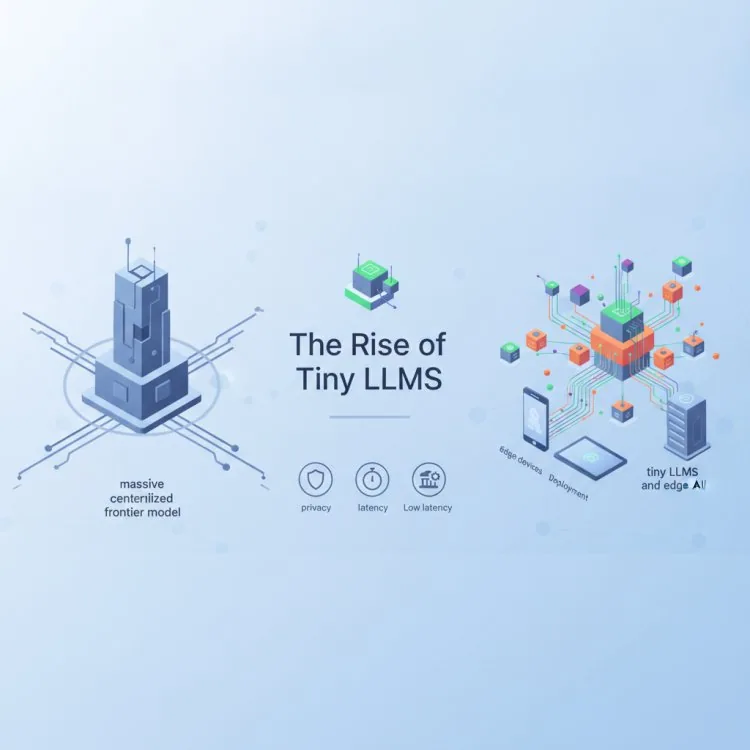
Nos últimos anos, o cenário da inteligência artificial foi dominado por uma corrida incessante para cima. Gigantes da tecnologia e laboratórios de elite investiram bilhões de dólares no treinamento de modelos frontier cada vez maiores, ostentando trilhões de parâmetros, enormes requisitos de clusters em nuvem e capacidades que ampliavam continuamente os limites da geração de linguagem natural. Quanto maior, diziam-nos, sempre melhor.
Ainda assim, uma silenciosa contrarrevolução está em curso na comunidade de IA. Desenvolvedores, pesquisadores e tomadores de decisão de TI estão voltando cada vez mais a atenção das enormes APIs presas à nuvem para um paradigma fundamentalmente diferente: LLMs minúsculos e inteligência artificial nativa de borda. Impulsionados por avanços em quantização, destilação e arquiteturas de modelo especializadas, os modelos com menos de um bilhão de parâmetros estão provando ser capazes de lidar localmente com tarefas sofisticadas, muitas vezes em meros milissegundos e inteiramente em hardware de consumo ou diretamente dentro de um navegador web.
Essa mudança não é apenas questão de novidade ou de exibicionismo técnico. Ela representa uma reavaliação fundamental de como empresas e desenvolvedores implantam aprendizado de máquina no mundo real, priorizando eficiência de custos, baixa latência e soberania de dados em vez de escala bruta e de força bruta.
O que mudou? A virada rumo à eficiência
A virada dos modelos monolíticos de nuvem para os micro modelos de linguagem foi catalisada por várias tendências técnicas convergentes:
- Destilação de conhecimento avançada: Os pesquisadores ficaram excepcionalmente bons em treinar modelos "aluno" menores para imitar os padrões de raciocínio e as saídas de enormes modelos "professor", mantendo uma porcentagem surpreendente do desempenho em uma fração do tamanho.
- Quantização agressiva: Técnicas que reduzem a precisão dos pesos do modelo (por exemplo, para 4 bits ou até formatos menores) permitem que modelos com menos de um bilhão de parâmetros rodem com fluidez em CPUs comuns, microcontroladores locais e dispositivos móveis, sem exigir GPUs dedicadas caras.
- Demandas crescentes de latência: Em aplicações em tempo real, de agentes autônomos e robótica a interfaces de usuário responsivas, uma chamada de rede de ida e volta a uma API de nuvem remota introduz uma latência inaceitável. A execução local elimina por completo os gargalos de rede.
- Pressões crescentes de privacidade e regulatórias: As empresas hesitam cada vez mais em enviar código proprietário, registros financeiros ou dados pessoais sensíveis a servidores de nuvem de terceiros. A IA de borda garante que os dados nunca saiam do dispositivo local ou do perímetro corporativo seguro.
Por que os micro modelos importam para desenvolvedores e líderes de TI
Para tomadores de decisão de TI e engenheiros de software, o amadurecimento dos LLMs minúsculos abre possibilidades arquiteturais totalmente novas. Em vez de encaminhar cada tarefa simples de classificação de texto, formatação ou tomada de decisão por um endpoint de nuvem caro e com limite de requisições, os sistemas agora podem incorporar inteligência diretamente na camada de aplicação.
Considere as implicações para a automação local e os agentes de decisão. Quando um agente de IA precisa avaliar uma etapa condicional ou interpretar dados de telemetria recebidos, fazer isso localmente em 30 milissegundos, em vez de esperar 800 milissegundos por uma resposta da nuvem, transforma um fluxo de trabalho lento em uma experiência fluida e hiper-responsiva. Além disso, como esses modelos podem ser treinados, ajustados (fine-tuned) ou executados localmente, as organizações recuperam o controle total sobre suas pilhas de software.
As equipes de segurança e conformidade também têm muito a ganhar. Quando a IA roda no próprio dispositivo, cumprir marcos rigorosos de proteção de dados como GDPR ou HIPAA fica muito mais simples, pois a superfície de possíveis vazamentos de dados ou de registros não autorizados por terceiros é drasticamente reduzida.
Checklist prático: avaliando LLMs minúsculos para o seu próximo projeto
Se você está pensando em incorporar modelos com menos de um bilhão de parâmetros ou modelos de borda à sua próxima arquitetura de software, use esta lista de verificação prática para orientar o seu processo de avaliação:
- Defina o escopo: Garanta que o modelo esteja sendo solicitado a executar uma tarefa delimitada (como extração de entidades, roteamento, verificação de sintaxe ou classificação localizada) e não um raciocínio criativo aberto.
- Meça latência e consumo de recursos: Teste o modelo sob restrições realistas de hardware, incluindo ambientes só com CPU e dispositivos móveis ou de borda com memória limitada, para medir o tempo exato de execução e o consumo de RAM.
- Avalie o impacto da quantização: Compare a precisão das versões de precisão total com formatos quantizados (como variantes GGUF ou ONNX) para encontrar o equilíbrio ideal entre desempenho e tamanho de arquivo.
- Verifique licenciamento e procedência: Confira os dados de treinamento e os termos de licenciamento open source de qualquer micro modelo que pretenda implantar comercialmente, para garantir a conformidade e evitar riscos jurídicos futuros.
- Estabeleça mecanismos de fallback: Projete a arquitetura da sua aplicação para recorrer com elegância a um modelo de nuvem maior ou a uma fila de revisão humana quando o modelo pequeno encontrar cenários de baixa confiança.
Olhando adiante: o futuro distribuído da IA
O futuro da inteligência artificial não será ditado apenas por quem possui o maior data center ou o cluster de GPUs mais caro. À medida que os micro modelos continuam melhorando em capacidade de raciocínio e eficiência, a fronteira da inovação se expande para a borda.
Para empresas e desenvolvedores dispostos a olhar além do hype dos enormes LLMs baseados em nuvem, adotar a IA de borda oferece um caminho convincente: aplicações mais rápidas, segurança de dados mais rigorosa, custos operacionais drasticamente menores e verdadeira independência da infraestrutura centralizada. A revolução da inteligência está encolhendo de escala e, em muitos casos, menor está se revelando notavelmente melhor.
More about tiny llms
Want to go further with tiny llms? These Netstech guides and services are a good next step:


