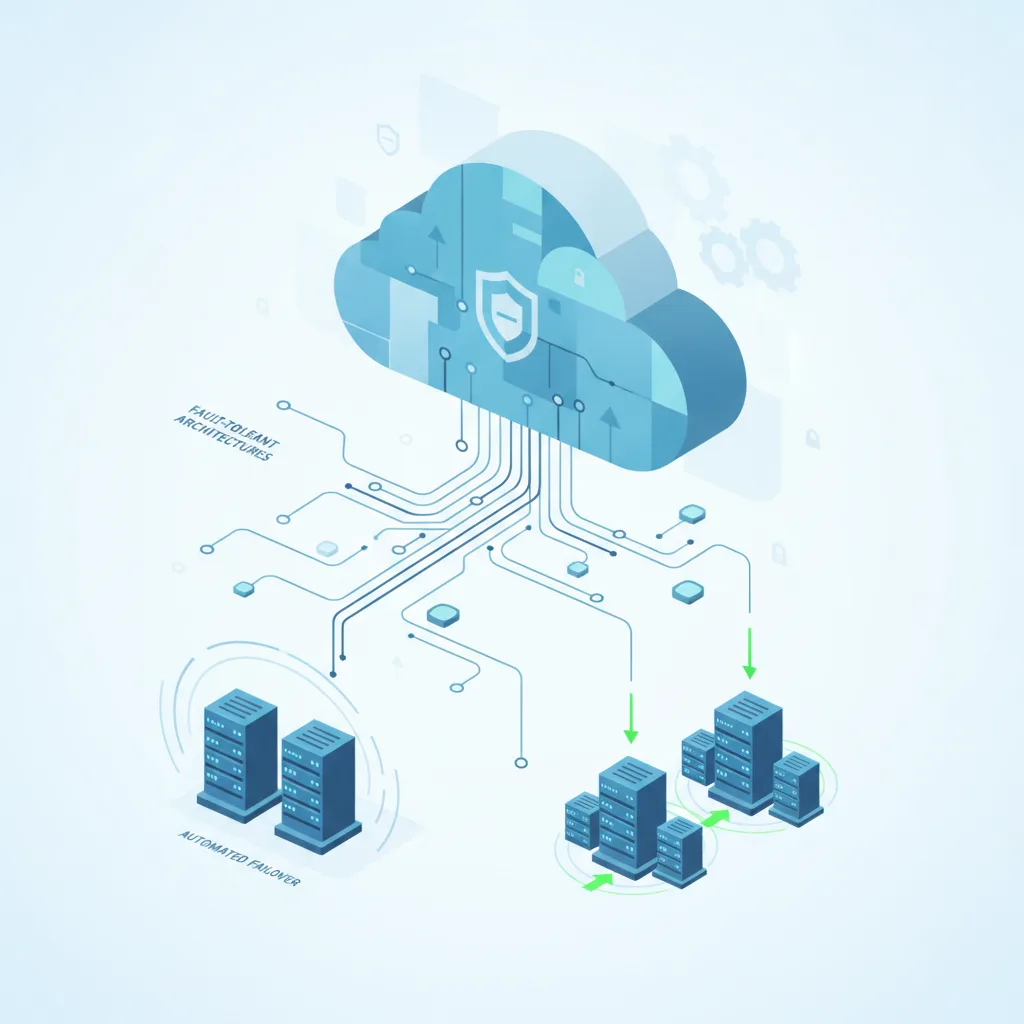
مختصراً: کلاؤڈ انفراسٹرکچر کی لچک کا مطلب ایسے سسٹم ڈیزائن کرنا ہے جو ہارڈویئر، سافٹ ویئر یا پورے ریجن کے ناکام ہونے پر بھی چلتے رہیں۔ اس میں فالٹ ٹالرنٹ آرکیٹیکچر، خودکار فیل اوور اور ہیلتھ چیکس، اور کیوس ٹیسٹنگ شامل ہیں جو ثابت کرتی ہے کہ ریکوری واقعی کام کرتی ہے۔
جدید انجینئرنگ ٹیموں کو ایک سخت توقع کا سامنا ہے: ایپلیکیشنز مسلسل چلیں، بھاری لوڈ میں فوراً اسکیل ہوں، اور بنیادی ہارڈویئر کی خرابیوں یا ریجنل کلاؤڈ بندش سے باوقار انداز میں بچ نکلیں۔ تاہم حقیقی کلاؤڈ انفراسٹرکچر لچک حاصل کرنا چند فالتو ورچوئل مشینیں چلانے یا خودکار بیک اپ کا خانہ ٹک کرنے سے کہیں آگے کی بات ہے۔ اس کے لیے فالٹ ٹالرنس، منظم کیوس ٹیسٹنگ اور سخت اسٹیٹ مینجمنٹ کی طرف سوچا سمجھا آرکیٹیکچرل رخ درکار ہے۔
جیسے جیسے کلاؤڈ ماحول پیچیدہ ہوتے جا رہے ہیں، جن میں ملٹی ریجن ڈیپلائمنٹس، سرور لیس فنکشنز، مائیکرو سروسز اور خودکار بیک گراؤنڈ ایجنٹس شامل ہیں، ہائی ایویلیبلٹی برقرار رکھنے کے لیے فیلئر ڈومینز پر نظم و ضبط والا طرزِ عمل ضروری ہے۔ آئیے وہ بنیادی ڈیزائن پیٹرنز، ریکوری حکمتِ عملیاں اور آپریشنل طریقے دیکھیں جو انجینئرنگ ٹیمیں مضبوط کلاؤڈ ماحول بنانے کے لیے استعمال کرتی ہیں۔
جدید کلاؤڈ ڈیزائن میں فیلئر ڈومینز کو سمجھنا
ہر کلاؤڈ فراہم کنندہ طبعی انفراسٹرکچر پر قائم ہے جو فطری طور پر خلل کے لیے کمزور ہے، چاہے وہ معمول کی مینٹیننس ہو، سافٹ ویئر بگز، کٹی ہوئی فائبر آپٹک کیبلز یا ریجنل بجلی کے نظام کی خرابی۔ لچکدار سسٹم بنانے کا آغاز ان طبعی حدود کو نقشے پر لانے اور ان کا احترام کرنے سے ہوتا ہے۔
بنیادی غلطی ایک کلاؤڈ ریجن کو واحد مونولیتھک سنگل پوائنٹ آف فیلئر سمجھنا ہے۔ اگرچہ جدید ایویلیبلٹی زونز (AZs) آزاد بجلی، کولنگ اور نیٹ ورکنگ کے ساتھ طبعی طور پر الگ ہوتے ہیں، پھر بھی شدید ریجنل مسئلہ کبھی کبھار سروسز کو متاثر کر سکتا ہے۔ ہائی ایویلیبلٹی کے لیے ڈیزائن کرنے کا مطلب ہے اپنی کمپیوٹ لیئر کو ڈیٹا پرسسٹنس لیئر سے الگ کرنا، تاکہ اسٹیٹ کو جغرافیائی حدود کے پار سنکرونس یا اسنکرونس طور پر ریپلیکیٹ کیا جا سکے اور تاخیر بھی نقصان دہ حد تک نہ بڑھے۔
مزید یہ کہ ٹیموں کو سافٹ ویئر کی سطح کے فیلئر ڈومینز کا بھی حساب رکھنا چاہیے۔ بے قابو بیک گراؤنڈ پروسیس، کسی اہم مائیکرو سروس میں میموری لیک، یا API گیٹ وے میں غیر سنبھالی گئی ایکسپشن آپس میں سختی سے جڑی سروسز میں پھیل کر پورا کلسٹر بٹھا سکتی ہے۔ سرکٹ بریکرز، ریٹ لمیٹرز اور بلک ہیڈ پیٹرنز سافٹ ویئر کی سطح کے ضروری دفاع ہیں جو مقامی خرابیوں کو پورے نظام کے انہدام کا سبب بننے سے روکتے ہیں۔
ہائی ایویلیبلٹی کے بنیادی آرکیٹیکچرل پیٹرنز
لچک حاصل کرنے کے لیے مخصوص ساختی پیٹرنز اپنانا ضروری ہے جو کلاؤڈ ایپلیکیشنز کو جھٹکے برداشت کرنے اور خود کو ٹھیک کرنے کے قابل بناتے ہیں۔ مضبوط کلاؤڈ آرکیٹیکچر کی چار بنیادی حکمتِ عملیاں یہ ہیں:
- ایکٹو-ایکٹو ملٹی ریجن ڈیپلائمنٹس: آنے والی ٹریفک کو بیک وقت متعدد جغرافیائی ریجنز میں تقسیم کرنا۔ اگر کوئی ریجن شدید خرابی کا شکار ہو تو DNS سطح کی روٹنگ یا گلوبل لوڈ بیلنسرز ٹریفک کو فوراً صحت مند اینڈ پوائنٹس کی طرف موڑ دیتے ہیں۔
- اسٹیٹ لیس کمپیوٹ لیئرز: سیشن ڈیٹا اور صارف کی اسٹیٹ کو ڈسٹری بیوٹڈ کیشز (جیسے Redis) یا مینیجڈ ڈیٹا بیسز کے سپرد کر کے ایپلیکیشن سرورز کو مکمل طور پر اسٹیٹ لیس رکھنا۔ اس سے انسٹینسز کو صارف کے لیے خلل کے بغیر فوراً ختم اور تبدیل کیا جا سکتا ہے۔
- گریس فل ڈیگریڈیشن: یوزر انٹرفیسز اور بیک اینڈ سروسز کو اس طرح ڈیزائن کرنا کہ زیادہ لوڈ یا جزوی بندش میں مکمل طور پر ناکام ہونے کے بجائے غیر ضروری فیچرز چھوڑ دیں۔ مثلاً پرسنلائزیشن انجن کا وقت ختم ہونے پر کیش شدہ پروڈکٹ سفارشات پر واپس آ جانا۔
- اسنکرونس ایونٹ ڈرِیون بفرنگ: پروڈیوسرز اور کنزیومرز کو الگ کرنے کے لیے مینیجڈ میسج کیوز اور ایونٹ بسز کا استعمال۔ اگر کوئی ڈاؤن اسٹریم پروسیسنگ سروس آف لائن ہو جائے تو آنے والی درخواستیں ضائع ہونے یا سسٹم پر بوجھ بننے کے بجائے کیو میں محفوظ طریقے سے بفر ہو جاتی ہیں۔
خودکار فیل اوور اور ہیلتھ چیکس کا کردار
خرابی کا جلد پتا لگانا آدھی جنگ ہے؛ سسٹم کو انسانی مداخلت کے بغیر ردِعمل بھی دینا چاہیے۔ آدھی رات کی بندش کے دوران دستی مداخلت ناگزیر تاخیر اور انسانی غلطی لاتی ہے۔ حقیقی کلاؤڈ لچک خودکار انسٹرومنٹیشن پر منحصر ہے۔
جامع ہیلتھ چیکنگ کو گہری ڈیپینڈنسیز کو جانچنا چاہیے، نہ کہ صرف یہ دیکھنا کہ ویب سرور پروسیس چل رہا ہے۔ اگر ایپلیکیشن اپنے ڈیٹا بیس میں لکھ نہیں سکتی یا بیرونی آئیڈینٹٹی پرووائیڈر سے رابطہ نہیں کر سکتی تو 200 OK لوٹانے والا سطحی پنگ خطرناک حد تک گمراہ کن ہو سکتا ہے۔ جدید ہیلتھ پروبز اینڈ ٹو اینڈ مصنوعی ٹرانزیکشنز چلاتے ہیں، جو ڈیٹا بیس کنیکٹیویٹی، کیش کی ردِعمل صلاحیت اور اسٹوریج بکٹ کی ریڈ رائٹ اجازتوں کی توثیق کرتے ہیں۔
جب کوئی جزو اپنا ہیلتھ چیک پاس نہ کر سکے تو آرکیسٹریشن لیئر کو خود بخود ٹریفک ہٹانی چاہیے، غیر صحت مند انسٹینس کو الگ کرنا چاہیے اور نیا متبادل شروع کرنا چاہیے۔ خودکار اصلاح کا یہ چکر، جسے اکثر cattle-not-pets انفراسٹرکچر مینجمنٹ کہا جاتا ہے، یقینی بناتا ہے کہ انفراسٹرکچر گھنٹوں کے بجائے سیکنڈوں میں خود کو ٹھیک کر لے۔
کیوس انجینئرنگ کے ذریعے لچک کی توثیق
آپ کو معلوم نہیں ہو سکتا کہ آپ کا آرکیٹیکچر واقعی لچکدار ہے یا نہیں جب تک اسے ناموافق حالات میں آزمایا نہ جائے۔ اپنے فیل اوور میکانزم کو جانچنے کے لیے پروڈکشن کی حقیقی بندش کا انتظار کرنا بڑا جوا ہے۔ اسی احساس نے کیوس انجینئرنگ کو عام مقبولیت دی ہے۔
کیوس انجینئرنگ میں اسٹیجنگ یا پروڈکشن ماحول میں جان بوجھ کر خرابیاں داخل کی جاتی ہیں، جیسے ڈیٹا بیس انسٹینسز بند کرنا، نیٹ ورک لیٹنسی مصنوعی طور پر بڑھانا، یا مخصوص ایویلیبلٹی زونز کی ٹریفک کو بلیک ہول کرنا، تاکہ دیکھا جا سکے کہ سسٹم کیسا ردِعمل دیتا ہے۔ کنٹرول شدہ انداز میں اجزا کو منظم طریقے سے توڑ کر ٹیمیں حقیقی صارفین کو متاثر کرنے سے پہلے پوشیدہ مفروضے، ریس کنڈیشنز اور نازک ڈیپینڈنسی چینز دریافت کر سکتی ہیں۔
آئی ٹی ٹیموں کے لیے لچک کی بہترین مشقوں کی چیک لسٹ
اپنے موجودہ کلاؤڈ آرکیٹیکچر کو جانچنے اور مضبوط بنانے کے لیے اپنی انجینئرنگ اور ڈیو آپس ٹیموں کے ساتھ اس عملی چیک لسٹ کو دیکھیں:
- اپنی ڈیپینڈنسیز کا آڈٹ کریں: ہر بیرونی API، ڈیٹا بیس اور تھرڈ پارٹی سروس کا نقشہ بنائیں جس پر آپ کی ایپلیکیشن انحصار کرتی ہے۔ پہچانیں کہ کون سی لازمی رکاوٹیں ہیں اور کون سی اختیاری۔
- سخت ٹائم آؤٹس نافذ کریں: یقینی بنائیں کہ ہر نیٹ ورک کال اور ڈیٹا بیس کوئری کے لیے واضح اور سخت ٹائم آؤٹس مقرر ہوں تاکہ ڈاؤن اسٹریم سست روی کے دوران تھریڈز ختم نہ ہوں۔
- بیک اپس خودکار بنائیں اور ریسٹور کی جانچ کریں: ڈیٹا بیس اسنیپ شاٹس اور آبجیکٹ اسٹوریج بیک اپس باقاعدگی سے شیڈول کریں، لیکن اس سے بھی اہم یہ کہ اپنے ریکوری ٹائم آبجیکٹو (RTO) اور ریکوری پوائنٹ آبجیکٹو (RPO) کی تصدیق کے لیے بحالی کا عمل خودکار بنائیں۔
- ریجنل ناکامیوں کی نقالی کریں: ایویلیبلٹی زونز اور ریجنز کے درمیان ٹریفک فیل اوور کی مشق کے لیے ٹیبل ٹاپ مشقیں اور خودکار کیوس ڈرِلز کریں۔
- ٹیلی میٹری اور الرٹنگ کو مرکزی بنائیں: لاگز، میٹرکس اور ڈسٹری بیوٹڈ ٹریسز کو ایک متحد آبزروبیلٹی پلیٹ فارم میں یکجا کریں تاکہ پھیلتی ہوئی خرابیوں کی تشخیص ان کے بگڑنے سے پہلے ہو سکے۔
ناگزیر کے لیے تیاری
کلاؤڈ کمپیوٹنگ میں ہارڈویئر کی خرابیاں، سافٹ ویئر بگز اور نیٹ ورک خلل "اگر" کا نہیں بلکہ "کب" کا معاملہ ہیں۔ اسٹیٹ لیس ڈیزائن اپنا کر، سخت ہیلتھ چیکس نافذ کر کے اور جان بوجھ کر خرابی داخل کرنے کے ذریعے اپنے سسٹمز کی توثیق کر کے آپ اپنے انفراسٹرکچر کو تاش کے کمزور گھر سے ایک لچکدار، خود شفا یاب ماحولیاتی نظام میں بدل دیتے ہیں۔
آرکیٹیکچرل لچک میں وقت لگانا کئی گنا فائدہ دیتا ہے، اور ناگزیر خلل آنے پر آپ کی تنظیم کی آمدنی، صارفین کے اعتماد اور انجینئرنگ کے سکون کی حفاظت کرتا ہے۔
کلاؤڈ انفراسٹرکچر کی لچک: فوری جوابات
فیلئر ڈومین کیا ہے؟
فیلئر ڈومین سسٹم کا وہ حصہ ہے جو ایک ساتھ ناکام ہو سکتا ہے، جیسے سرور، ریک، ایویلیبلٹی زون یا پورا ریجن۔ فیلئر ڈومینز کو سمجھنے سے آپ فالتو اجزا کو اس طرح رکھ سکتے ہیں کہ ایک خرابی سب کچھ بند نہ کر دے۔
کیوس انجینئرنگ کیا ہے؟
کیوس انجینئرنگ کا مطلب جان بوجھ کر خرابیاں داخل کرنا ہے، جیسے انسٹینسز بند کرنا یا نیٹ ورک لنکس کاٹنا، تاکہ جانچا جا سکے کہ آپ کے سسٹمز ڈیزائن کے مطابق بحال ہوتے ہیں۔ مضمون سفارش کرتا ہے کہ لچک کو یہ فرض کرنے کے بجائے کہ وہ کام کرتی ہے، اسی طرح جانچا جائے۔
خودکار فیل اوور اور ہیلتھ چیکس کیوں اہم ہیں؟
ہیلتھ چیکس غیر صحت مند اجزا کا پتا لگاتے ہیں، اور خودکار فیل اوور کسی شخص کا انتظار کیے بغیر ٹریفک یا ورک لوڈ کو صحت مند اجزا کی طرف منتقل کر دیتا ہے۔ دونوں مل کر کچھ خراب ہونے پر ڈاؤن ٹائم کم کرتے ہیں۔
متعلقہ گائیڈز
- ہمیشہ آن کلاؤڈ انفراسٹرکچر: مسلسل ایجنٹس کے لیے لاگت کنٹرول کی حکمتِ عملیاں
- ہائبرڈ کلاؤڈ FinOps: ڈسٹری بیوٹڈ انفراسٹرکچر کے اخراجات پر قابو
- کلاؤڈ ہوسٹنگ اور سرور مینجمنٹ
تفصیلی فریم ورک کے لیے AWS کا Well-Architected Framework کا ریلائیبلٹی پلر دیکھیں۔