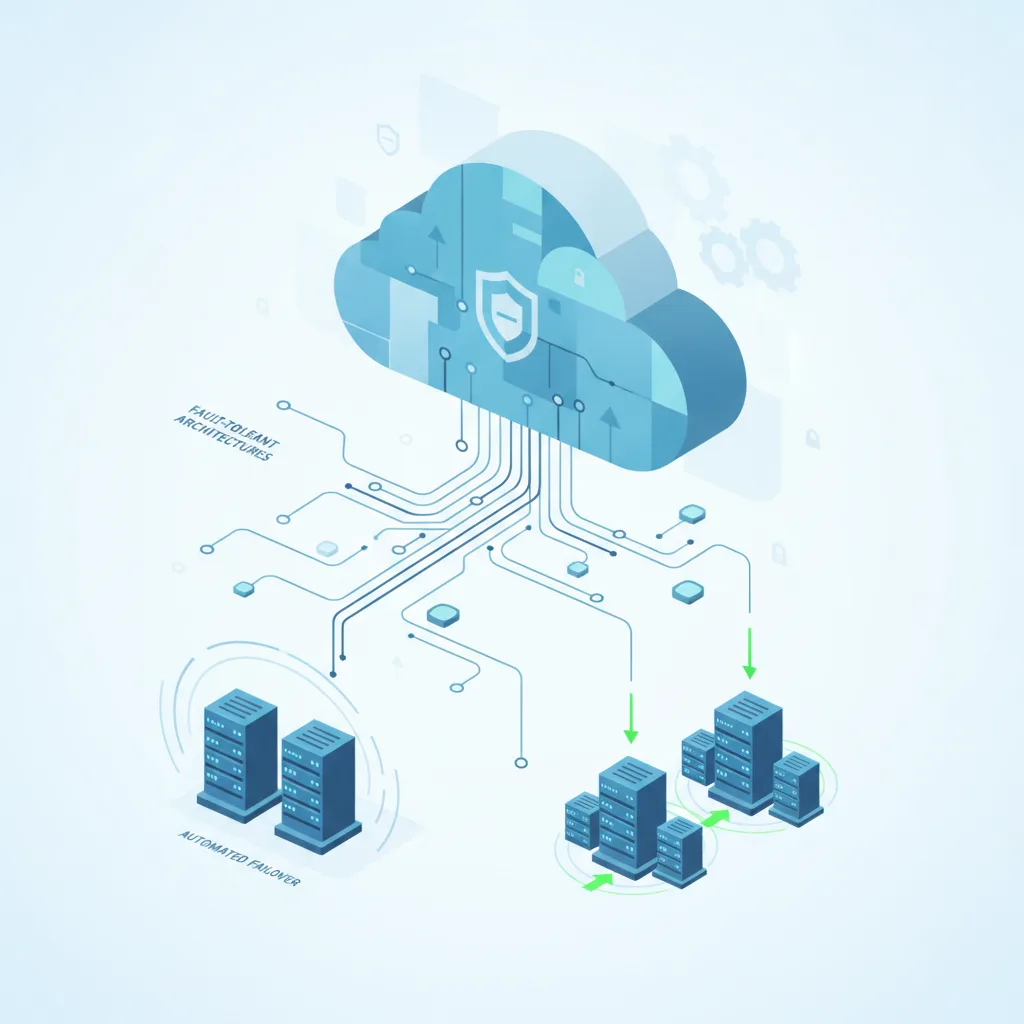
Kurz gesagt: Resilienz der Cloud-Infrastruktur bedeutet, Systeme so zu entwerfen, dass sie weiterlaufen, wenn Hardware, Software oder eine ganze Region ausfällt. Sie kombiniert fehlertolerante Architektur, automatisiertes Failover samt Health-Checks und Chaos-Tests, die belegen, dass die Wiederherstellung tatsächlich funktioniert.
Moderne Engineering-Teams stehen vor einer unnachgiebigen Erwartung: Anwendungen müssen durchgehend laufen, bei hoher Last sofort skalieren und Hardwareausfälle oder regionale Cloud-Störungen souverän überstehen. Echte Resilienz der Cloud-Infrastruktur geht jedoch weit darüber hinaus, ein paar redundante virtuelle Maschinen zu starten oder ein Häkchen bei automatischen Backups zu setzen. Sie erfordert einen bewussten architektonischen Wandel hin zu Fehlertoleranz, systematischen Chaos-Tests und konsequentem Zustandsmanagement.
Da Cloud-Umgebungen immer komplexer werden – mit Multi-Region-Deployments, Serverless-Funktionen, Microservices und autonomen Hintergrundagenten –, erfordert hohe Verfügbarkeit einen disziplinierten Umgang mit Fehlerdomänen. Wir betrachten die zentralen Entwurfsmuster, Wiederherstellungsstrategien und betrieblichen Praktiken, mit denen Engineering-Teams absturzsichere Cloud-Umgebungen aufbauen.
Fehlerdomänen im modernen Cloud-Design verstehen
Jeder Cloud-Anbieter basiert auf physischer Infrastruktur, die von Natur aus störanfällig ist – ob durch Routinewartung, Softwarefehler, durchtrennte Glasfaserkabel oder Ausfälle des regionalen Stromnetzes. Wer resiliente Systeme bauen will, beginnt damit, diese physischen Grenzen zu erfassen und zu respektieren.
Ein grundlegender Fehler ist es, eine einzelne Cloud-Region als monolithischen Single Point of Failure zu behandeln. Moderne Verfügbarkeitszonen (AZs) sind zwar physisch getrennt und verfügen über eigene Stromversorgung, Kühlung und Netzwerke, doch ein schwerwiegendes regionales Problem kann Dienste dennoch beeinträchtigen. Design für Hochverfügbarkeit heißt, die Compute-Schicht von der Datenhaltungsschicht zu entkoppeln, damit Zustand synchron oder asynchron über geografische Grenzen hinweg repliziert werden kann, ohne lähmende Latenz zu erzeugen.
Darüber hinaus müssen Teams Fehlerdomänen auf Softwareebene berücksichtigen. Ein außer Kontrolle geratener Hintergrundprozess, ein Speicherleck in einem kritischen Microservice oder eine unbehandelte Ausnahme in einem API-Gateway kann sich über eng gekoppelte Dienste ausbreiten und einen ganzen Cluster lahmlegen. Circuit Breaker, Rate Limiter und Bulkhead-Muster sind unverzichtbare Schutzmechanismen auf Softwareebene, die verhindern, dass lokale Fehler einen systemweiten Zusammenbruch auslösen.
Zentrale Architekturmuster für Hochverfügbarkeit
Resilienz erfordert bestimmte Strukturmuster, mit denen Cloud-Anwendungen Störungen abfedern und sich selbst heilen können. Hier sind vier grundlegende Strategien für eine robuste Cloud-Architektur:
- Active-Active-Multi-Region-Deployments: Eingehender Datenverkehr wird gleichzeitig auf mehrere geografische Regionen verteilt. Wird eine Region kritisch beeinträchtigt, leiten DNS-basiertes Routing oder globale Load Balancer den Datenverkehr sofort auf gesunde Endpunkte um.
- Zustandslose Compute-Schichten: Anwendungsserver bleiben vollständig zustandslos, indem Sitzungsdaten und Nutzerzustand in verteilte Caches (etwa Redis) oder verwaltete Datenbanken ausgelagert werden. So lassen sich Instanzen ohne Beeinträchtigung der Nutzer sofort beenden und ersetzen.
- Graceful Degradation: Benutzeroberflächen und Backend-Dienste werden so gestaltet, dass sie bei hoher Last oder Teilausfällen nicht-essenzielle Funktionen abschalten, statt komplett auszufallen. Zum Beispiel der Rückgriff auf zwischengespeicherte Produktempfehlungen, wenn die Personalisierungs-Engine in ein Timeout läuft.
- Asynchrone, ereignisgesteuerte Pufferung: Verwaltete Nachrichtenwarteschlangen und Event-Busse entkoppeln Produzenten und Konsumenten. Fällt ein nachgelagerter Verarbeitungsdienst aus, werden eingehende Anfragen sicher in der Warteschlange gepuffert, statt verworfen zu werden oder das System zu überlasten.
Die Rolle von automatisiertem Failover und Health-Checks
Einen Ausfall schnell zu erkennen, ist nur die halbe Miete; das System muss auch ohne menschliches Eingreifen reagieren. Manuelle Eingriffe bei einem Ausfall mitten in der Nacht führen unweigerlich zu Verzögerungen und menschlichen Fehlern. Echte Cloud-Resilienz beruht auf automatisierter Instrumentierung.
Umfassende Health-Checks sollten tiefe Abhängigkeiten prüfen, statt nur zu verifizieren, dass ein Webserver-Prozess läuft. Ein oberflächlicher Ping mit dem Status 200 OK kann gefährlich irreführend sein, wenn die Anwendung nicht mehr in ihre Datenbank schreiben oder mit einem externen Identitätsanbieter kommunizieren kann. Moderne Health-Probes führen synthetische End-to-End-Transaktionen aus und prüfen Datenbankverbindung, Cache-Reaktionsfähigkeit und Lese-/Schreibrechte auf Storage-Buckets.
Besteht eine Komponente ihren Health-Check nicht, muss die Orchestrierungsschicht automatisch den Datenverkehr abziehen, die fehlerhafte Instanz isolieren und eine frische Ersatzinstanz starten. Dieser automatisierte Behebungszyklus – oft als „Cattle, not Pets“-Ansatz der Infrastrukturverwaltung bezeichnet – sorgt dafür, dass sich die Infrastruktur in Sekunden statt in Stunden selbst heilt.
Resilienz durch Chaos Engineering validieren
Ob Ihre Architektur wirklich resilient ist, wissen Sie erst, wenn Sie sie unter widrigen Bedingungen getestet haben. Auf einen echten Produktionsausfall zu warten, um Ihre Failover-Mechanismen zu prüfen, ist ein riskantes Glücksspiel. Diese Erkenntnis hat Chaos Engineering weit verbreitet.
Beim Chaos Engineering werden gezielt Fehler in eine Staging- oder Produktionsumgebung eingebracht – etwa das Beenden von Datenbankinstanzen, künstlich erhöhte Netzwerklatenz oder das Verwerfen von Datenverkehr zu bestimmten Verfügbarkeitszonen –, um zu beobachten, wie das System reagiert. Indem Teams Komponenten kontrolliert und systematisch ausfallen lassen, decken sie versteckte Annahmen, Race Conditions und brüchige Abhängigkeitsketten auf, bevor echte Nutzer betroffen sind.
Checkliste mit Best Practices zur Resilienz für IT-Teams
Um Ihre aktuelle Cloud-Architektur zu bewerten und zu stärken, gehen Sie diese praxisnahe Checkliste gemeinsam mit Ihren Engineering- und DevOps-Teams durch:
- Abhängigkeiten prüfen: Erfassen Sie jede externe API, Datenbank und jeden Drittanbieterdienst, auf den Ihre Anwendung angewiesen ist. Legen Sie fest, welche davon kritische Blocker und welche optional sind.
- Strikte Timeouts durchsetzen: Stellen Sie sicher, dass jeder Netzwerkaufruf und jede Datenbankabfrage ausdrückliche, knapp bemessene Timeouts hat, damit bei Verlangsamungen nachgelagerter Dienste keine Thread-Erschöpfung auftritt.
- Backups automatisieren und Wiederherstellungen testen: Planen Sie regelmäßig Datenbank-Snapshots und Object-Storage-Backups ein, vor allem aber automatisieren Sie die Wiederherstellung, um Ihr Recovery Time Objective (RTO) und Ihr Recovery Point Objective (RPO) zu überprüfen.
- Regionale Ausfälle simulieren: Führen Sie Planspiele und automatisierte Chaos-Übungen durch, um das Umschalten des Datenverkehrs zwischen Verfügbarkeitszonen und Regionen zu trainieren.
- Telemetrie und Alarmierung zentralisieren: Bündeln Sie Logs, Metriken und verteilte Traces in einer einheitlichen Observability-Plattform, um Kaskadenfehler zu diagnostizieren, bevor sie eskalieren.
Für das Unvermeidliche bauen
Im Cloud Computing sind Hardwareausfälle, Softwarefehler und Netzwerkstörungen keine Frage des „Ob“, sondern des „Wann“. Mit zustandslosen Designs, konsequenten Health-Checks und der Validierung Ihrer Systeme durch gezielte Fehlerinjektion verwandeln Sie Ihre Infrastruktur von einem fragilen Kartenhaus in ein widerstandsfähiges, selbstheilendes Ökosystem.
Die Investition in architektonische Resilienz zahlt sich exponentiell aus: Sie schützt den Umsatz Ihres Unternehmens, das Vertrauen der Nutzer und die Nerven Ihrer Entwickler, wenn die unvermeidlichen Störungen eintreten.
Resilienz der Cloud-Infrastruktur: kurze Antworten
Was ist eine Fehlerdomäne?
Eine Fehlerdomäne ist der Teil eines Systems, der gemeinsam ausfallen kann, etwa ein Server, ein Rack, eine Verfügbarkeitszone oder eine ganze Region. Wer Fehlerdomänen versteht, kann redundante Komponenten so platzieren, dass ein einzelner Ausfall nicht alles lahmlegt.
Was ist Chaos Engineering?
Chaos Engineering bedeutet, gezielt Fehler einzubringen, etwa Instanzen zu stoppen oder Netzwerkverbindungen zu trennen, um zu prüfen, dass Ihre Systeme sich wie vorgesehen erholen. Der Artikel empfiehlt, Resilienz auf diese Weise zu validieren, statt davon auszugehen, dass sie funktioniert.
Warum sind automatisiertes Failover und Health-Checks wichtig?
Health-Checks erkennen fehlerhafte Komponenten, und automatisiertes Failover verlagert Datenverkehr oder Workloads auf gesunde Komponenten, ohne auf einen Menschen zu warten. Zusammen verkürzen sie die Ausfallzeit, wenn etwas kaputtgeht.
Weiterführende Ratgeber
- Dauerhaft laufende Cloud-Infrastruktur: Strategien zur Kostenkontrolle für kontinuierliche Agenten
- FinOps in der Hybrid Cloud: Kosten verteilter Infrastruktur im Griff behalten
- Cloud-Hosting und Serververwaltung
Ein ausführliches Rahmenwerk finden Sie in der Säule „Zuverlässigkeit“ des Well-Architected Framework von AWS.