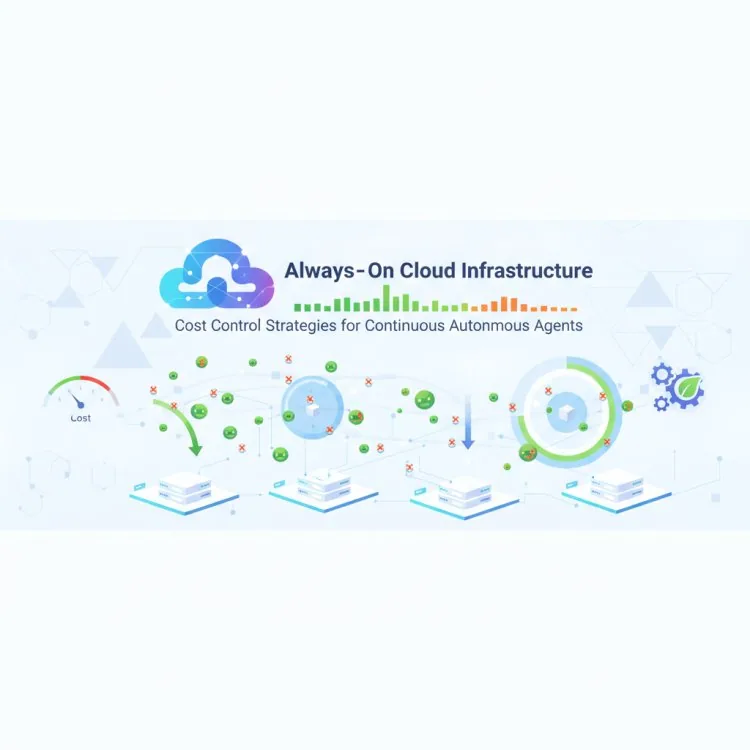
Die moderne Cloud-Landschaft durchläuft einen stillen, strukturellen Wandel. Jahrelang war das vorherrschende Architekturparadigma reaktiv und episodisch: Ein Ereignis löst eine Serverless-Funktion aus, ein Nutzer ruft eine Webseite auf, ein Batch-Job läuft über Nacht, und die Ressourcen skalieren wieder auf null herunter. Heute setzen Engineering-Teams zunehmend Always-on-Cloud-Komponenten ein – von kontinuierlichen Überwachungsagenten und persistenten Hintergrund-Datenpipelines bis zu autonomen Hilfssystemen, die rund um die Uhr laufen.
Obwohl diese persistenten Workloads beispiellose Reaktionsfähigkeit und Automatisierungsmöglichkeiten bieten, bringen sie eine harte wirtschaftliche Realität mit sich. Läuft die Infrastruktur rund um die Uhr, versagt die klassische Auto-Scaling-Logik. Eine Ressource, die dauerhaft bereitgestellt bleibt, kann sich nicht auf kurzfristige Verkehrsrückgänge verlassen, um ihre Monatsrechnung zu senken. Da Entwicklungsteams auf Always-on-Muster umschwenken, hat sich das kontinuierliche Cloud-Kostenmanagement von einer wünschenswerten Optimierungsübung zu einer zentralen Überlebenskennzahl moderner IT-Organisationen entwickelt.
Die verborgene Ökonomie von Always-on-Cloud-Workloads
Wenn die Recheninfrastruktur von On-Demand auf dauerhaft umgestellt wird, ändert sich die Rechnung drastisch. In einem On-Demand-Modell hat eine Überprovisionierung eines Servers um 20 % für einige Spitzenstunden kaum finanzielle Auswirkungen. Wird derselbe 20-%-Puffer jedoch über 720 Stunden im Monat ausgedehnt, summiert sich die Verschwendung exponentiell.
Darüber hinaus erfordern Always-on-Architekturen häufig persistentes Zustandsmanagement, ständiges Netzwerk-Polling und Hintergrundsynchronisation. Diese Vorgänge verbrauchen kontinuierlich CPU, Arbeitsspeicher und Egress-Bandbreite. Ohne bewusste architektonische Leitplanken stellen Teams oft fest, dass dem betrieblichen Komfort kontinuierlicher Hintergrundautomatisierung ein plötzlicher, unerwarteter Anstieg der monatlichen Cloud-Rechnung gegenübersteht.
Um die Vorteile kontinuierlicher Infrastruktur zu nutzen, ohne das Budget zu sprengen, müssen Engineering- und FinOps-Teams einen zweigleisigen Ansatz verfolgen: zentrale Architekturmuster verfeinern, um Persistenz effizient zu handhaben, und eine konsequente Ressourcen-Governance einführen.
Architekturmuster für effiziente persistente Infrastruktur
Die Optimierung von Always-on-Cloud-Systemen beginnt am Reißbrett. Wenn ein Workload kontinuierlich laufen muss, muss sein zugrunde liegendes Design auf Basis-Effizienz statt auf Spitzenlast-Kapazität optimiert sein.
- Right-Sizing für Basislasten: Anders als elastische Web-Apps, die Spielraum für Lastspitzen brauchen, verbrauchen kontinuierliche Hintergrundagenten oft eine vorhersehbare, gleichbleibende Ressourcenmenge. Profilieren Sie Ihre persistenten Workloads sorgfältig, um sie mit hochspezifischen Instanztypen statt mit allgemeinen Standardstufen abzugleichen.
- Zustand von der Rechenleistung entkoppeln: Halten Sie Ihre kontinuierlichen Rechenknoten wo möglich zustandslos. Indem Sie Sitzungsdaten, Logs und Zustands-Caches in verteilten, kostengünstigen Objektspeicher oder verwaltete Caching-Schichten auslagern, werden Ihre Compute-Instanzen vollständig austauschbar – und lassen sich leichter im laufenden Betrieb auf günstigere Kapazitätspools verschieben.
- Asynchrone Ereignispufferung: Statt Always-on-Agenten externe APIs oder Datenbanken in engen Schleifen direkt abfragen zu lassen, führen Sie dauerhafte Message-Queues ein. Das Bündeln von Operationen und deren asynchrone Verarbeitung verhindert unnötiges Ressourcen-Thrashing und stabilisiert die CPU-Auslastung.
Eine praktische Checkliste zur Kostenoptimierung von Always-on-Cloud-Systemen
Finanzielle Verantwortlichkeit für kontinuierliche Workloads erfordert eine strukturierte Routine. Nutzen Sie die folgende Checkliste, um Ihre Always-on-Infrastruktur zu prüfen und versteckte Verschwendung aufzudecken:
- Auf Savings Plans und Reserved Instances setzen: Für Workloads, die im nächsten Jahr oder in den nächsten drei Jahren garantiert rund um die Uhr laufen, vermeiden Sie On-Demand-Preise vollständig. Sichern Sie Basiskapazität durch langfristige Verpflichtungen, um die Rechenkosten um bis zu 40 % oder mehr zu senken.
- Egress und Netzwerkverkehr prüfen: Always-on-Agenten kommunizieren häufig mit externen Diensten, Multi-Region-Datenbanken oder Logging-Endpunkten. Erfassen Sie Ihre Datenübertragungspfade, um Gebühren für Cross-AZ- (Availability Zone) und Cross-Region-Verkehr zu eliminieren, die sich unbemerkt summieren.
- Strenge Observability-Schwellenwerte umsetzen: Richten Sie Warnungen zur Anomalieerkennung ein, die nicht nur bei offenen Ausfällen auslösen, sondern auch bei schleichendem Ressourcenwachstum. Wenn der Speicherbedarf eines Hintergrundagenten über 72 Stunden langsam ansteigt, sollte Ihr Monitoring-Werkzeug dies erkennen, bevor es ein teures Node-Upgrade erzwingt.
- Spot- und temporäre Kapazität für fehlertolerante Aufgaben nutzen: Selbst in einer kontinuierlichen Architektur können bestimmte Teilaufgaben (etwa Log-Aggregation oder periodische Datenindizierung) Unterbrechungen verkraften. Leiten Sie diese sekundären Hintergrundaufgaben mit automatischen Fallback-Mechanismen auf Spot-Instanzen.
Innovation und finanzielle Governance in Einklang bringen
Der Trend zu autonomeren, dauerhaft laufenden Cloud-Systemen bedeutet einen großen Sprung für die Produktivität von Entwicklern und die Reaktionsfähigkeit von Systemen. Technologieverantwortliche müssen jedoch sicherstellen, dass die Entwicklungsgeschwindigkeit der finanziellen Governance nicht davonläuft. Wer die Optimierung der Cloud-Kosten als architektonische Randbedingung statt als nachträglichen Gedanken behandelt, kann das volle Potenzial kontinuierlicher Infrastruktur nutzen, ohne einen Budgetschock am Monatsende zu erleben.
Letztlich erfordert nachhaltige Cloud-Architektur eine Kultur, in der Entwickler die finanziellen Auswirkungen ihres rund um die Uhr laufenden Codes verstehen. Wenn kontinuierliche Automatisierung zur Standarderwartung an moderne Software wird, trennt die Verbindung von technischem Design mit konsequenten FinOps-Praktiken effiziente Engineering-Organisationen vom Rest.
More about always-on cloud
Want to go further with always-on cloud? These Netstech guides and services are a good next step: