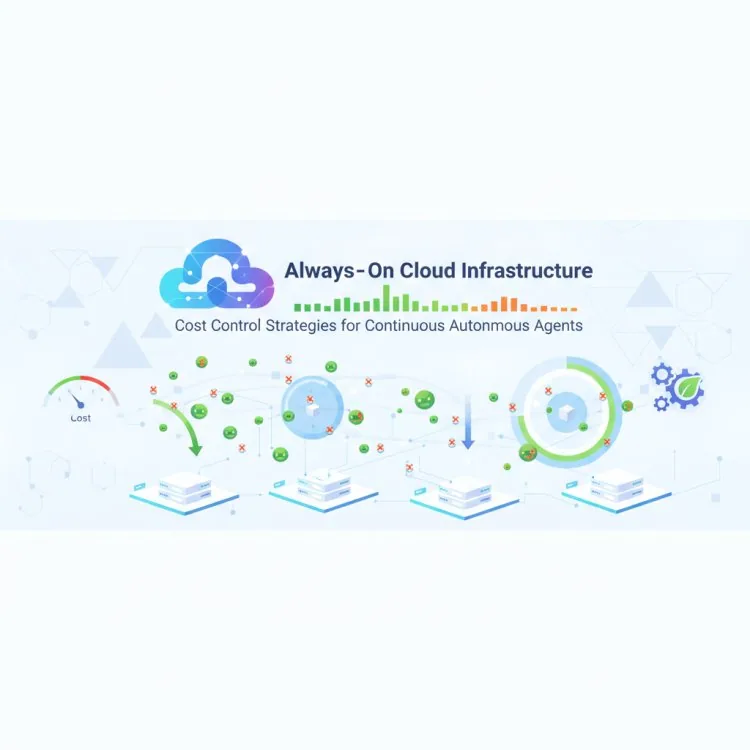
现代云领域正在经历一场悄然的结构性变革。多年来,主流的架构范式是被动且间歇性的:事件触发一个无服务器函数,用户请求一个网页,批处理作业在夜间运行,随后资源缩减为零。如今,工程团队越来越多地部署始终在线的云组件——从持续监控代理、持久的后台数据管道,到全天候运行的自主辅助系统。
这些持久运行的工作负载提供了前所未有的响应能力和自动化能力,但也带来了严峻的经济现实。当基础设施 24/7 运行时,传统的自动伸缩逻辑便会失效。持续保持配置的资源无法依靠短期流量低谷来压低月度账单。随着工程团队转向始终在线的模式,掌握持续的云成本管理已从“锦上添花”的优化工作,转变为现代 IT 组织的核心生存指标。
始终在线云工作负载的隐性经济学
当计算基础设施从按需转变为持续运行时,账就完全不同了。在按需模式下,为了几个高峰时段把服务器多配 20%,产生的费用几乎可以忽略。但把同样 20% 的冗余放大到每月 720 小时,浪费就会呈指数级累积。
此外,始终在线的架构通常需要持久的状态管理、持续的网络轮询和后台同步任务。这些操作会不断消耗 CPU、内存和出站带宽。如果没有刻意设置的架构护栏,团队常常会发现:持续后台自动化带来的运维便利,换来的是每月云账单突如其来、出乎意料的飙升。
要在不突破预算的前提下获得持续运行基础设施的好处,工程团队和 FinOps 团队必须采取双管齐下的方法:优化核心架构模式以高效处理持久性,并实施严格的资源治理。
高效持久基础设施的架构模式
优化始终在线的云系统要从设计图纸阶段开始。如果某个工作负载必须持续运行,其底层设计就必须以基线效率为优化目标,而不是追求峰值突发能力。
- 针对基线进行合理规格配置:与需要为流量高峰预留余量的弹性网页应用不同,持续运行的后台代理通常消耗可预测的、平稳的资源量。请仔细分析您的持久工作负载,用高度精准的实例类型与之匹配,而不是默认选用通用型规格。
- 将状态与计算解耦:尽可能让您的持续运行计算节点保持无状态。将会话数据、日志和状态缓存转移到分布式低成本对象存储或托管缓存层,您的计算实例就能完全可随时丢弃——从而更容易将它们即时迁移到更便宜的容量池。
- 异步事件缓冲:不要让始终在线的代理在紧凑的循环中直接轮询外部 API 或数据库,而应引入持久化消息队列。批量处理并异步执行操作,可以避免不必要的资源抖动,并稳定 CPU 利用率。
始终在线云成本优化实用清单
为持续运行的工作负载落实财务责任,需要一套结构化的例行流程。请使用以下清单审计您的始终在线基础设施,找出隐藏的浪费:
- 承诺使用节省计划和预留实例:对于确定未来一到三年都将 24/7 运行的工作负载,请完全避免按需计价。通过长期承诺锁定基线容量,将计算成本削减最多 40% 甚至更多。
- 审计出站和网络流量:始终在线的代理经常与外部服务、多区域数据库或日志端点通信。梳理您的数据传输路径,消除随时间悄然累积的跨可用区(AZ)和跨区域流量费用。
- 实施严格的可观测性阈值:设置异常检测告警,不仅在彻底故障时触发,也在资源逐渐蠕增时触发。如果某个后台代理的内存占用在 72 小时内缓慢上升,您的监控工具应在它迫使您进行昂贵的节点升级之前就发现这一问题。
- 为容错任务利用 Spot 和临时容量:即使在持续运行的架构中,某些子任务(如日志聚合或定期数据索引)也能容忍中断。将这些次要的后台任务路由到带有自动回退机制的 Spot 实例上。
平衡创新与财务治理
向更自主、始终在线的云系统迈进,代表着开发者生产力和系统响应能力的重大飞跃。然而,技术负责人必须确保工程速度不会超过财务治理。把云成本优化视为架构约束而非事后补救,团队就能充分发挥持续运行基础设施的潜力,而不会在月底遭遇预算冲击。
归根结底,可持续的云架构需要一种文化:让开发者理解其代码全天候运行所带来的财务影响。随着持续自动化成为现代软件的标准预期,将技术设计与严格的 FinOps 实践相结合,将使高效的工程组织从其他组织中脱颖而出。
More about always-on cloud
Want to go further with always-on cloud? These Netstech guides and services are a good next step: