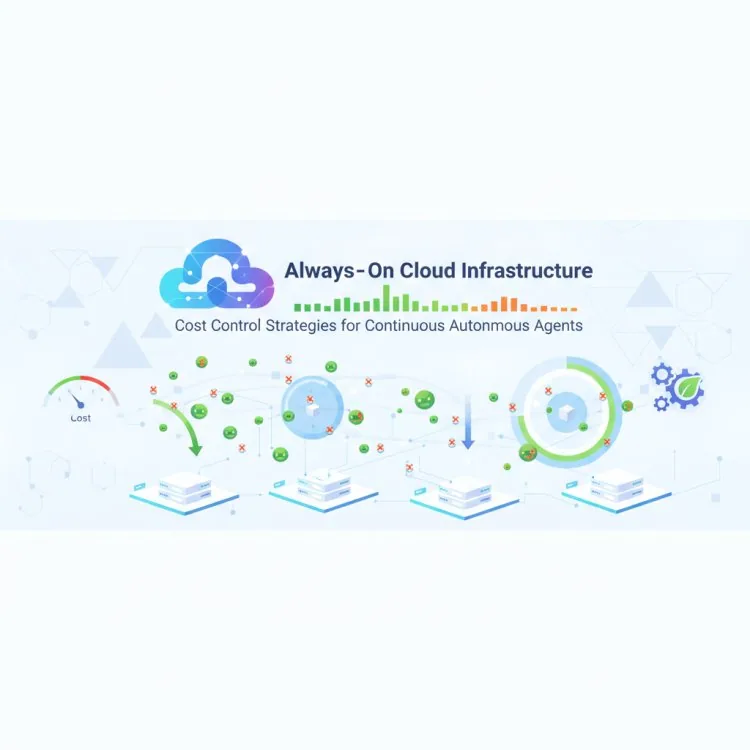
El panorama de la nube moderna está experimentando una transformación estructural silenciosa. Durante años, el paradigma arquitectónico predominante fue reactivo y episódico: un evento activa una función serverless, un usuario solicita una página web, un trabajo por lotes se ejecuta durante la noche y los recursos vuelven a escalar a cero. Hoy, los equipos de ingeniería despliegan cada vez más componentes de nube siempre activos, desde agentes de monitorización continua y pipelines de datos persistentes en segundo plano hasta sistemas auxiliares autónomos que funcionan las 24 horas del día.
Aunque estas cargas de trabajo persistentes ofrecen una capacidad de respuesta y de automatización sin precedentes, introducen una dura realidad económica. Cuando la infraestructura funciona 24/7, la lógica tradicional de autoescalado deja de funcionar. Un recurso que permanece aprovisionado de forma continua no puede depender de caídas de tráfico a corto plazo para reducir su factura mensual. A medida que los equipos de ingeniería giran hacia patrones siempre activos, dominar la gestión continua de costes en la nube ha pasado de ser un ejercicio de optimización deseable a una métrica de supervivencia esencial para las organizaciones de TI modernas.
La economía oculta de las cargas de trabajo en la nube siempre activas
Cuando la infraestructura informática pasa de ser bajo demanda a ser persistente, las cuentas cambian drásticamente. En un modelo bajo demanda, sobredimensionar un servidor un 20 % durante unas pocas horas pico supone una huella financiera insignificante. Sin embargo, si ese mismo margen del 20 % se extiende a lo largo de 720 horas en un mes, el desperdicio se acumula de forma exponencial.
Además, las arquitecturas siempre activas suelen requerir una gestión de estado persistente, sondeos constantes de red y tareas de sincronización en segundo plano. Estas operaciones consumen flujos constantes de CPU, memoria y ancho de banda de salida. Sin barreras arquitectónicas deliberadas, los equipos suelen descubrir que la comodidad operativa de la automatización continua en segundo plano solo se ve igualada por un repentino e inesperado pico en su factura mensual de la nube.
Para aprovechar los beneficios de la infraestructura continua sin romper el presupuesto, los equipos de ingeniería y FinOps deben adoptar un enfoque doble: refinar los patrones arquitectónicos básicos para gestionar la persistencia de forma eficiente e implementar una gobernanza de recursos rigurosa.
Patrones arquitectónicos para una infraestructura persistente eficiente
Optimizar los sistemas en la nube siempre activos empieza en el tablero de diseño. Si una carga de trabajo debe ejecutarse de forma continua, su diseño subyacente debe optimizarse para la eficiencia base y no para la capacidad de picos de demanda.
- Dimensionamiento correcto para los valores base: A diferencia de las aplicaciones web elásticas que necesitan margen para los picos de tráfico, los agentes continuos en segundo plano suelen consumir una cantidad de recursos predecible y constante. Perfila con cuidado tus cargas de trabajo persistentes para ajustarlas a tipos de instancia muy específicos en lugar de recurrir por defecto a niveles de propósito general.
- Desacopla el estado del cómputo: Mantén tus nodos de cómputo continuos sin estado siempre que sea posible. Al descargar los datos de sesión, los registros y las cachés de estado a un almacenamiento de objetos distribuido y de bajo coste o a capas de caché gestionadas, tus instancias de cómputo pasan a ser completamente desechables, lo que facilita migrarlas sobre la marcha a grupos de capacidad más baratos.
- Almacenamiento en búfer de eventos asíncrono: En lugar de hacer que los agentes siempre activos consulten directamente API externas o bases de datos en bucles cerrados, introduce colas de mensajes duraderas. Procesar las operaciones por lotes y de forma asíncrona evita un desperdicio innecesario de recursos y estabiliza el uso de la CPU.
Una lista de verificación práctica para optimizar los costes de la nube siempre activa
Implementar la responsabilidad financiera para las cargas de trabajo continuas requiere una rutina estructurada. Usa la siguiente lista de verificación para auditar tu infraestructura siempre activa y descubrir el desperdicio oculto:
- Comprométete con Savings Plans e instancias reservadas: Para cargas de trabajo que se ejecutarán con seguridad 24/7 durante el próximo año o tres, evita por completo los precios bajo demanda. Asegura la capacidad base mediante compromisos a largo plazo para reducir los costes de cómputo hasta un 40 % o más.
- Audita el tráfico de salida y de red: Los agentes siempre activos se comunican con frecuencia con servicios externos, bases de datos multirregión o endpoints de registro. Mapea tus rutas de transferencia de datos para eliminar los cargos por tráfico entre zonas de disponibilidad (AZ) y entre regiones que se acumulan silenciosamente con el tiempo.
- Implementa umbrales estrictos de observabilidad: Configura alertas de detección de anomalías que se activen no solo ante fallos evidentes, sino también ante el aumento gradual de recursos. Si la huella de memoria de un agente en segundo plano sube lentamente durante un periodo de 72 horas, tu herramienta de monitorización debería detectarlo antes de que fuerce una costosa ampliación de nodos.
- Aprovecha la capacidad spot y transitoria para tareas tolerantes a fallos: Incluso dentro de una arquitectura continua, ciertas subtareas (como la agregación de registros o la indexación periódica de datos) toleran interrupciones. Dirige estas tareas secundarias en segundo plano a instancias spot con mecanismos de respaldo automáticos.
Equilibrar la innovación con la gobernanza financiera
El impulso hacia sistemas en la nube más autónomos y siempre activos supone un gran salto adelante para la productividad de los desarrolladores y la capacidad de respuesta de los sistemas. Sin embargo, los líderes tecnológicos deben asegurarse de que la velocidad de ingeniería no supere a la gobernanza financiera. Al tratar la optimización de costes en la nube como una restricción arquitectónica y no como una ocurrencia tardía, los equipos pueden aprovechar todo el potencial de la infraestructura continua sin sufrir el shock presupuestario de fin de mes.
En última instancia, una arquitectura en la nube sostenible requiere una cultura en la que los desarrolladores comprendan las implicaciones financieras de que su código se ejecute las 24 horas del día. A medida que la automatización continua se convierte en la expectativa estándar del software moderno, alinear el diseño técnico con prácticas rigurosas de FinOps distinguirá a las organizaciones de ingeniería eficientes del resto.
More about always-on cloud
Want to go further with always-on cloud? These Netstech guides and services are a good next step:
- El cambio FinOps: por qué los agentes en la nube siempre activos exigen nuevas estrategias de optimización de costes
- Optimización de costes en la nube: estrategias FinOps para infraestructuras modernas
- Protegiendo la frontera de la IA: reducir los riesgos de exposición de datos en agentes autónomos en la nube
- AI services and automation