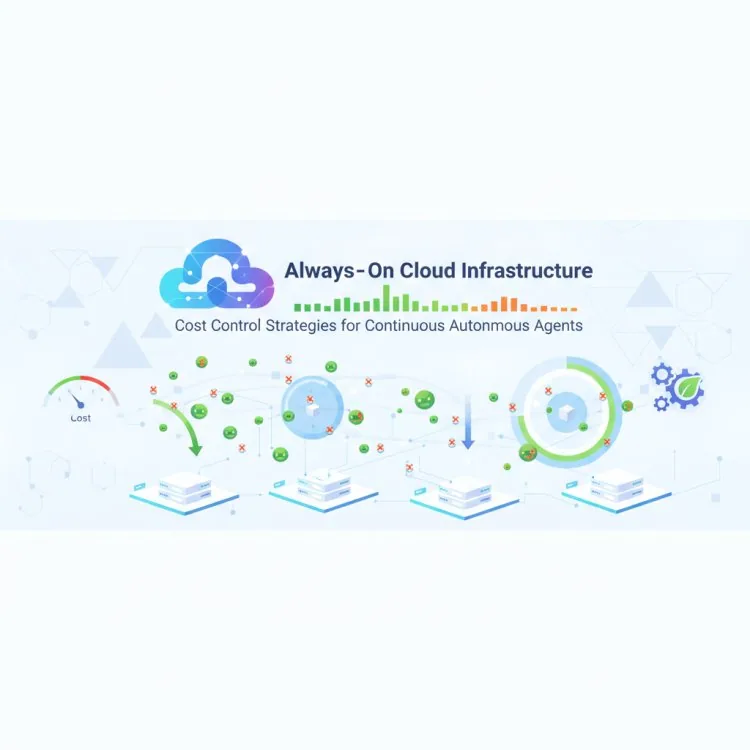
جدید کلاؤڈ منظرنامہ ایک خاموش، ساختی تبدیلی سے گزر رہا ہے۔ برسوں تک غالب آرکیٹیکچرل نمونہ ردعملی اور وقفہ وار تھا: کوئی واقعہ سرور لیس فنکشن چلاتا ہے، کوئی صارف ویب صفحہ مانگتا ہے، رات بھر بیچ جاب چلتی ہے، اور وسائل واپس صفر تک گھٹ جاتے ہیں۔ آج انجینئرنگ ٹیمیں تیزی سے ہمیشہ آن کلاؤڈ اجزا تعینات کر رہی ہیں، جن میں مسلسل مانیٹرنگ ایجنٹس اور مستقل بیک گراؤنڈ ڈیٹا پائپ لائنز سے لے کر چوبیس گھنٹے چلنے والے خودمختار معاون نظام شامل ہیں۔
اگرچہ یہ مستقل ورک لوڈز بے مثال ردعمل اور آٹومیشن کی صلاحیتیں پیش کرتے ہیں، لیکن یہ ایک سخت معاشی حقیقت بھی سامنے لاتے ہیں۔ جب انفراسٹرکچر 24/7 چلتا ہے تو روایتی آٹو اسکیلنگ منطق ناکام ہو جاتی ہے۔ جو وسیلہ مسلسل پروویژن رہتا ہے وہ اپنا ماہانہ بل کم کرنے کے لیے ٹریفک کی مختصر کمیوں پر انحصار نہیں کر سکتا۔ جیسے جیسے انجینئرنگ ٹیمیں ہمیشہ آن پیٹرنز کی طرف جا رہی ہیں، مسلسل کلاؤڈ لاگت کے انتظام میں مہارت ایک اچھی ہو تو بہتر آپٹیمائزیشن مشق سے بدل کر جدید IT اداروں کے لیے بقا کا بنیادی پیمانہ بن گئی ہے۔
ہمیشہ آن کلاؤڈ ورک لوڈز کی پوشیدہ معاشیات
جب کمپیوٹنگ انفراسٹرکچر آن ڈیمانڈ سے مستقل ماڈل کی طرف بڑھتا ہے تو حساب کتاب ڈرامائی طور پر بدل جاتا ہے۔ آن ڈیمانڈ ماڈل میں چند عروج کے گھنٹوں کے لیے سرور کو 20% زیادہ پروویژن کرنے کا مالی بوجھ معمولی ہوتا ہے۔ لیکن اسی 20% بفر کو مہینے کے 720 گھنٹوں تک پھیلائیں تو ضیاع کئی گنا بڑھ جاتا ہے۔
مزید یہ کہ ہمیشہ آن آرکیٹیکچرز کو اکثر مستقل اسٹیٹ مینجمنٹ، مسلسل نیٹ ورک پولنگ اور بیک گراؤنڈ سنکرونائزیشن کاموں کی ضرورت ہوتی ہے۔ یہ آپریشنز CPU، میموری اور ایگریس بینڈوتھ کی مستقل مقدار صرف کرتے ہیں۔ سوچے سمجھے آرکیٹیکچرل حفاظتی حدود کے بغیر، ٹیمیں اکثر پاتی ہیں کہ مسلسل بیک گراؤنڈ آٹومیشن کی آپریشنل سہولت کا جواب ان کے ماہانہ کلاؤڈ بل میں اچانک، غیر متوقع اضافہ ہوتا ہے۔
بجٹ کو نقصان پہنچائے بغیر مسلسل انفراسٹرکچر کے فوائد حاصل کرنے کے لیے انجینئرنگ اور FinOps ٹیموں کو دو رخی طریقہ اپنانا ہوگا: استقلال کو مؤثر طریقے سے سنبھالنے کے لیے بنیادی آرکیٹیکچرل پیٹرنز کو بہتر بنانا، اور وسائل کی سخت گورننس نافذ کرنا۔
مؤثر مستقل انفراسٹرکچر کے لیے آرکیٹیکچرل پیٹرنز
ہمیشہ آن کلاؤڈ سسٹمز کی آپٹیمائزیشن ڈرائنگ بورڈ سے شروع ہوتی ہے۔ اگر کوئی ورک لوڈ مسلسل چلنا ضروری ہے تو اس کے بنیادی ڈیزائن کو عروج کی صلاحیت کے بجائے بنیادی کارکردگی کے لیے آپٹیمائز کیا جانا چاہیے۔
- بیس لائنز کے لیے درست سائزنگ: ٹریفک کے اتار چڑھاؤ کے لیے گنجائش مانگنے والی لچکدار ویب ایپس کے برعکس، مسلسل بیک گراؤنڈ ایجنٹس اکثر وسائل کی قابلِ پیش گوئی، یکساں مقدار صرف کرتے ہیں۔ اپنے مستقل ورک لوڈز کو احتیاط سے پروفائل کریں تاکہ انہیں جنرل پرپز درجوں پر ڈیفالٹ کرنے کے بجائے انتہائی مخصوص انسٹینس اقسام کے ساتھ ملایا جا سکے۔
- اسٹیٹ کو کمپیوٹ سے الگ کرنا: جہاں ممکن ہو اپنے مسلسل کمپیوٹ نوڈس کو اسٹیٹ لیس رکھیں۔ سیشن ڈیٹا، لاگز اور اسٹیٹ کیشز کو ڈسٹری بیوٹڈ، کم لاگت آبجیکٹ اسٹوریج یا منیجڈ کیشنگ پرتوں پر منتقل کر کے، آپ کے کمپیوٹ انسٹینسز مکمل طور پر ڈسپوزیبل ہو جاتے ہیں، جس سے انہیں چلتے چلتے سستے کیپیسٹی پولز پر منتقل کرنا آسان ہو جاتا ہے۔
- غیر ہم وقت ایونٹ بفرنگ: ہمیشہ آن ایجنٹس سے سخت لوپس میں براہِ راست بیرونی APIs یا ڈیٹا بیسز کو پول کروانے کے بجائے پائیدار میسج کیوز متعارف کرائیں۔ آپریشنز کو بیچ کرنا اور انہیں غیر ہم وقت طور پر پروسیس کرنا غیر ضروری وسائل کی کھینچا تانی روکتا ہے اور CPU کے استعمال کو مستحکم کرتا ہے۔
ہمیشہ آن کلاؤڈ لاگت کی آپٹیمائزیشن کے لیے ایک عملی چیک لسٹ
مسلسل ورک لوڈز کے لیے مالی احتساب نافذ کرنے کے لیے منظم معمول ضروری ہے۔ اپنے ہمیشہ آن انفراسٹرکچر کا آڈٹ کرنے اور پوشیدہ ضیاع دریافت کرنے کے لیے درج ذیل چیک لسٹ استعمال کریں:
- سیونگز پلانز اور ریزروڈ انسٹینسز اپنائیں: جن ورک لوڈز کا اگلے ایک یا تین برس تک 24/7 چلنا یقینی ہے ان کے لیے آن ڈیمانڈ قیمتوں سے مکمل گریز کریں۔ طویل مدتی وعدوں کے ذریعے بنیادی گنجائش مقرر کریں تاکہ کمپیوٹ لاگت 40% یا اس سے زیادہ تک کم ہو جائے۔
- ایگریس اور نیٹ ورک ٹریفک کا آڈٹ کریں: ہمیشہ آن ایجنٹس اکثر بیرونی سروسز، ملٹی ریجن ڈیٹا بیسز یا لاگنگ اینڈ پوائنٹس سے رابطہ کرتے ہیں۔ اپنے ڈیٹا ٹرانسفر راستوں کا نقشہ بنائیں تاکہ کراس AZ (ایویلیبلٹی زون) اور کراس ریجن ٹریفک چارجز ختم ہوں جو وقت کے ساتھ خاموشی سے جمع ہوتے رہتے ہیں۔
- سخت آبزرویبلٹی حدیں نافذ کریں: ایسے اینوملی ڈیٹیکشن الرٹس ترتیب دیں جو صرف سراسر ناکامیوں پر نہیں بلکہ وسائل کے بتدریج بڑھنے پر بھی فعال ہوں۔ اگر کسی بیک گراؤنڈ ایجنٹ کی میموری کا استعمال 72 گھنٹوں میں آہستہ آہستہ اوپر جائے تو آپ کے مانیٹرنگ ٹول کو یہ مہنگے نوڈ اپ گریڈ کی نوبت آنے سے پہلے پکڑ لینا چاہیے۔
- خرابی برداشت کرنے والے کاموں کے لیے اسپاٹ اور عارضی گنجائش سے فائدہ اٹھائیں: مسلسل آرکیٹیکچر کے اندر بھی کچھ ذیلی کام (جیسے لاگ ایگریگیشن یا وقفہ وار ڈیٹا انڈیکسنگ) رکاوٹیں برداشت کر سکتے ہیں۔ ان ثانوی بیک گراؤنڈ کاموں کو خودکار متبادل میکانزم کے ساتھ اسپاٹ انسٹینسز پر بھیجیں۔
جدت اور مالی گورننس میں توازن
زیادہ خودمختار، ہمیشہ آن کلاؤڈ سسٹمز کی طرف پیش قدمی ڈویلپر پیداواریت اور سسٹم کے ردعمل میں ایک بڑی چھلانگ ہے۔ تاہم، ٹیکنالوجی لیڈرز کو یقینی بنانا چاہیے کہ انجینئرنگ کی رفتار مالی گورننس سے آگے نہ نکل جائے۔ کلاؤڈ لاگت کی آپٹیمائزیشن کو بعد کی سوچ کے بجائے آرکیٹیکچرل پابندی سمجھ کر، ٹیمیں مہینے کے اختتام پر بجٹ کے جھٹکے کے بغیر مسلسل انفراسٹرکچر کی پوری صلاحیت سے فائدہ اٹھا سکتی ہیں۔
بالآخر، پائیدار کلاؤڈ آرکیٹیکچر ایسے کلچر کا تقاضا کرتا ہے جس میں ڈویلپرز چوبیس گھنٹے چلنے والے اپنے کوڈ کے مالی مضمرات کو سمجھیں۔ جیسے جیسے مسلسل آٹومیشن جدید سافٹ ویئر کی معیاری توقع بنتی ہے، تکنیکی ڈیزائن کو سخت FinOps طریقوں کے ساتھ ہم آہنگ کرنا مؤثر انجینئرنگ اداروں کو باقیوں سے ممتاز کرے گا۔
More about always-on cloud
Want to go further with always-on cloud? These Netstech guides and services are a good next step: