
引言:
机器学习是机器从先前数据中学习,然后基于所学内容对未来做出预测的过程。有时需要少量的人工参与,有时则完全不需要人工介入。监督学习的根本缺点是,它要求数据科学家聘请机器学习专家,这是一种成本高昂的做法。半监督机器学习的出现正是为了解决这一缺陷。想象一下,您能够利用机器学习预测并判断公司未来的收入。
什么是半监督学习?
半监督学习是一种介于监督学习和无监督学习之间的机器学习类型。少量已分类数据与大量未标记数据的结合称为半监督学习。它结合了监督学习和无监督学习两者的优点。
半监督学习是如何工作的?
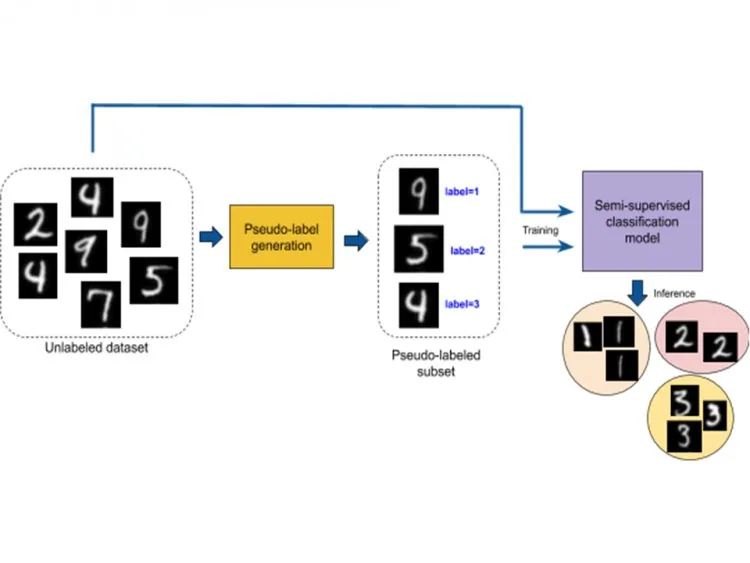
与监督学习不同,半监督学习采用伪标签,使用较少的已标记训练数据来训练模型。在此过程中可以结合各种神经网络模型和训练方法。以下几点将说明半监督学习的工作原理:
- 首先,它使用比监督学习模型更少的训练数据来训练模型。模型会一直训练,直到产生正确的结果。
- 在下一阶段,算法使用带有伪标签的未标记数据集,此时输出可能不再正确。
- 伪标签数据现在与来自已标记训练数据的标签相连接。
- 此外,未标记训练数据中的输入数据也被连接起来。
- 最后,与上一阶段一样,使用新合并的输入重新训练模型。这将减少错误并提高模型的准确性。[1]
半监督学习的例子是什么?
语音分析
这是半监督学习最著名的应用。由于对音频数据进行分类是需要大量人力的最困难的操作,因此在半监督学习模型中使用 SSL 可以自然地解决这个问题。
网页内容分类
然而,对互联网上的每个页面进行标记极其重要且困难,因为这需要大量的人工交互。即便如此,使用半监督学习算法,这个问题仍可以得到缓解。
此外,Google 使用半监督学习算法针对特定查询对网页进行排名。
蛋白质序列分类
由于 DNA 链更长,因此需要大量人工参与。在该领域,半监督模型的出现已近在眼前。
半监督学习有哪些类型?
以下是机器学习的类型
- 归纳式学习
归纳学习的目的是推广到新数据。因此,归纳学习是创建一种学习算法的过程,该算法从已标记的训练集中学习,然后推广到新数据。
- 直推式学习
直推式学习的目的,是将已标注训练数据集中的知识迁移到现成可用的未标注(训练)数据上。
半监督学习有哪些优点?
- 它易于理解。
- 它减少了所需标注数据的数量。
- 它是一种稳定的算法。
- 它很简单。
- 它具有很高的能力。
半监督学习有哪些缺点?
- 迭代结果不稳定。
- 它不适用于网络级数据。
- 正确性较低。
结论:
在半监督学习中,您既可以使用已标注数据,也可以使用未标注数据作为训练数据。可根据企业的需求和偏好选用机器学习方法,同时兼顾每种学习方法的优缺点。
More about semi-supervised learning
Want to go further with semi-supervised learning? These Netstech guides and services are a good next step:


