
परिचय:
मशीन लर्निंग वह प्रक्रिया है जिसके ज़रिए मशीन पिछले डेटा से सीखती है और फिर उस सीख के आधार पर भविष्य के बारे में पूर्वानुमान लगाती है। कभी-कभी थोड़ी मानवीय भागीदारी की आवश्यकता होती है, जबकि कभी-कभी किसी मानवीय भागीदारी की आवश्यकता नहीं होती। सुपरवाइज़्ड लर्निंग का मूल नुकसान यह है कि इसमें डेटा साइंटिस्ट की ओर से एक ML विशेषज्ञ की आवश्यकता होती है, जो एक महँगी तकनीक है। इस कमी को दूर करने के लिए सेमी-सुपरवाइज़्ड मशीन लर्निंग पेश की गई। कल्पना कीजिए कि आप मशीन लर्निंग का उपयोग करके अपनी कंपनी की भावी आय का पूर्वानुमान लगा सकें और उस पर निर्णय ले सकें।
सेमी-सुपरवाइज़्ड लर्निंग क्या है?
सेमी-सुपरवाइज़्ड लर्निंग मशीन लर्निंग का वह प्रकार है जो सुपरवाइज़्ड और अनसुपरवाइज़्ड के बीच आता है। थोड़ी मात्रा के वर्गीकृत डेटा और बड़ी मात्रा के बिना लेबल वाले डेटा के संयोजन को सेमी-सुपरवाइज़्ड लर्निंग कहते हैं। यह सुपरवाइज़्ड और अनियंत्रित लर्निंग दोनों के फ़ायदों को जोड़ती है।
सेमी-सुपरवाइज़्ड लर्निंग कैसे काम करती है?
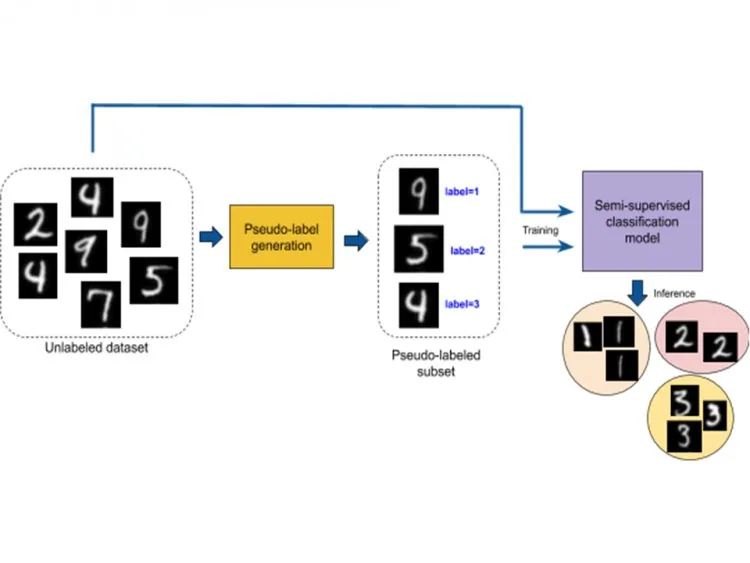
सुपरवाइज़्ड लर्निंग के विपरीत, सेमी-सुपरवाइज़्ड लर्निंग कम लेबल वाले प्रशिक्षण डेटा से मॉडल को प्रशिक्षित करने के लिए छद्म लेबलिंग का उपयोग करती है। इस प्रक्रिया में विभिन्न न्यूरल नेटवर्क मॉडल और प्रशिक्षण विधियों को जोड़ा जा सकता है। निम्नलिखित बिंदु दर्शाएँगे कि सेमी-सुपरवाइज़्ड लर्निंग कैसे काम करती है:
- सबसे पहले, यह सुपरवाइज़्ड लर्निंग मॉडलों की तुलना में कम मात्रा के प्रशिक्षण डेटा से मॉडल को प्रशिक्षित करती है। मॉडल को तब तक प्रशिक्षित किया जाता है जब तक वह सही नतीजे न देने लगे।
- अगले चरण में, एल्गोरिदम छद्म लेबल वाले बिना लेबल के डेटासेट का उपयोग करते हैं, और आउटपुट अब सही नहीं भी हो सकता है।
- अब छद्म लेबल वाला डेटा और लेबल किए गए प्रशिक्षण डेटा के लेबल आपस में जुड़ जाते हैं।
- इसके अलावा, बिना लेबल वाले प्रशिक्षण डेटा में इनपुट डेटा भी जुड़े होते हैं।
- अंत में, पिछले चरण की तरह, नए संयुक्त इनपुट के साथ मॉडल को फिर से प्रशिक्षित करें। इससे गलतियाँ घटेंगी और मॉडल की सटीकता बढ़ेगी।[1]
सेमी-सुपरवाइज़्ड लर्निंग का उदाहरण क्या है?
वाक् विश्लेषण
यह सेमी-सुपरवाइज़्ड लर्निंग का सबसे प्रसिद्ध उपयोग है। क्योंकि ऑडियो डेटा को वर्गीकृत करना सबसे कठिन कार्य है जिसमें बड़ी संख्या में मानव संसाधनों की आवश्यकता होती है, इस समस्या को सेमी-सुपरवाइज़्ड लर्निंग मॉडल में SSL का उपयोग करके स्वाभाविक रूप से हल किया जा सकता है।
वेब सामग्री वर्गीकरण
हालाँकि, इंटरनेट पर हर पेज को लेबल करना अत्यंत महत्वपूर्ण और कठिन है क्योंकि इसमें भारी मानवीय संपर्क की आवश्यकता होती है। फिर भी, सेमी-सुपरवाइज़्ड लर्निंग एल्गोरिदम का उपयोग करके इस समस्या को कम किया जा सकता है।
इसके अलावा, Google किसी विशेष क्वेरी के लिए वेबपेज की रैंकिंग तय करने हेतु सेमी-सुपरवाइज़्ड लर्निंग एल्गोरिदम का उपयोग करता है।
प्रोटीन अनुक्रम वर्गीकरण
क्योंकि DNA की लड़ियाँ लंबी होती हैं, इसलिए महत्वपूर्ण मानवीय भागीदारी आवश्यक होती है। इस क्षेत्र में सेमी-सुपरवाइज़्ड मॉडल का उदय निकट रहा है।
सेमी-सुपरवाइज़्ड लर्निंग के प्रकार क्या हैं?
मशीन लर्निंग के प्रकार निम्नलिखित हैं
- इंडक्शन के ज़रिए सीखना
इंडक्टिव लर्निंग का उद्देश्य नए डेटा पर सामान्यीकरण करना है। इसलिए, इंडक्टिव लर्निंग एक ऐसा लर्निंग एल्गोरिदम बनाने की प्रक्रिया है जो लेबल किए गए प्रशिक्षण सेट से सीखता है और फिर नए डेटा पर सामान्यीकरण करता है।
- ट्रांसडक्टिव तरीके से सीखना
ट्रांसडक्टिव लर्निंग का उद्देश्य लेबल किए गए प्रशिक्षण डेटासेट के ज्ञान को आसानी से उपलब्ध बिना लेबल वाले (प्रशिक्षण) डेटा में बदलना है।
सेमी-सुपरवाइज़्ड लर्निंग के फ़ायदे क्या हैं?
- इसे समझना आसान है।
- यह उपयोग किए जाने वाले एनोटेट डेटा की मात्रा को घटाती है।
- यह एक स्थिर एल्गोरिदम है।
- यह सरल है।
- इसकी क्षमता उच्च है।
सेमी-सुपरवाइज़्ड लर्निंग के नुकसान क्या हैं?
- पुनरावृत्ति के नतीजे स्थिर नहीं होते।
- यह नेटवर्क-स्तर के डेटा पर लागू नहीं होती।
- इसकी सटीकता कम है।
निष्कर्ष:
सेमी-सुपरवाइज़्ड लर्निंग में आप प्रशिक्षण डेटा के रूप में लेबल किए गए या बिना लेबल वाले, दोनों में से किसी भी डेटा का उपयोग कर सकते हैं। प्रत्येक लर्निंग विधि के फ़ायदों और नुकसानों को ध्यान में रखते हुए, व्यवसाय की ज़रूरतों और प्राथमिकताओं के आधार पर मशीन लर्निंग का उपयोग किया जा सकता है।
- Introduction to Semi-Supervised Learning. यहाँ उपलब्ध: https://www.javatpoint.com/semi-supervised-learning.
More about semi-supervised learning
Want to go further with semi-supervised learning? These Netstech guides and services are a good next step:


