
सुपरवाइज़्ड लर्निंग, जिसे सुपरवाइज़्ड मशीन लर्निंग भी कहा जाता है, मशीन लर्निंग और आर्टिफ़िशियल इंटेलिजेंस की एक उपश्रेणी है
परिचय:
समय बीतने के साथ, मनुष्य अपने अनुभव से सीखते हैं और उस अनुभव के आधार पर निर्णय लेते हैं। मशीन लर्निंग के काम करने के तरीके की तरह, पिछले रिकॉर्ड से पैटर्न और एल्गोरिदम का उपयोग करके कंप्यूटर सीख और ढल सकता है। आपका कंप्यूटर स्पष्ट निर्देशों के बिना पहले के डेटा का विश्लेषण करके निष्कर्ष निकालता है और मौजूदा रिकॉर्ड की नींव पर भावी नतीजों का अनुमान लगाता है।
मशीन लर्निंग क्या है?
मशीन लर्निंग डेटा जाँच की एक श्रेणी है जो नैदानिक मॉडलों के निर्माण को स्वचालित करती है। यह एक ऐसी प्रणाली है जो डेटा से जानकारी निकाल सकती है, पैटर्न की पहचान कर सकती है और बहुत कम या बिना मानवीय हस्तक्षेप के निष्कर्ष निकाल सकती है। आर्टिफ़िशियल इंटेलिजेंस के उपयोग की बदौलत यह प्रणाली स्पष्ट रूप से कोड किए बिना सीखने और विकसित होने में सक्षम है।
सुपरवाइज़्ड लर्निंग क्या है?
आर्टिफ़िशियल इंटेलिजेंस सुपरवाइज़्ड लर्निंग के ज़रिए बनाई जाती है। इस विधि में, किसी निश्चित नतीजे के लिए कंप्यूटर के एल्गोरिदम को (उचित रूप से लेबल किया हुआ) डेटा खिलाकर प्रशिक्षित किया जाता है। डेटा तब तक प्रशिक्षित किया जाता है जब तक वह पैटर्न पहचानने और इनपुट डेटा तथा आउटपुट लेबल के बीच संबंध निर्धारित करने में सक्षम न हो जाए। हम इसका उपयोग किसी दिए गए लेबल के लिए सटीक परिणाम निर्धारित करने में कर सकते हैं।
सुपरवाइज़्ड लर्निंग के कुछ उदाहरण क्या हैं?
संक्षेप में, सुपरवाइज़्ड लर्निंग वह है जब हमारे पास एक शिक्षक होता है जो अच्छी तरह लेबल किए गए डेटा का उपयोग करके मशीन को प्रशिक्षित करता है। सुपरवाइज़्ड लर्निंग विधि के उपयोग से, कंप्यूटर को प्रशिक्षण डेटा (प्रशिक्षण या तैयारी के उदाहरणों का सेट) का विश्लेषण करने और लेबल किए गए डेटा से उपयुक्त नतीजा बनाने के लिए उदाहरणों (डेटा) का एक नया समूह या संख्या दी जाती है।
सुपरवाइज़्ड लर्निंग कैसे काम करती है?
सुपरवाइज़्ड लर्निंग में, हम लेबल किए गए डेटा सेट का उपयोग करके मॉडल को प्रशिक्षित करते हैं। मॉडल को हर प्रकार के डेटा के अनुसार प्रशिक्षित किया जाता है। प्रशिक्षण प्रक्रिया पूरी होने पर, हम प्रशिक्षित मॉडल को टेस्ट डेटा से परखते हैं। पिछले प्रशिक्षण के आधार पर, मशीन आउटपुट का पूर्वानुमान लगाती है।
मान लें कि हमारे पास ऐसा डेटासेट है जिसमें त्रिभुजों के विविध रूप हैं, जैसे वर्ग, आयत और बहुभुज। क्लासिकल मॉडल को शुरुआती चरण के रूप में हर आकार के लिए प्रशिक्षित करना होगा।
- यदि किसी आकार में चार सिरे या कोने हों और वे सभी बराबर हों, तो वह वर्ग माना जाता है।
- यदि पूरी प्रक्रिया में तीन भुजाएँ हों, तो उसे त्रिभुज के रूप में लेबल किया जाएगा।
- जब दर्ज किए गए आकार की छह भुजाएँ बराबर हों, तो वह षट्भुज माना जाता है।
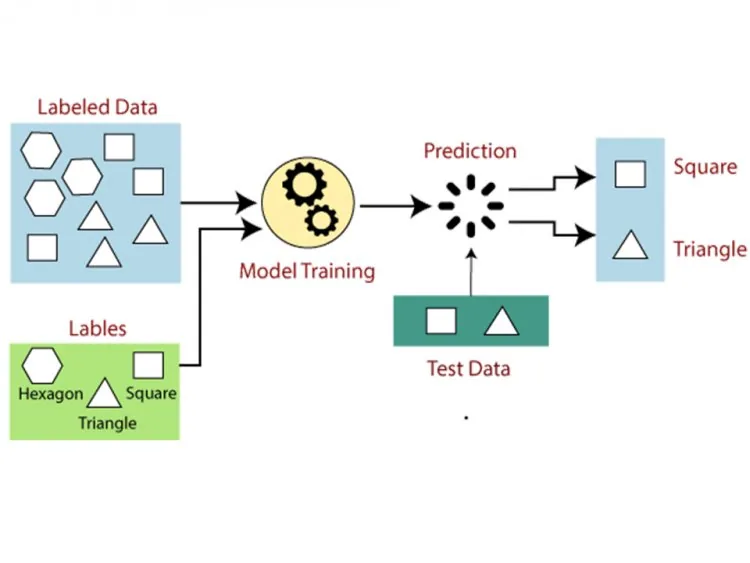
प्रशिक्षण के बाद, हम अपने मॉडल को परखने के लिए टेस्ट सेट का उपयोग करते हैं, और मॉडल का लक्ष्य आकार को पहचानना है।
सिस्टम को पहले से कई रूपों में सिखाया जा चुका है, और जब उसे कोई नया रूप मिलता है, तो वह उसे वर्गीकृत कर देता है।[1]
मशीन लर्निंग में कौन-से चरण शामिल हैं?
- सबसे पहले, तय करें कि आप किस प्रकार के प्रशिक्षण डेटासेट का उपयोग करेंगे।
- टैग किए गए प्रशिक्षण डेटा को इकट्ठा और संग्रहित करके प्राप्त करें।
- प्रशिक्षण डेटासेट को तीन भागों में बाँटें: प्रशिक्षण, परीक्षण और सत्यापन।
- प्रशिक्षण डेटासेट की इनपुट विशेषताएँ निर्धारित करें, जिनमें मॉडल द्वारा आउटपुट का सफलतापूर्वक पूर्वानुमान लगाने के लिए पर्याप्त जानकारी होनी चाहिए।
- मॉडल के लिए उपयुक्त एल्गोरिदम चुनें, जैसे सपोर्ट वेक्टर मशीन या डिसीज़न ट्री।
- एल्गोरिदम चलाने के लिए प्रशिक्षण डेटासेट का अभ्यास करें। वैलिडेशन सेट, जो प्रशिक्षण डेटासेट का एक उपसमूह होते हैं, कभी-कभी नियामक या नियंत्रण पैरामीटर के रूप में आवश्यक होते हैं।
- टेस्ट सेट देकर आप मॉडल की सटीकता का आकलन कर सकते हैं। यदि मॉडल नतीजे का सही पूर्वानुमान लगाता है, तो हमारा मॉडल सटीक है।
सुपरवाइज़्ड लर्निंग की श्रेणियाँ क्या हैं?
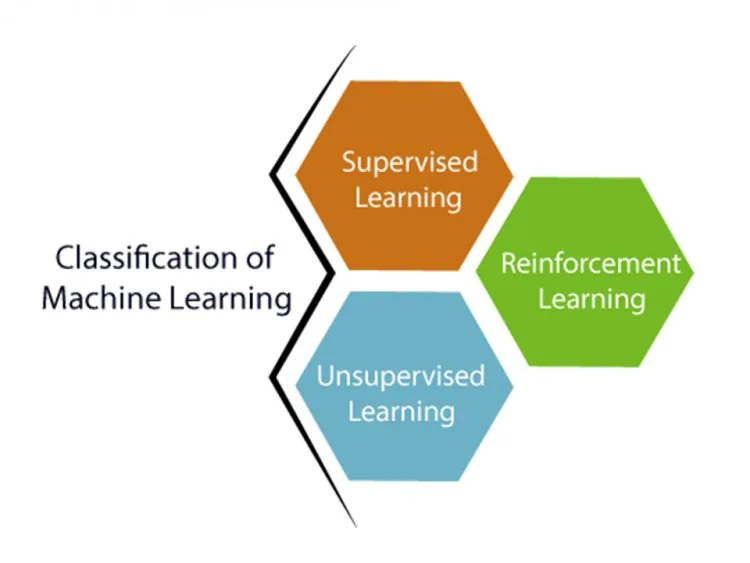
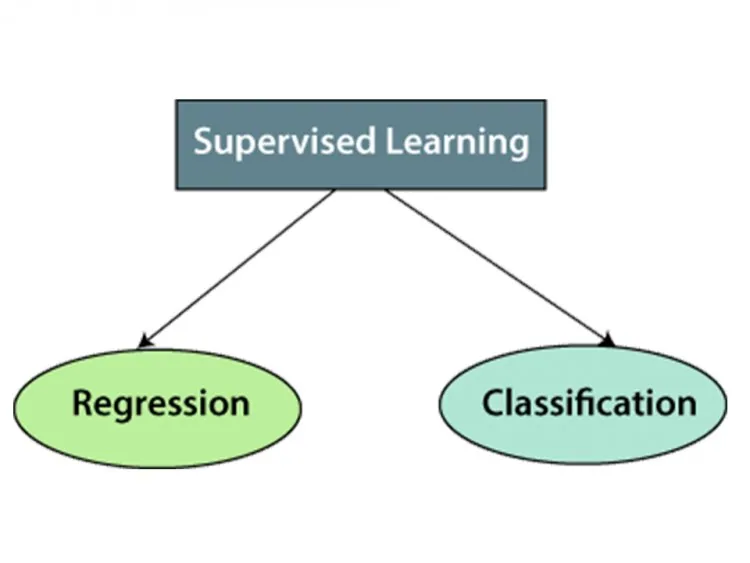
सुपरवाइज़्ड लर्निंग की निम्नलिखित श्रेणियाँ हैं।
- रिग्रेशन
- वर्गीकरण
सुपरवाइज़्ड लर्निंग के फ़ायदे क्या हैं?
- प्रशिक्षण डेटा में आपको अवधियों की विस्तृत राय मिलेगी।
- आपको समझ पाना चाहिए कि सुपरवाइज़्ड लर्निंग तंत्र कैसे काम करता है। जब बात अनसुपरवाइज़्ड लर्निंग की आती है, तो हमें हमेशा पता नहीं होता कि मशीन के भीतर क्या चल रहा है, यह कैसे सीख रही है, इत्यादि।
- प्रशिक्षण के लिए डेटा देने से पहले, आप कक्षाओं की विस्तृत संख्या को नियंत्रित कर सकते हैं।
- आप कक्षाओं के अर्थ के बारे में वास्तव में सटीक हो सकते हैं, यानी आप क्लासिफ़ायर को इस तरह प्रशिक्षित कर सकते हैं कि उसकी निर्णय सीमा त्रुटिहीन हो और वह अलग-अलग कक्षाओं के बीच भरोसेमंद तरीके से अंतर कर सके।
- एक बार पूरा प्रोग्राम पूरा हो जाने पर आपको प्रशिक्षण डेटा को अपनी याददाश्त में रखने की आवश्यकता नहीं होती। इसके बजाय, आप निर्णय सीमाओं को बनाए रखने के लिए एक गणितीय सूत्र का उपयोग कर सकते हैं।[2]
सुपरवाइज़्ड लर्निंग के नुकसान क्या हैं?
- कई मायनों में, सुपरवाइज़्ड लर्निंग अप्राकृतिक है, और यह मशीन लर्निंग के कुछ अधिक जटिल कार्य हासिल नहीं कर सकती।
- अनसुपरवाइज़्ड लर्निंग के विपरीत, सुपरवाइज़्ड लर्निंग प्रशिक्षण डेटा से अज्ञात जानकारी नहीं निकाल सकती।
- अनसुपरवाइज़्ड लर्निंग से भिन्न; यह डेटा की विशेषताओं को खुद निर्धारित करके उसे क्लस्टर या वर्गीकृत नहीं कर सकती।
- वर्गीकरण की बात आने पर, यदि हम ऐसा इनपुट देते हैं जो प्रशिक्षण डेटा की किसी भी क्लास से नहीं है, तो नतीजा गलत क्लास लेबल हो सकता है। मान लीजिए आपने इमेज क्लासिफ़ायर को प्रशिक्षित करने के लिए बिल्लियों और कुत्तों के डेटा का उपयोग किया। यदि आप जिराफ़ की इमेज देते हैं, तो नतीजा बिल्ली या कुत्ता हो सकता है, जो गलत है।
- मान लीजिए आपके प्रशिक्षण सेट में कुछ उदाहरण नहीं हैं और आप एक पाठ जोड़ना चाहते हैं। तब, सीखने के बाद, जब आप उन नमूनों का उपयोग करेंगे तो हो सकता है कि आपको इनपुट के रूप में सही क्लास लेबल न मिले।
निष्कर्ष:
सुपरवाइज़्ड लर्निंग वर्गीकरण और रिग्रेशन समस्याओं में उत्कृष्ट है, जैसे किसी समाचार लेख की श्रेणी तय करना या भविष्य की किसी तारीख के लिए लेन-देन की संख्या का पूर्वानुमान लगाना। सुपरवाइज़्ड प्रक्रिया का लक्ष्य किसी विशिष्ट समस्या के संदर्भ में डेटा का अर्थ सीखना है।
- Supervised Machine Learning. यहाँ उपलब्ध: https://www.javatpoint.com/supervised-machine-learning.
- Petersson, D.supervised learning. यहाँ उपलब्ध: https://www.techtarget.com/searchenterpriseai/definition/supervised-learning.
सुपरवाइज़्ड लर्निंग के दो मुख्य प्रकार
- वर्गीकरण: किसी श्रेणी का पूर्वानुमान लगाना, जैसे स्पैम या गैर-स्पैम, या कोई लेन-देन फ़्रॉड है या नहीं।
- रिग्रेशन: किसी संख्या का पूर्वानुमान लगाना, जैसे मकान की कीमत या अगले महीने की बिक्री।
आम एल्गोरिदम
लीनियर और लॉजिस्टिक रिग्रेशन, डिसीज़न ट्री, रैंडम फ़ॉरेस्ट, सपोर्ट वेक्टर मशीन, k-नियरेस्ट नेबर्स और न्यूरल नेटवर्क।
एक सरल उदाहरण
यह अनुमान लगाने के लिए कि कोई ग्राहक किस्त देर से चुकाएगा या नहीं, आप उन पिछले ग्राहकों पर मॉडल को प्रशिक्षित करते हैं जिनका नतीजा ज्ञात है (समय पर चुकाया या देर से), आय श्रेणी, अग्रिम भुगतान और पिछले व्यवहार जैसी विशेषताओं का उपयोग करके। फिर मॉडल नए ग्राहकों को स्कोर करता है। Installment Management System जैसे किस्त प्रबंधन टूल में ठीक इसी तरह का डेटा होता है।
ताकत और सीमाएँ
जब आपके पास अच्छा लेबल किया हुआ डेटा हो तो सुपरवाइज़्ड लर्निंग सटीक होती है, लेकिन लेबलिंग महँगी है और मॉडल केवल वही सीखता है जो लेबल दिखाते हैं। इसकी तुलना अनसुपरवाइज़्ड लर्निंग और रिइन्फ़ोर्समेंट लर्निंग से करें।
त्वरित उत्तर
ओवरफ़िटिंग क्या है?
ओवरफ़िटिंग तब होती है जब कोई मॉडल प्रशिक्षण डेटा को रट लेता है और नए डेटा पर खराब प्रदर्शन करता है। इसे अधिक डेटा, सरल मॉडल और वैलिडेशन से घटाया जाता है।


