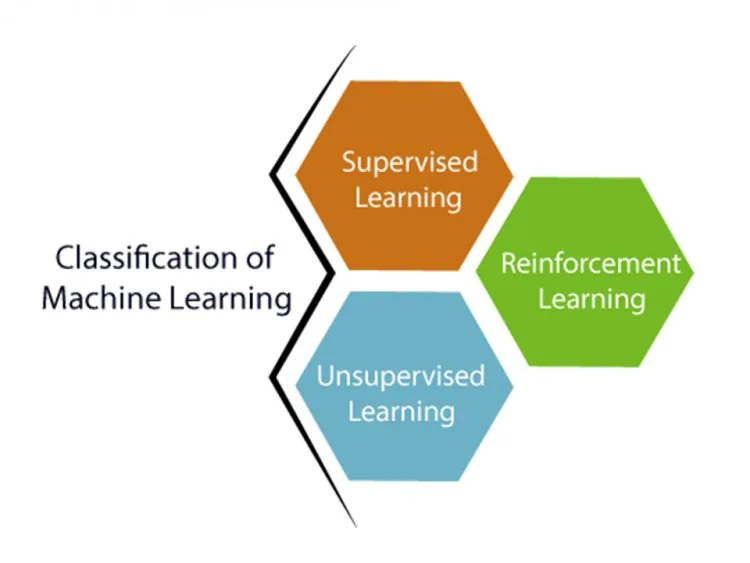
监督学习,也称为监督式机器学习,是机器学习和人工智能的一个子类别
引言:
随着时间推移,人类从经验中学习,并根据这些经验做出决策。与机器学习的工作方式类似,计算机可以利用以往记录中的模式和算法进行学习和适应。计算机在没有明确指示的情况下分析并推断以往数据,并基于现有记录预测未来结果。
什么是机器学习?
机器学习是一类数据分析方法,可自动构建诊断模型。它是一个能够从数据中提取信息、识别模式并几乎无需人为干预就得出结论的系统。借助人工智能,该系统无需明确编码即可学习和进化。
什么是监督学习?
人工智能是通过监督学习创建的。在这种方法中,通过向计算机算法输入(已恰当标注的)数据来训练它得出特定结果。数据会不断训练,直到它能够识别模式并确定输入数据与输出标签之间的联系。我们可以据此确定给定标签对应的确切输出。
监督学习有哪些示例?
简而言之,监督学习就是由一位“老师”用标注良好的数据来训练机器。通过监督学习方法,计算机会拿到一组新的示例(数据)来分析训练数据(训练或准备示例的集合),并从已标注数据中得出恰当的结果。
监督学习是如何工作的?
在监督学习中,我们使用已标注数据集训练模型。模型根据每种类型的数据进行训练。训练完成后,我们用测试数据来测试训练好的模型。机器会基于之前的训练来预测输出。
假设我们有一个包含多种形状三角形、正方形、矩形和多边形的数据集。传统方法目前必须在初始阶段针对每种形状分别训练。
- 如果某个形状有四条边或四个角,并且它们全都相等,则它属于正方形。
- 如果整个图形有三条边,就会被标记为三角形。
- 当输入的形状有六条相等的边时,它就属于六边形。
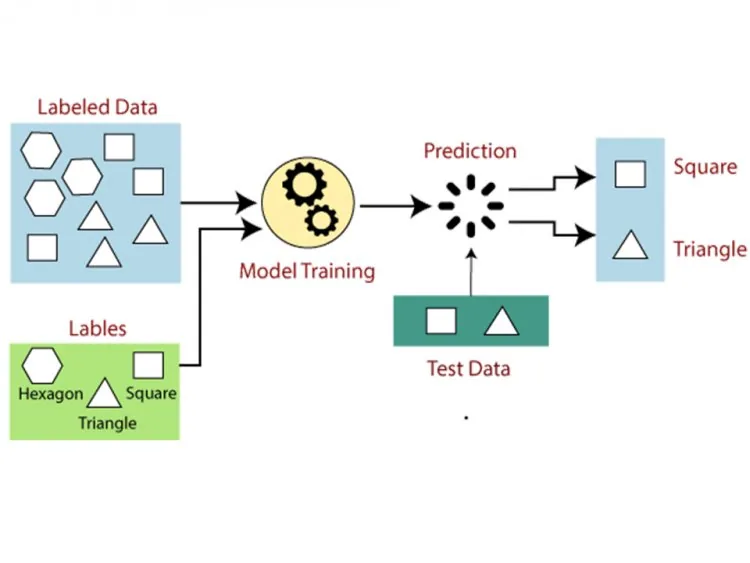
训练之后,我们使用测试集来检验模型,模型的目标是识别出形状。
系统之前已经学习过多种形状,当发现新的形状时,就会对其进行归类。[1]
机器学习包含哪些步骤?
- 首先,确定您将要使用的训练数据集的类型。
- 通过收集和汇总来获取带标签的训练数据。
- 将训练数据集分为三部分:训练集、测试集和验证集。
- 确定训练数据集的输入特征,这些特征应包含足够的信息,使模型能够成功预测输出。
- 为模型选择合适的算法,例如支持向量机或决策树。
- 使用训练数据集来运行算法。验证集是训练数据集的子集,有时需要用作调节器或控制参数。
- 通过提供测试集,您可以评估模型的正确性。如果模型正确预测了结果,那么我们的模型就是准确的。
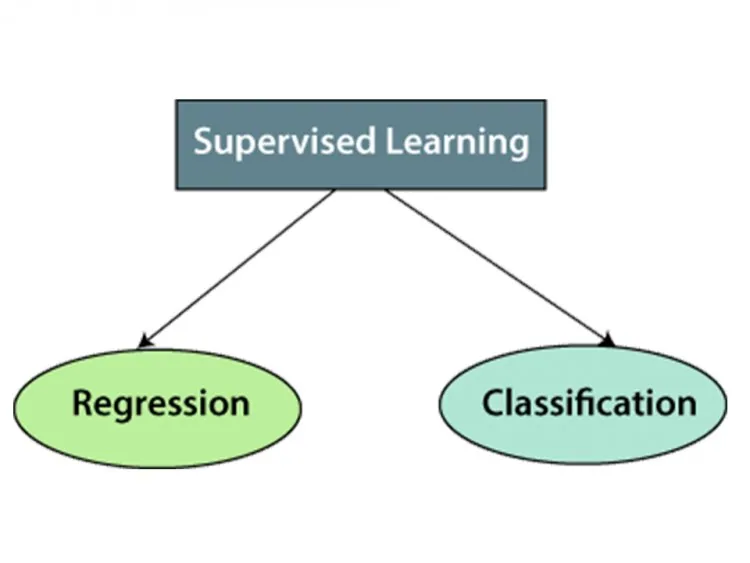
监督学习有哪些类别?
以下是监督学习所包含的类别。
- 回归
- 分类
监督学习有哪些优点?
- 在训练数据中,您会对各个时期有详细的了解。
- 您应该能够理解监督学习的机制。而说到无监督学习,我们并不总能清楚机器内部在做什么、它是如何学习的,等等。
- 在使用数据进行训练之前,您可以控制类别的具体数量。
- 您可以对类别的含义非常明确,也就是说,您可以以这样的方式训练分类器:使其拥有无懈可击的决策边界,并能可靠地区分不同类别。
- 一旦完成整个程序,您就无需在内存中保留训练数据。相反,您可以使用数学公式来保留决策边界。[2]
监督学习有哪些缺点?
- 监督学习在许多方面并不自然,无法完成机器学习中一些较为棘手的任务。
- 与无监督学习不同,监督学习无法从训练数据中提取未知信息。
- 与无监督学习不同,它无法凭自身通过判断数据特征来对数据进行聚类或分类。
- 在分类方面,如果我们输入的内容不属于训练数据中的任何一个类别,结果可能是错误的类别标签。假设您用猫和狗的数据训练了一个图像分类器。如果您提供一张长颈鹿的图片,结果可能是猫或狗,这是不正确的。
- 假设您的训练集缺少某些实例,而您想补充一课。那么在学习之后,当您使用这些样本时,可能无法得到正确的类别标签作为输入。
结论:
监督学习擅长分类和回归问题,例如判定新闻文章的类别,或预测未来某一日期的交易数量。监督过程的目标是在特定问题的背景下学习数据的含义。
- 监督式机器学习。来源:https://www.javatpoint.com/supervised-machine-learning。
- Petersson, D.,监督学习。来源:https://www.techtarget.com/searchenterpriseai/definition/supervised-learning。
监督学习的两大类型
- 分类:预测类别,例如是否为垃圾邮件,或某笔交易是否为欺诈。
- 回归:预测一个数值,例如房价或下个月的销售额。
常用算法
线性回归与逻辑回归、决策树、随机森林、支持向量机、k 近邻和神经网络。
一个简单的例子
要预测客户是否会延迟支付分期付款,您需要在已知结果(按时支付或逾期)的过往客户数据上训练模型,使用收入档次、预付金额和以往行为等特征。随后模型会为新客户打分。Installment Management System 等分期工具正好保存着此类数据。
优势与局限
当您拥有优质的已标注数据时,监督学习是准确的,但标注成本高昂,而且模型只能学到标签所体现的内容。请将其与无监督学习和强化学习进行比较。
快速解答
什么是过拟合?
过拟合是指模型死记硬背训练数据,而在新数据上表现不佳。更多数据、更简单的模型和验证可以减轻过拟合。