
Überwachtes Lernen, auch überwachtes maschinelles Lernen genannt, ist ein Teilgebiet des maschinellen Lernens und der künstlichen Intelligenz
Einleitung:
Im Laufe der Zeit lernen Menschen aus ihrer Erfahrung und treffen auf dieser Grundlage Entscheidungen. Ähnlich wie maschinelles Lernen funktioniert, kann ein Computer anhand von Mustern und Algorithmen aus früheren Aufzeichnungen lernen und sich anpassen. Ihr Computer analysiert frühere Daten und zieht ohne ausdrückliche Anweisungen Schlüsse daraus, wobei er künftige Ergebnisse auf Grundlage bestehender Datensätze projiziert.
Was ist maschinelles Lernen?
Maschinelles Lernen ist eine Kategorie der Datenuntersuchung, die die Bildung diagnostischer Modelle automatisiert. Es ist ein System, das Informationen aus Daten gewinnen, Muster erkennen und mit wenig bis gar keinem menschlichen Eingreifen Schlüsse ziehen kann. Das System kann dank des Einsatzes von künstlicher Intelligenz lernen und sich weiterentwickeln, ohne ausdrücklich programmiert zu werden.
Was ist überwachtes Lernen?
Künstliche Intelligenz entsteht durch überwachtes Lernen. Bei dieser Methode werden die Algorithmen eines Computers trainiert, indem man ihm Daten (die angemessen beschriftet wurden) für ein bestimmtes Ergebnis zuführt. Die Daten werden so lange trainiert, bis der Computer Muster erkennen und den Zusammenhang zwischen den Eingabedaten und den Ausgabe-Labels bestimmen kann. Damit können wir den genauen Ertrag für ein bestimmtes Label ermitteln.
Welche Beispiele gibt es für überwachtes Lernen?
Kurz gesagt: Beim überwachten Lernen trainiert ein Lehrer eine Maschine mit gut beschrifteten Daten. Bei der Methode des überwachten Lernens erhält der Computer eine neue Gruppe oder Anzahl von Beispielen (Daten), um die Trainingsdaten (Satz von Trainings- oder Vorbereitungsbeispielen) zu analysieren und aus beschrifteten Daten ein passendes Ergebnis zu erzeugen.
Wie funktioniert überwachtes Lernen?
Beim überwachten Lernen trainieren wir das Modell mit einem beschrifteten Datensatz. Das Modell wird entsprechend jeder Datenart trainiert. Ist der Trainingsprozess abgeschlossen, testen wir das trainierte Modell mit den Testdaten. Auf Grundlage des vorherigen Trainings sagt die Maschine die Ausgabe voraus.
Angenommen, wir haben einen Datensatz mit verschiedenen Formen von Dreiecken, etwa Quadraten, Rechtecken und Polygonen. Das klassische Modell muss derzeit als erste Phase für jede Form trainiert werden.
- Wenn eine bestimmte Form vier Enden oder Ecken hat und alle gleich sind, wird sie dem Quadrat zugeordnet.
- Das gesamte Verfahren wird als Dreieck beschriftet, wenn es drei Seiten hat.
- Wenn die eingegebene Form sechs gleiche Seiten hat, wird sie dem Sechseck zugeordnet.
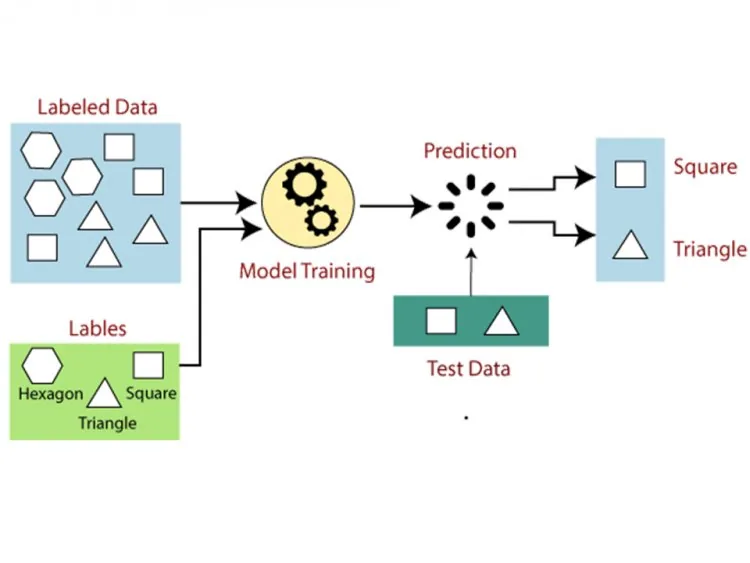
Nach dem Training nutzen wir den Testsatz, um unser Modell auf die Probe zu stellen, und das Ziel des Modells ist es, die Form zu erkennen.
Das System wurde bereits in einer Vielzahl von Formen trainiert, und wenn es eine neue entdeckt, kategorisiert es diese.[1]
Welche Schritte umfasst maschinelles Lernen?
- Bestimmen Sie zunächst, welche Art von Trainingsdatensatz Sie verwenden werden.
- Beschaffen Sie die beschrifteten Trainingsdaten, indem Sie sie sammeln und zusammenstellen.
- Teilen Sie den Trainingsdatensatz in drei Teile: Training, Test und Validierung.
- Bestimmen Sie die Eingabemerkmale des Trainingsdatensatzes, die genügend Informationen enthalten sollten, damit das Modell die Ausgabe erfolgreich vorhersagen kann.
- Wählen Sie einen geeigneten Algorithmus für das Modell, etwa eine Support Vector Machine oder einen Entscheidungsbaum.
- Nutzen Sie den Trainingsdatensatz, um den Algorithmus auszuführen. Validierungssätze, die eine Teilmenge der Trainingsdatensätze sind, werden gelegentlich als Regulatoren oder Kontrollparameter benötigt.
- Indem Sie den Testsatz bereitstellen, können Sie die Korrektheit des Modells bewerten. Sagt das Modell das Ergebnis korrekt voraus, ist unser Modell genau.
Welche Kategorien gibt es beim überwachten Lernen?
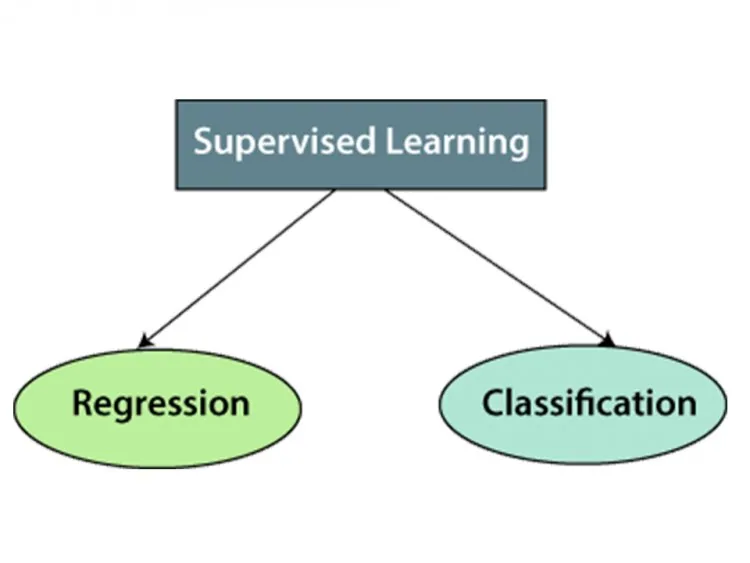
Überwachtes Lernen umfasst die folgenden Kategorien.
- Regression
- Klassifikation
Welche Vorteile hat überwachtes Lernen?
- In den Lehrdaten haben Sie eine detaillierte Vorstellung von den Klassen.
- Sie sollten verstehen können, wie überwachtes Lernen funktioniert. Beim unüberwachten Lernen wissen wir nicht immer genau, was in der Maschine abläuft, wie sie lernt und so weiter.
- Bevor Sie sich den Übungsdaten zuwenden, können Sie die genaue Anzahl der Klassen festlegen.
- Sie können bei der Bedeutung der Klassen sehr genau sein, das heißt, Sie können den Klassifikator so trainieren, dass er eine fehlerlose Entscheidungsgrenze hat und zuverlässig zwischen verschiedenen Klassen unterscheiden kann.
- Sie müssen die Trainingsdaten nicht in Ihrem Gedächtnis behalten, sobald Sie das gesamte Programm abgeschlossen haben. Stattdessen können Sie eine mathematische Formel nutzen, um die Entscheidungsgrenzen zu speichern.[2]
Welche Nachteile hat überwachtes Lernen?
- Überwachtes Lernen ist in vielerlei Hinsicht unnatürlich und kann einige der schwierigeren Aufgaben im maschinellen Lernen nicht bewältigen.
- Überwachtes Lernen kann im Gegensatz zum unüberwachten Lernen keine unbekannten Informationen aus Trainingsdaten gewinnen.
- Anders als unüberwachtes Lernen kann es Daten nicht selbstständig clustern oder kategorisieren, indem es deren Merkmale bestimmt.
- Bei der Klassifikation kann das Ergebnis ein falsches Klassenlabel sein, wenn wir eine Eingabe übergeben, die zu keiner der Klassen in den Trainingsdaten gehört. Stellen Sie sich vor, Sie haben Daten von Katzen und Hunden genutzt, um einen Bildklassifikator zu trainieren. Wenn Sie ein Giraffenbild eingeben, kann das Ergebnis entweder Katze oder Hund sein, was falsch ist.
- Angenommen, in Ihrem Lernsatz fehlen bestimmte Beispiele, und Sie möchten eine Lektion ergänzen. Dann erhalten Sie nach dem Lernen möglicherweise nicht das richtige Klassenlabel als Eingabe, wenn Sie diese Beispiele verwenden.
Fazit:
Überwachtes Lernen ist bei Klassifikations- und Regressionsproblemen stark, etwa bei der Bestimmung der Kategorie eines Nachrichtenartikels oder der Prognose der Anzahl von Transaktionen für ein künftiges Datum. Das Ziel des überwachten Verfahrens besteht darin, die Bedeutung von Daten im Kontext eines bestimmten Problems zu erlernen.
- Supervised Machine Learning. Verfügbar unter: https://www.javatpoint.com/supervised-machine-learning.
- Petersson, D.supervised learning. Verfügbar unter: https://www.techtarget.com/searchenterpriseai/definition/supervised-learning.
Zwei Hauptarten des überwachten Lernens
- Klassifikation: Vorhersage einer Kategorie, etwa Spam oder kein Spam oder ob eine Transaktion Betrug ist.
- Regression: Vorhersage einer Zahl, etwa des Hauspreises oder der Verkäufe im nächsten Monat.
Gängige Algorithmen
Lineare und logistische Regression, Entscheidungsbäume, Random Forests, Support Vector Machines, k-nächste Nachbarn und neuronale Netze.
Ein einfaches Beispiel
Um vorherzusagen, ob ein Kunde eine Rate zu spät zahlen wird, trainieren Sie ein Modell mit früheren Kunden, bei denen das Ergebnis bekannt ist (pünktlich oder verspätet bezahlt), und nutzen Merkmale wie Einkommensklasse, geleistete Anzahlung und früheres Verhalten. Das Modell bewertet dann neue Kunden. Ratenzahlungs-Tools wie das Installment Management System enthalten genau solche Daten.
Stärken und Grenzen
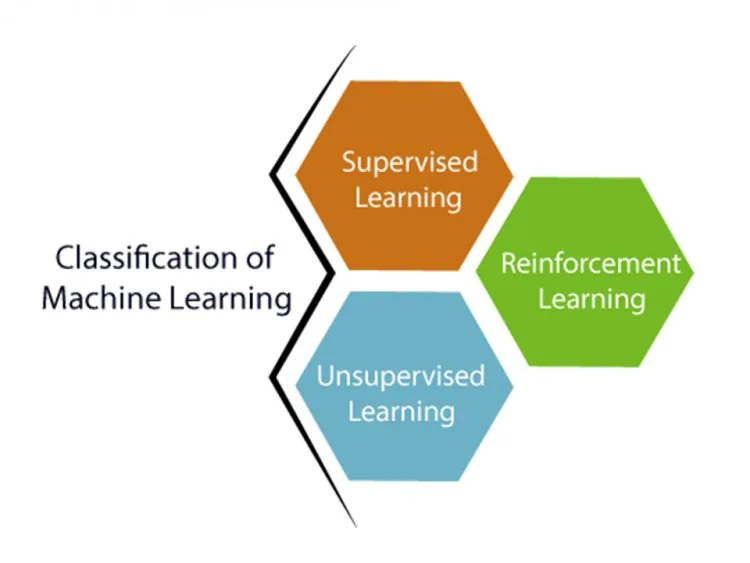
Überwachtes Lernen ist genau, wenn Sie gute beschriftete Daten haben, doch das Beschriften ist teuer, und das Modell lernt nur das, was die Labels zeigen. Vergleichen Sie es mit unüberwachtem Lernen und bestärkendem Lernen.
Kurze Antworten
Was ist Overfitting?
Overfitting liegt vor, wenn ein Modell die Trainingsdaten auswendig lernt und bei neuen Daten schlecht abschneidet. Es wird durch mehr Daten, einfachere Modelle und Validierung verringert.


