L'apprentissage supervisé, également appelé apprentissage automatique supervisé, est une sous-catégorie de l'apprentissage automatique et de l'intelligence artificielle
Introduction :
Avec le temps, les êtres humains apprennent de leur expérience et, sur la base de cette expérience, prennent des décisions. De la même manière que fonctionne l'apprentissage automatique, un ordinateur peut apprendre et s'adapter à l'aide de motifs et d'algorithmes issus d'enregistrements antérieurs. Votre ordinateur analyse et déduit à partir de données antérieures sans directives explicites, en projetant les résultats futurs sur la base des enregistrements existants.
Qu'est-ce que l'apprentissage automatique ?
L'apprentissage automatique est une catégorie d'analyse de données qui automatise la création de modèles de diagnostic. C'est un système capable d'extraire des informations des données, de diagnostiquer des motifs et de tirer des conclusions avec peu ou pas d'intervention humaine. Le système est capable d'apprendre et d'évoluer sans être explicitement codé grâce à l'utilisation de l'intelligence artificielle.
Qu'est-ce que l'apprentissage supervisé ?
L'intelligence artificielle est créée grâce à l'apprentissage supervisé. Dans cette méthode, les algorithmes d'un ordinateur sont entraînés en lui fournissant des données (correctement étiquetées) pour un certain résultat. Les données sont utilisées pour l'entraînement jusqu'à ce qu'il puisse reconnaître des motifs et déterminer le lien entre les données d'entrée et les étiquettes de sortie. Nous pouvons l'utiliser pour déterminer le rendement exact pour une étiquette donnée.
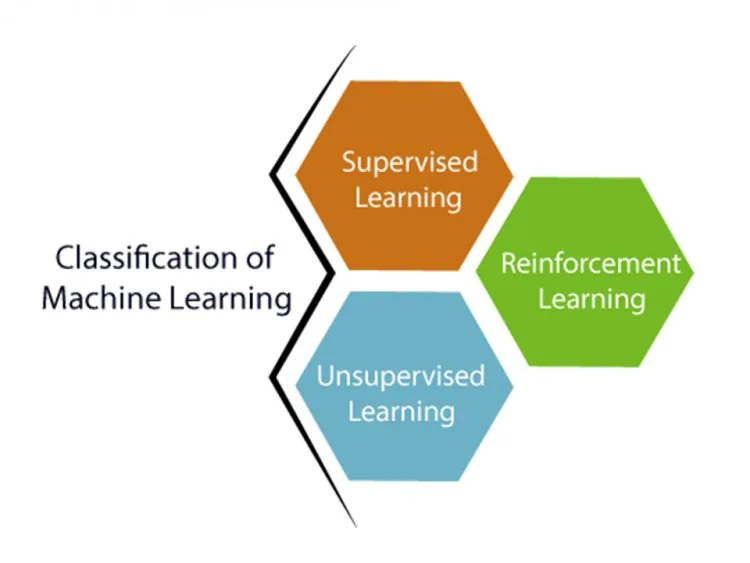
Quels sont des exemples d'apprentissage supervisé ?
En bref, l'apprentissage supervisé consiste à faire entraîner une machine par un instructeur à l'aide de données bien étiquetées. Avec la méthode d'apprentissage supervisé, l'ordinateur reçoit un nouveau groupe ou un certain nombre d'exemples (données) pour analyser les données d'entraînement (ensemble d'exemples d'entraînement ou de préparation) et créer un résultat approprié à partir de données étiquetées.
Comment fonctionne l'apprentissage supervisé ?
Dans l'apprentissage supervisé, nous entraînons le modèle à l'aide d'un jeu de données étiqueté. Le modèle est entraîné selon chaque type de données. Lorsque le processus d'entraînement est terminé, nous testons le modèle entraîné avec les données de test. Sur la base de l'entraînement précédent, la machine prédit la sortie.
Supposons que nous ayons un jeu de données contenant une diversité de formes, telles que des carrés, des rectangles et des polygones. Le modèle classique doit actuellement être entraîné pour chaque forme dans une phase initiale.
- Si une forme donnée a quatre côtés ou coins et qu'ils sont tous égaux, elle est classée comme un carré.
- L'ensemble de la procédure l'étiquettera comme un triangle s'il a trois côtés.
- Lorsque la forme saisie a six côtés égaux, elle est classée comme un hexagone.
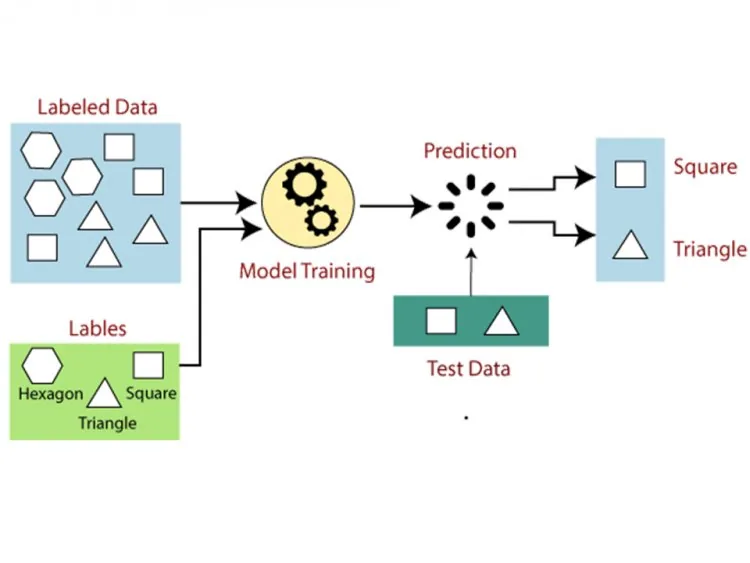
Après l'entraînement, nous utilisons le jeu de test pour mettre notre modèle à l'épreuve, et l'objectif du modèle est de reconnaître la forme.
Le système a déjà été entraîné sur diverses formes et, lorsqu'il en découvre une nouvelle, il la catégorise.[1]
Quelles sont les étapes de l'apprentissage automatique ?
- Tout d'abord, déterminez le type de jeu de données d'entraînement que vous utiliserez.
- Obtenez les données d'entraînement étiquetées en les collectant et en les rassemblant.
- Divisez le jeu de données d'entraînement en trois parties : entraînement, test et validation.
- Déterminez les caractéristiques d'entrée du jeu de données d'entraînement, qui doivent contenir suffisamment d'informations pour que le modèle prédise correctement la sortie.
- Choisissez un algorithme approprié pour le modèle, comme une machine à vecteurs de support ou un arbre de décision.
- Utilisez le jeu de données d'entraînement pour exécuter l'algorithme. Des jeux de validation, qui sont un sous-ensemble des jeux de données d'entraînement, sont parfois nécessaires comme paramètres de contrôle.
- En fournissant le jeu de test, vous pouvez évaluer l'exactitude du modèle. Si le modèle prédit correctement le résultat, alors notre modèle est précis.
Quelles sont les catégories d'apprentissage supervisé ?
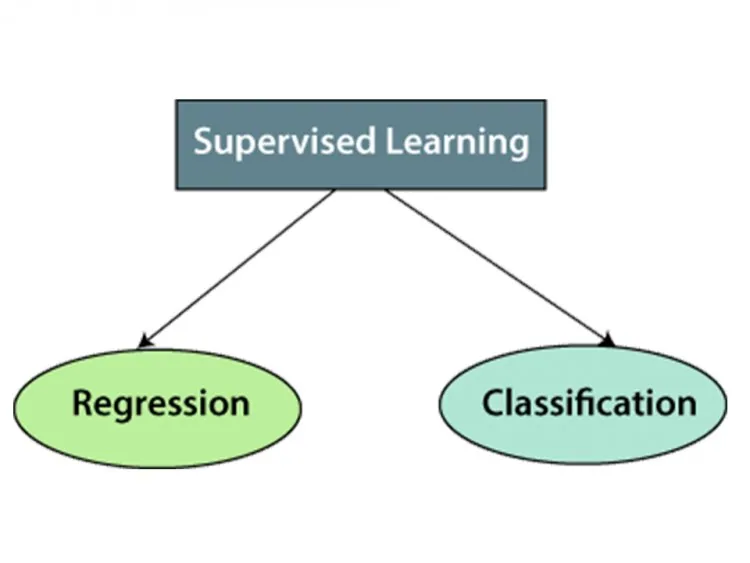
Voici les catégories de l'apprentissage supervisé.
- Régression
- Classification
Quels sont les avantages de l'apprentissage supervisé ?
- Dans les données d'entraînement, vous aurez une opinion détaillée des périodes.
- Vous devriez être capable de comprendre le fonctionnement de l'apprentissage supervisé. Avec l'apprentissage non supervisé, nous ne distinguons pas toujours ce qui se passe à l'intérieur de la machine, comment elle apprend, et ainsi de suite.
- Avant de vous lancer dans les données d'entraînement, vous pouvez régler le nombre précis de classes.
- Vous pouvez être très précis sur la signification des classes, c'est-à-dire que vous pouvez entraîner le classifieur de manière à ce qu'il ait une frontière de décision parfaite et puisse distinguer de façon fiable les différentes classes.
- Vous n'avez pas besoin de conserver les données d'entraînement en mémoire une fois le programme complet terminé. À la place, vous pouvez utiliser une formule mathématique pour conserver les frontières de décision.[2]
Quels sont les inconvénients de l'apprentissage supervisé ?
- À bien des égards, l'apprentissage supervisé est artificiel et il ne peut pas accomplir certaines des tâches les plus complexes de l'apprentissage automatique.
- L'apprentissage supervisé, contrairement à l'apprentissage non supervisé, ne peut pas extraire d'informations inconnues des données d'entraînement.
- Contrairement à l'apprentissage non supervisé, il ne peut pas regrouper ou catégoriser les données en déterminant seul leurs caractéristiques.
- En matière de classification, si nous fournissons une entrée qui n'appartient à aucune des classes des données d'entraînement, le résultat peut être une étiquette de classe incorrecte. Imaginons que vous ayez utilisé des données de chats et de chiens pour entraîner un classifieur d'images. Si vous fournissez une image de girafe, le résultat peut être un chat ou un chien, ce qui est incorrect.
- Supposons que votre jeu d'entraînement manque de certains exemples et que vous souhaitiez en ajouter. Après l'apprentissage, vous risquez alors de ne pas obtenir la bonne étiquette de classe en entrée lorsque vous utilisez ces échantillons.
Conclusion :
L'apprentissage supervisé excelle dans les problèmes de classification et de régression, comme déterminer la catégorie d'un article de presse ou prévoir le nombre de transactions à une date future. L'objectif du processus supervisé est d'apprendre la signification des données dans le contexte d'un problème précis.
- Supervised Machine Learning. Available from: https://www.javatpoint.com/supervised-machine-learning.
- Petersson, D.supervised learning. Available from: https://www.techtarget.com/searchenterpriseai/definition/supervised-learning.
Deux grands types d'apprentissage supervisé
- Classification : prédire une catégorie, comme spam ou non-spam, ou si une transaction est frauduleuse.
- Régression : prédire un nombre, comme le prix d'une maison ou les ventes du mois prochain.
Algorithmes courants
Régression linéaire et logistique, arbres de décision, forêts aléatoires, machines à vecteurs de support, k plus proches voisins et réseaux de neurones.
Un exemple simple
Pour prédire si un client paiera une échéance en retard, vous entraînez un modèle sur des clients passés dont le résultat est connu (payé à temps ou en retard) à l'aide de variables comme la tranche de revenus, l'avance versée et le comportement antérieur. Le modèle évalue ensuite les nouveaux clients. Des outils de gestion d'échéances tels que Installment Management System contiennent précisément ce type de données.
Forces et limites
L'apprentissage supervisé est précis lorsque vous disposez de bonnes données étiquetées, mais l'étiquetage est coûteux et le modèle n'apprend que ce que montrent les étiquettes. Comparez-le avec l'apprentissage non supervisé et l'apprentissage par renforcement.
Réponses rapides
Qu'est-ce que le surapprentissage ?
Le surapprentissage se produit lorsqu'un modèle mémorise les données d'entraînement et donne de mauvais résultats sur de nouvelles données. Il est réduit par davantage de données, des modèles plus simples et la validation.