Introduction :
Un ordinateur peut apprendre et s'adapter en employant des motifs et des algorithmes issus d'enregistrements précédents. Sans instructions explicites, votre ordinateur analyse et déduit à partir de données antérieures, en prévoyant les résultats futurs sur la base des enregistrements actuels. Mais dans l'apprentissage non supervisé, vous n'avez pas besoin de fournir des données étiquetées ni d'entraîner la machine comme dans l'apprentissage automatique supervisé.
Qu'est-ce que l'apprentissage non supervisé ?
L'apprentissage non supervisé est aussi appelé apprentissage automatique non supervisé. Avec l'apprentissage non supervisé, vous n'avez pas besoin d'entraîner les données. Les données fournies à la machine ne sont pas étiquetées. La machine prédit d'elle-même les motifs et les différentes informations à partir de ces données non étiquetées. Elle prédit les groupes cachés et les autres informations nécessaires à la solution.[1]
Quels sont des exemples d'apprentissage supervisé ?
Les stratégies d'apprentissage non supervisé, contrairement à l'apprentissage supervisé, sont appropriées lorsque les variables (c'est-à-dire les étiquettes) ne sont pas fournies. Le clustering K-Means, l'analyse en composantes principales et le clustering hiérarchique sont des exemples de techniques d'apprentissage non supervisé.
Comment fonctionne l'apprentissage supervisé ?
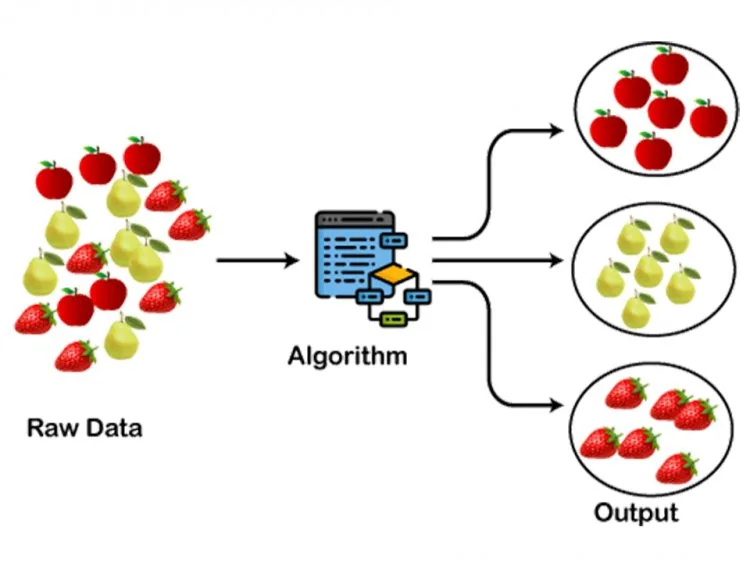
Comme expliqué ci-dessus, le jeu de données fourni dans l'apprentissage non supervisé n'est pas correctement étiqueté. Cela signifie que les données ne sont pas catégorisées et que les sorties correspondantes ne sont pas fournies. La machine s'entraîne toute seule. D'abord, elle interprète les données brutes pour trouver les motifs cachés, puis l'algorithme approprié est appliqué aux données. Une fois les algorithmes appliqués, les objets de données sont répartis en groupes selon la similarité des groupes.[2]
Quelles sont les catégories d'apprentissage non supervisé ?
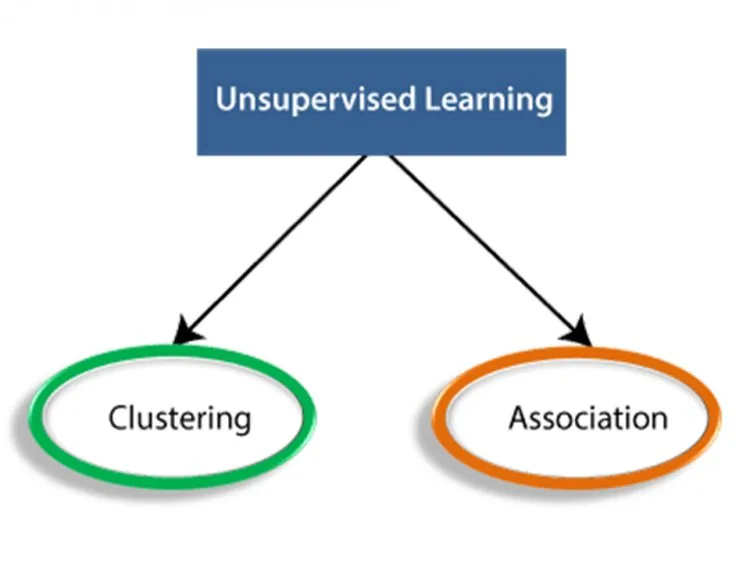
Voici les catégories de l'apprentissage non supervisé.
- Clustering
- Association
Quels sont les avantages de l'apprentissage supervisé ?
- Il est capable de voir ce que le cerveau humain est incapable de voir.
- Il sert à découvrir des caractéristiques cachées essentielles pour l'entreprise et possède de nombreuses applications concrètes.
- Une tâche non supervisée peut aboutir à la création d'un tout nouveau segment de marché ou d'une toute nouvelle entreprise.
- Comparé au problème d'apprentissage supervisé, la complexité sera moindre. Comme personne n'a besoin de comprendre les étiquettes associées, les complications sont réduites.
- Le jeu de données est beaucoup plus facile à obtenir.
Quels sont les inconvénients de l'apprentissage supervisé ?
- Il est plus coûteux, car une intervention humaine peut être nécessaire pour comprendre les tendances et les relier grâce à l'expertise métier.
- Comme il n'y a ni étiquette ni mesure de sortie pour certifier son utilité, il n'est souvent pas garanti que les résultats générés soient bénéfiques.
- Le type et les sorties d'une tâche non supervisée ne peuvent pas être définis précisément. Elle dépend fortement de la conception et, par conséquent, de l'ordinateur.
- La précision des résultats est souvent insuffisante.
Conclusion :
L'apprentissage non supervisé est une approche d'apprentissage automatique dans laquelle le modèle n'a pas besoin de supervision. L'apprentissage automatique non supervisé aide à découvrir dans les données des motifs jusque-là inconnus.
- Pratt, M.K. unsupervised learning. Available from: https://www.techtarget.com/searchenterpriseai/definition/unsupervised-learning.
- Unsupervised Machine Learning. Available from: https://www.javatpoint.com/unsupervised-machine-learning.
Tâches courantes d'apprentissage non supervisé
- Clustering : regrouper des éléments similaires, par exemple des segments de clientèle pour le marketing. Algorithmes populaires : k-means, clustering hiérarchique et DBSCAN.
- Réduction de dimensionnalité : compresser de nombreuses caractéristiques en quelques-unes tout en conservant la structure, grâce à des méthodes comme l'ACP.
- Règles d'association : trouver les articles souvent achetés ensemble, comme dans l'analyse du panier d'achat.
- Détection d'anomalies : repérer des transactions ou des relevés de capteurs inhabituels.
Exemples en entreprise
Un détaillant peut regrouper ses clients selon leur comportement d'achat pour adapter ses offres, un magasin peut repérer les produits qui se vendent ensemble pour les placer côte à côte, et une banque peut signaler une activité inhabituelle sur une carte. Ces analyses de vente au détail font partie de notre service d'analytique IA.
Apprentissage non supervisé vs supervisé
L'apprentissage supervisé a besoin de données étiquetées et prédit une réponse connue ; l'apprentissage non supervisé n'a pas d'étiquettes et recherche une structure cachée. Lisez apprentissage supervisé et apprentissage semi-supervisé pour comparer.
Réponses rapides
Le clustering est-il supervisé ou non supervisé ?
Le clustering est non supervisé car les groupes sont découverts, et non donnés.