
Introducción:
Un ordenador puede aprender y adaptarse empleando patrones y algoritmos de registros anteriores. Sin instrucciones explícitas, su ordenador analiza e infiere a partir de datos anteriores, pronosticando resultados futuros sobre la base de los registros actuales. Pero en el aprendizaje no supervisado no es necesario proporcionar datos etiquetados ni entrenar a la máquina como en el aprendizaje automático supervisado.
¿Qué es el aprendizaje no supervisado?
El aprendizaje no supervisado también se conoce como aprendizaje automático no supervisado. Con el aprendizaje no supervisado no es necesario entrenar los datos. Los datos que se proporcionan a la máquina no están etiquetados. La máquina predice por sí sola los patrones y las distintas piezas de información a partir de estos datos sin etiquetar. La máquina predice los grupos ocultos y otra información necesaria para la solución.[1]
¿Cuáles son algunos ejemplos de aprendizaje supervisado?
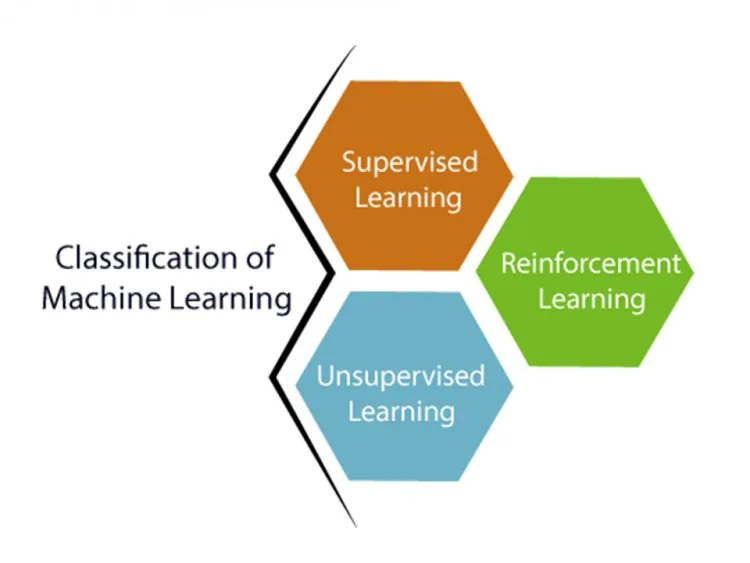
Las estrategias de aprendizaje no supervisado, a diferencia del aprendizaje supervisado, son apropiadas cuando no se proporcionan las variables (es decir, las etiquetas). K-Means Clustering, el análisis de componentes principales y el clustering jerárquico son ejemplos de técnicas de aprendizaje no supervisado.
¿Cómo funciona el aprendizaje supervisado?
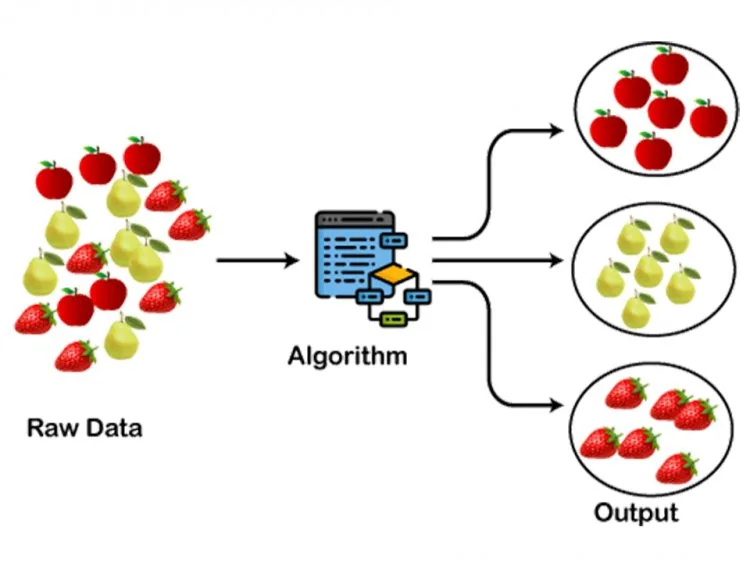
Como se explicó anteriormente, el conjunto de datos que se proporciona en el aprendizaje no supervisado no está correctamente etiquetado. Esto significa que los datos no están categorizados y no se les dan las salidas correspondientes. La máquina se entrena sola. En primer lugar, interpreta los datos sin procesar para encontrar los patrones ocultos en ellos y, después, se aplica a los datos el algoritmo adecuado. Una vez que los algoritmos aplicados terminan, los objetos de datos se dividen en grupos según la similitud de los grupos.[2]
¿Cuáles son las categorías del aprendizaje no supervisado?
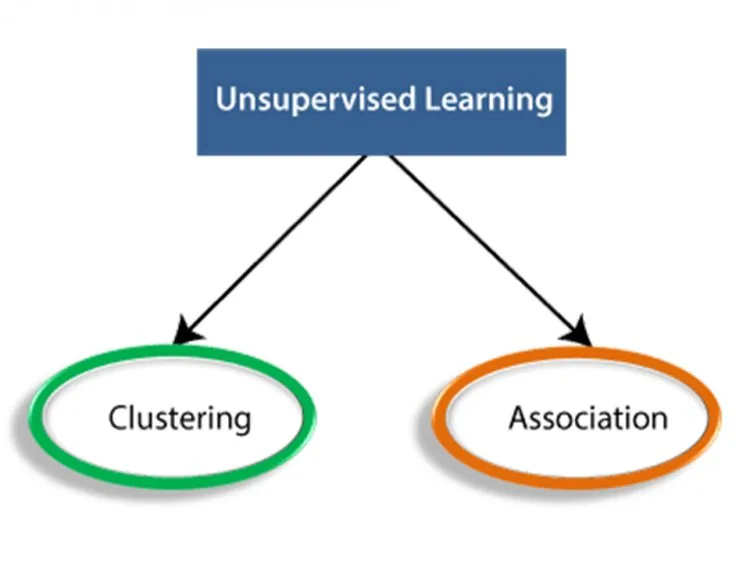
A continuación se presentan las categorías que tiene el aprendizaje no supervisado.
- Clustering
- Asociación
¿Cuáles son las ventajas del aprendizaje supervisado?
- Es capaz de ver lo que el cerebro humano no puede ver.
- Se utiliza para descubrir características ocultas que son críticas para el negocio y tiene diversas aplicaciones reales.
- Una tarea no controlada puede dar lugar a la creación de un segmento de negocio o una empresa completamente nuevos.
- En comparación con el problema de aprendizaje supervisado, habrá menos complejidad. Como nadie necesita comprender las etiquetas asociadas, se reducen las complicaciones.
- El conjunto de datos es mucho más fácil de conseguir.
¿Cuáles son los inconvenientes del aprendizaje supervisado?
- Es más caro, ya que puede requerirse la intervención humana para comprender las tendencias y vincularlas mediante conocimientos especializados del dominio.
- Como no hay una etiqueta ni una métrica de salida que certifique su utilidad, a menudo no se puede asegurar que los resultados generados sean beneficiosos.
- El tipo y las salidas de una tarea no supervisada no pueden definirse con precisión. Depende en gran medida del diseño y, por lo tanto, del ordenador.
- Con frecuencia falta precisión en los resultados.
Conclusión:
El aprendizaje no supervisado es un enfoque de aprendizaje automático en el que el modelo no requiere supervisión. El aprendizaje automático no supervisado ayuda a descubrir patrones en los datos que antes no se habían descubierto.
- Pratt, M.K. unsupervised learning. Disponible en: https://www.techtarget.com/searchenterpriseai/definition/unsupervised-learning.
- Unsupervised Machine Learning. Disponible en: https://www.javatpoint.com/unsupervised-machine-learning.
Tareas comunes del aprendizaje no supervisado
- Clustering: agrupar elementos similares, por ejemplo segmentos de clientes para marketing. Algoritmos populares: k-means, clustering jerárquico y DBSCAN.
- Reducción de dimensionalidad: comprimir muchas características en unas pocas conservando la estructura, mediante métodos como PCA.
- Reglas de asociación: encontrar artículos que se compran juntos con frecuencia, como en el análisis de la cesta de la compra.
- Detección de anomalías: identificar transacciones o lecturas de sensores inusuales.
Ejemplos empresariales
Un minorista puede agrupar a los clientes según su comportamiento de compra para adaptar las ofertas, una tienda puede encontrar productos que se venden juntos para colocarlos uno al lado del otro, y un banco puede señalar actividad inusual en tarjetas. Este tipo de analítica para el comercio minorista forma parte de nuestro servicio de analítica con IA.
Aprendizaje no supervisado frente a supervisado
El aprendizaje supervisado necesita datos etiquetados y predice una respuesta conocida; el aprendizaje no supervisado no tiene etiquetas y busca estructura oculta. Lea sobre el aprendizaje supervisado y el aprendizaje semisupervisado para ver el contraste.
Respuestas rápidas
¿El clustering es supervisado o no supervisado?
El clustering es no supervisado porque los grupos se descubren, no se dan.


