
El aprendizaje supervisado, también conocido como aprendizaje automático supervisado, es una subcategoría del aprendizaje automático y de la inteligencia artificial
Introducción:
Con el paso del tiempo, los seres humanos aprenden de su experiencia y, sobre la base de esa experiencia, toman una decisión. De manera similar a como funciona el aprendizaje automático, usando patrones y algoritmos de registros anteriores, un ordenador puede aprender y adaptarse. Su ordenador analiza e infiere a partir de datos anteriores sin instrucciones explícitas, proyectando resultados futuros sobre la base de los registros existentes.
¿Qué es el aprendizaje automático?
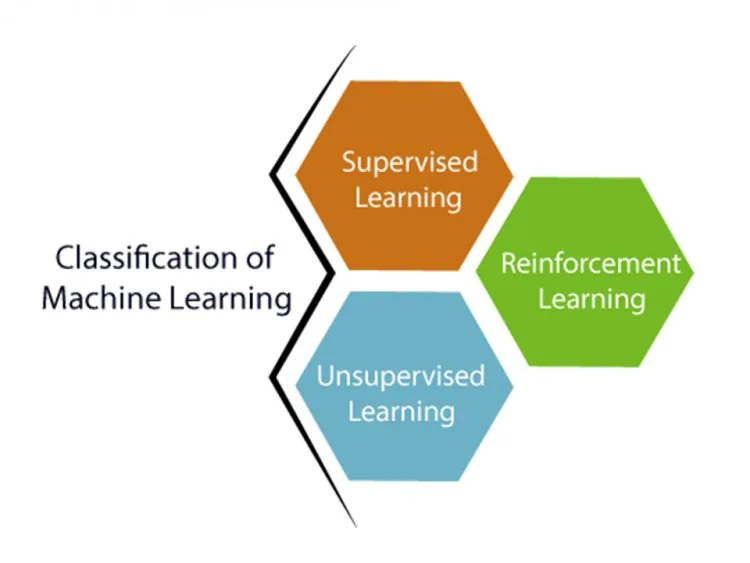
El aprendizaje automático es una categoría de investigación de datos que automatiza la creación de modelos de diagnóstico. Es un sistema capaz de extraer información de los datos, diagnosticar patrones y sacar conclusiones con poca o ninguna intervención humana. El sistema puede aprender y evolucionar sin ser codificado explícitamente gracias al uso de la inteligencia artificial.
¿Qué es el aprendizaje supervisado?
La inteligencia artificial se crea mediante el aprendizaje supervisado. En este método, los algoritmos de un ordenador se entrenan alimentándolo con datos (debidamente etiquetados) para un resultado determinado. Los datos se entrenan hasta que el sistema es capaz de reconocer patrones y determinar la relación entre los datos de entrada y las etiquetas de salida. Podemos usarlo para determinar el resultado exacto para una etiqueta dada.
¿Cuáles son algunos ejemplos de aprendizaje supervisado?
En pocas palabras, el aprendizaje supervisado es cuando un instructor entrena a una máquina con datos bien etiquetados. Con el método de aprendizaje supervisado, al ordenador se le da un nuevo grupo o número de ejemplos (datos) para analizar los datos de entrenamiento (conjunto de ejemplos de entrenamiento o preparación) y crear un resultado adecuado a partir de datos etiquetados.
¿Cómo funciona el aprendizaje supervisado?
En el aprendizaje supervisado entrenamos el modelo usando un conjunto de datos etiquetado. El modelo se entrena según cada tipo de datos. Cuando se completa el proceso de entrenamiento, probamos el modelo entrenado con los datos de prueba. Sobre la base del entrenamiento previo, la máquina predice la salida.
Supongamos que tenemos un conjunto de datos con una diversidad de formas de figuras, como cuadrados, rectángulos y polígonos. El modelo clásico debe entrenarse ahora para cada forma como fase inicial.
- Si una determinada forma tiene cuatro extremos o esquinas y todos son iguales, se le asigna la categoría de cuadrado.
- Todo el procedimiento se etiquetará como triángulo si tiene tres lados.
- Cuando la forma introducida tiene seis lados iguales, se le asigna la categoría de hexágono.
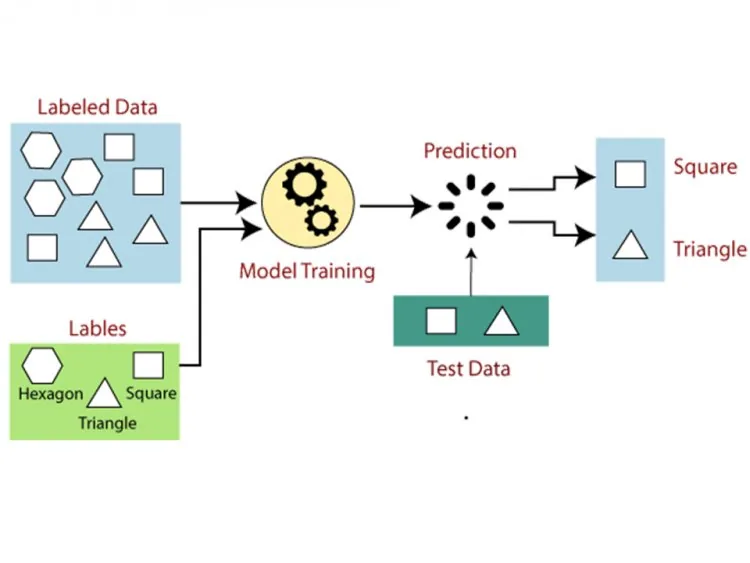
Tras el entrenamiento, usamos el conjunto de prueba para poner a prueba nuestro modelo, y el objetivo del modelo es reconocer la forma.
El sistema ya ha sido entrenado con una variedad de formas y, cuando descubre una nueva, la clasifica.[1]
¿Qué pasos intervienen en el aprendizaje automático?
- Primero, determine el tipo de conjunto de datos de entrenamiento que va a utilizar.
- Obtenga los datos de entrenamiento etiquetados recopilándolos y reuniéndolos.
- Divida el conjunto de datos de entrenamiento en tres partes: entrenamiento, prueba y validación.
- Determine las características de entrada del conjunto de datos de entrenamiento, que deben incluir información suficiente para que el modelo pueda predecir la salida con éxito.
- Elija un algoritmo adecuado para el modelo, como una máquina de vectores de soporte o un árbol de decisión.
- Utilice el conjunto de datos de entrenamiento para ejecutar el algoritmo. A veces se requieren conjuntos de validación, que son un subconjunto de los conjuntos de datos de entrenamiento, como reguladores o parámetros de control.
- Al proporcionar el conjunto de prueba, puede evaluar la exactitud del modelo. Si el modelo predice correctamente el resultado, entonces nuestro modelo es preciso.
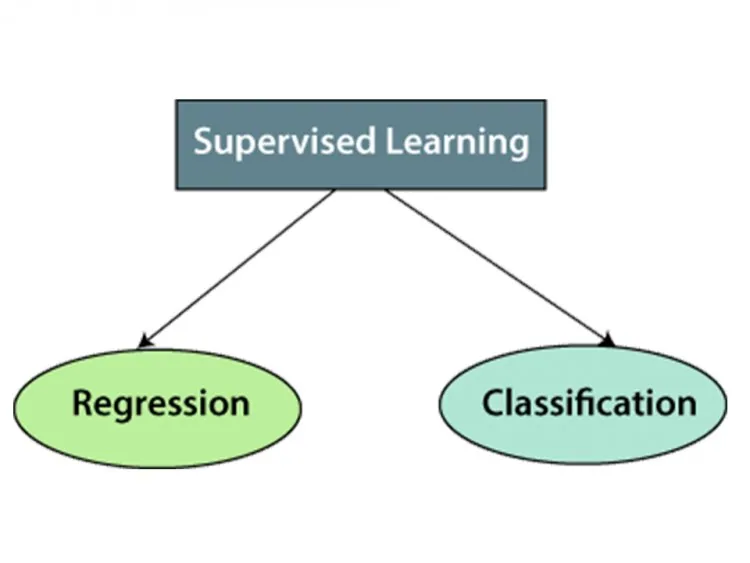
¿Cuáles son las categorías del aprendizaje supervisado?
A continuación se presentan las categorías que tiene el aprendizaje supervisado.
- Regresión
- Clasificación
¿Cuáles son las ventajas del aprendizaje supervisado?
- En los datos de entrenamiento tendrá una idea detallada de las clases.
- Debería ser capaz de entender cómo funciona el aprendizaje supervisado. Cuando se trata del aprendizaje no supervisado, no siempre sabemos qué ocurre dentro de la máquina, cómo está aprendiendo, etc.
- Antes de pasar a los datos de entrenamiento, puede regular el número exacto de clases.
- Puede ser muy preciso con respecto al significado de las clases; es decir, puede entrenar el clasificador de tal manera que tenga un límite de decisión impecable y pueda discriminar de forma fiable entre distintas clases.
- No necesita conservar los datos de entrenamiento en su memoria una vez que haya concluido todo el programa. En su lugar, puede usar una fórmula matemática para retener los límites de decisión.[2]
¿Cuáles son los inconvenientes del aprendizaje supervisado?
- En muchos sentidos, el aprendizaje supervisado es artificial y no puede realizar algunas de las tareas más complejas del aprendizaje automático.
- El aprendizaje supervisado, a diferencia del no supervisado, no puede extraer información desconocida de los datos de entrenamiento.
- A diferencia del aprendizaje no supervisado, no puede agrupar ni categorizar datos determinando por sí solo sus características.
- En lo que respecta a la clasificación, si introducimos una entrada que no pertenece a ninguna de las clases de los datos de entrenamiento, el resultado podría ser una etiqueta de clase incorrecta. Imaginemos que usó datos de gatos y perros para entrenar un clasificador de imágenes. Si proporciona una imagen de una jirafa, el resultado puede ser un gato o un perro, lo cual es incorrecto.
- Supongamos que a su conjunto de entrenamiento le faltan ciertos casos y quiere añadir una clase. Entonces, tras el aprendizaje, es posible que no obtenga la etiqueta de clase correcta como entrada cuando utilice esas muestras.
Conclusión:
El aprendizaje supervisado destaca en problemas de clasificación y regresión, como decidir la categoría de un artículo de noticias o pronosticar el número de transacciones en una fecha futura. El objetivo del proceso supervisado es aprender el significado de los datos en el contexto de un problema concreto.
- Supervised Machine Learning. Disponible en: https://www.javatpoint.com/supervised-machine-learning.
- Petersson, D.supervised learning. Disponible en: https://www.techtarget.com/searchenterpriseai/definition/supervised-learning.
Dos tipos principales de aprendizaje supervisado
- Clasificación: predecir una categoría, como spam o no spam, o si una transacción es fraudulenta.
- Regresión: predecir un número, como el precio de una vivienda o las ventas del mes siguiente.
Algoritmos comunes
Regresión lineal y logística, árboles de decisión, bosques aleatorios, máquinas de vectores de soporte, k vecinos más cercanos y redes neuronales.
Un ejemplo sencillo
Para predecir si un cliente pagará una cuota con retraso, se entrena un modelo con clientes anteriores cuyo resultado se conoce (pagó a tiempo o con retraso) utilizando características como el tramo de ingresos, el anticipo pagado y el comportamiento previo. Después, el modelo puntúa a los nuevos clientes. Las herramientas de cuotas, como Installment Management System, almacenan exactamente este tipo de datos.
Fortalezas y límites
El aprendizaje supervisado es preciso cuando se dispone de buenos datos etiquetados, pero etiquetar es costoso y el modelo solo aprende lo que muestran las etiquetas. Compárelo con el aprendizaje no supervisado y el aprendizaje por refuerzo.
Respuestas rápidas
¿Qué es el sobreajuste?
El sobreajuste ocurre cuando un modelo memoriza los datos de entrenamiento y rinde mal con datos nuevos. Se reduce con más datos, modelos más simples y validación.


