
O aprendizado supervisionado, também conhecido como machine learning supervisionado, é uma subcategoria do machine learning e da inteligência artificial
Introdução:
Com o passar do tempo, os seres humanos aprendem com a experiência e, com base nela, tomam decisões. De maneira semelhante ao machine learning, usando padrões e algoritmos de registros anteriores, um computador pode aprender e se adaptar. O computador analisa e infere a partir de dados anteriores sem instruções explícitas, projetando resultados futuros com base nos registros existentes.
O que é machine learning?
Machine learning é uma categoria de análise de dados que automatiza a criação de modelos de diagnóstico. É um sistema capaz de extrair informações dos dados, identificar padrões e tirar conclusões com pouca ou nenhuma intervenção humana. O sistema consegue aprender e evoluir sem ser programado explicitamente graças ao uso de inteligência artificial.
O que é aprendizado supervisionado?
A inteligência artificial é criada por meio do aprendizado supervisionado. Nesse método, os algoritmos de um computador são treinados alimentando-os com dados (devidamente rotulados) para um determinado resultado. Os dados são treinados até que o sistema consiga reconhecer padrões e determinar a relação entre os dados de entrada e os rótulos de saída. Podemos usar isso para determinar o resultado exato de um determinado rótulo.
Quais são alguns exemplos de aprendizado supervisionado?
Em resumo, o aprendizado supervisionado ocorre quando um instrutor treina uma máquina com dados bem rotulados. Com o método supervisionado, o computador recebe um novo grupo ou número de exemplos (dados) para analisar os dados de treinamento (conjunto de exemplos de treinamento ou preparação) e gerar um resultado adequado a partir de dados rotulados.
Como funciona o aprendizado supervisionado?
No aprendizado supervisionado, treinamos o modelo usando um conjunto de dados rotulado. O modelo é treinado de acordo com cada tipo de dado. Quando o treinamento termina, testamos o modelo treinado com os dados de teste. Com base no treinamento anterior, a máquina prevê a saída.
Suponha que tenhamos um conjunto de dados com diversas formas de figuras, como quadrados, retângulos e polígonos. O modelo clássico precisa ser treinado para cada forma como fase inicial.
- Se uma determinada forma tem quatro lados ou cantos e todos são iguais, ela é classificada como um quadrado.
- O procedimento completo será rotulado como triângulo se tiver três lados.
- Quando a forma informada tem seis lados iguais, ela é classificada como um hexágono.
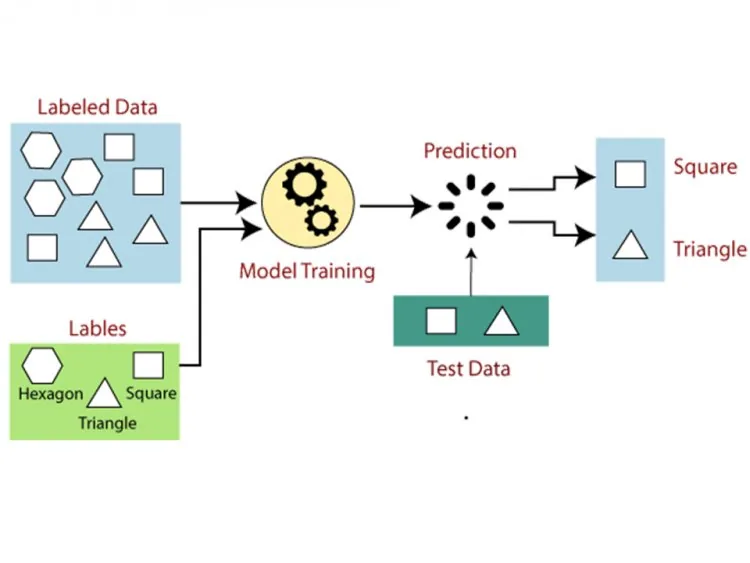
Após o treinamento, usamos o conjunto de teste para colocar o modelo à prova, e o objetivo do modelo é reconhecer a forma.
O sistema já foi treinado em diversas formas e, quando descobre uma nova, ele a categoriza.[1]
Quais são as etapas do machine learning?
- Primeiro, determine o tipo de conjunto de dados de treinamento que você usará.
- Obtenha os dados de treinamento rotulados coletando-os e reunindo-os.
- Divida o conjunto de dados de treinamento em três partes: treinamento, teste e validação.
- Determine as características de entrada do conjunto de dados de treinamento, que devem incluir informações suficientes para que o modelo preveja a saída com sucesso.
- Escolha um algoritmo adequado para o modelo, como uma máquina de vetores de suporte ou uma árvore de decisão.
- Use o conjunto de dados de treinamento para executar o algoritmo. Os conjuntos de validação, que são um subconjunto dos conjuntos de treinamento, às vezes são necessários como reguladores ou parâmetros de controle.
- Ao fornecer o conjunto de teste, você pode avaliar a precisão do modelo. Se o modelo prevê corretamente o resultado, então nosso modelo é preciso.
Quais são as categorias de aprendizado supervisionado?
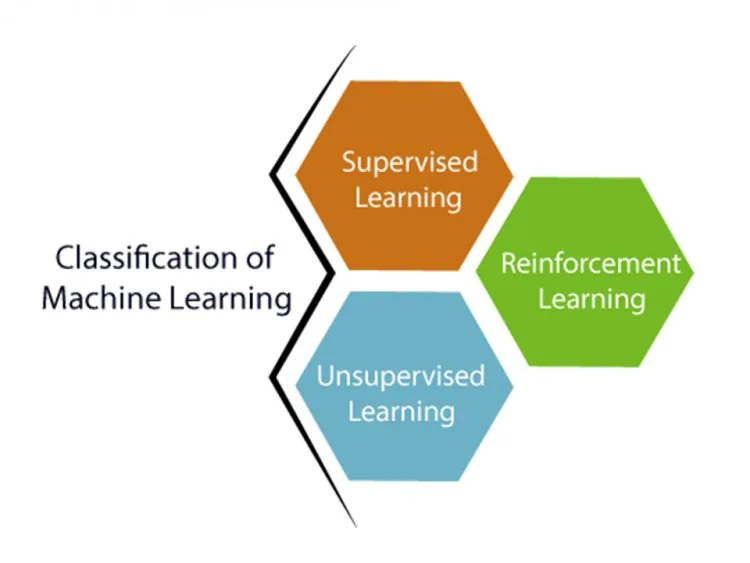
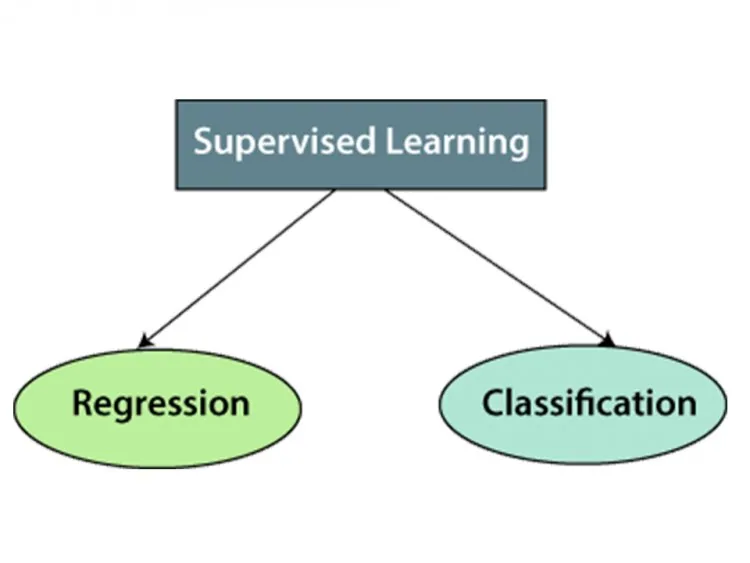
A seguir estão as categorias do aprendizado supervisionado.
- Regressão
- Classificação
Quais são as vantagens do aprendizado supervisionado?
- Nos dados de treinamento, você terá uma opinião detalhada sobre os períodos.
- Você deve ser capaz de entender como funciona o mecanismo do aprendizado supervisionado. Já no aprendizado não supervisionado, nem sempre sabemos o que está acontecendo dentro da máquina, como ela está aprendendo e assim por diante.
- Antes de usar os dados para o treinamento, você pode controlar o número exato de classes.
- Você pode ser bastante preciso quanto ao significado das classes, ou seja, pode treinar o classificador de modo que ele tenha uma fronteira de decisão impecável e consiga distinguir com segurança entre classes diferentes.
- Você não precisa manter os dados de treinamento na memória depois de concluir o programa completo. Em vez disso, pode usar uma fórmula matemática para reter as fronteiras de decisão.[2]
Quais são as desvantagens do aprendizado supervisionado?
- De várias maneiras, o aprendizado supervisionado é artificial e não consegue realizar algumas das tarefas mais complexas do machine learning.
- O aprendizado supervisionado, ao contrário do não supervisionado, não consegue extrair informações desconhecidas dos dados de treinamento.
- Diferentemente do aprendizado não supervisionado, ele não consegue agrupar ou categorizar os dados determinando suas características por conta própria.
- Na classificação, se fornecemos uma entrada que não pertence a nenhuma das classes dos dados de treinamento, o resultado pode ser um rótulo de classe incorreto. Imagine que você usou dados de gatos e cães para treinar um classificador de imagens. Se você fornecer a imagem de uma girafa, o resultado pode ser gato ou cão, o que está errado.
- Suponha que seu conjunto de treinamento não tenha certas instâncias e você queira incluir uma lição. Então, após o aprendizado, você pode não obter o rótulo de classe correto como entrada ao usar essas amostras.
Conclusão:
O aprendizado supervisionado se destaca em problemas de classificação e regressão, como decidir a classificação de um artigo de notícias ou prever o número de transações em uma data futura. O objetivo do processo supervisionado é aprender o significado dos dados no contexto de um problema específico.
- Supervised Machine Learning. Disponível em: https://www.javatpoint.com/supervised-machine-learning.
- Petersson, D.supervised learning. Disponível em: https://www.techtarget.com/searchenterpriseai/definition/supervised-learning.
Dois tipos principais de aprendizado supervisionado
- Classificação: prever uma categoria, como spam ou não spam, ou se uma transação é fraude.
- Regressão: prever um número, como o preço de um imóvel ou as vendas do próximo mês.
Algoritmos comuns
Regressão linear e logística, árvores de decisão, florestas aleatórias, máquinas de vetores de suporte, k-vizinhos mais próximos e redes neurais.
Um exemplo simples
Para prever se um cliente pagará uma parcela com atraso, você treina um modelo com clientes anteriores cujo resultado é conhecido (pagou em dia ou com atraso), usando características como faixa de renda, entrada paga e comportamento anterior. O modelo então pontua os novos clientes. Ferramentas de parcelamento como o Installment Management System armazenam exatamente esse tipo de dado.
Pontos fortes e limites
O aprendizado supervisionado é preciso quando você tem bons dados rotulados, mas a rotulagem é cara e o modelo só aprende o que os rótulos mostram. Compare com o aprendizado não supervisionado e o aprendizado por reforço.
Respostas rápidas
O que é overfitting?
Overfitting é quando um modelo memoriza os dados de treinamento e tem desempenho ruim com dados novos. Ele é reduzido com mais dados, modelos mais simples e validação.


