
Introdução:
Um computador pode aprender e se adaptar usando padrões e algoritmos de registros anteriores. Sem instruções explícitas, o computador analisa e infere a partir de dados passados, prevendo resultados futuros com base nos registros atuais. Mas no aprendizado não supervisionado, você não precisa fornecer dados rotulados nem treinar a máquina como no machine learning supervisionado.
O que é aprendizado não supervisionado?
O aprendizado não supervisionado também é conhecido como machine learning não supervisionado. Com ele, você não precisa treinar os dados. Os dados fornecidos à máquina não são rotulados. A máquina identifica por conta própria os padrões e diferentes informações a partir desses dados não rotulados. Ela prevê os grupos ocultos e outras informações necessárias para a solução.[1]
Quais são alguns exemplos de aprendizado supervisionado?
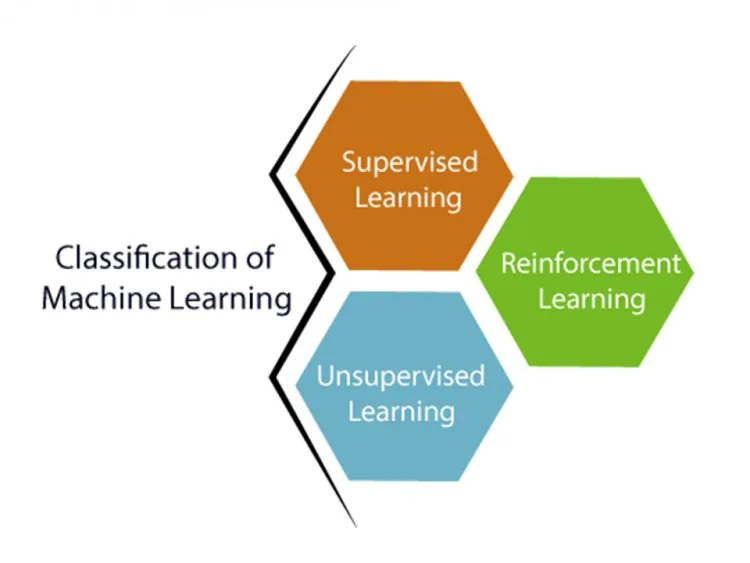
As estratégias de aprendizado não supervisionado, ao contrário do aprendizado supervisionado, são apropriadas quando as variáveis (ou seja, os rótulos) não são fornecidas. K-Means Clustering, Análise de Componentes Principais e Clusterização Hierárquica são exemplos de técnicas de aprendizado não supervisionado.
Como funciona o aprendizado supervisionado?
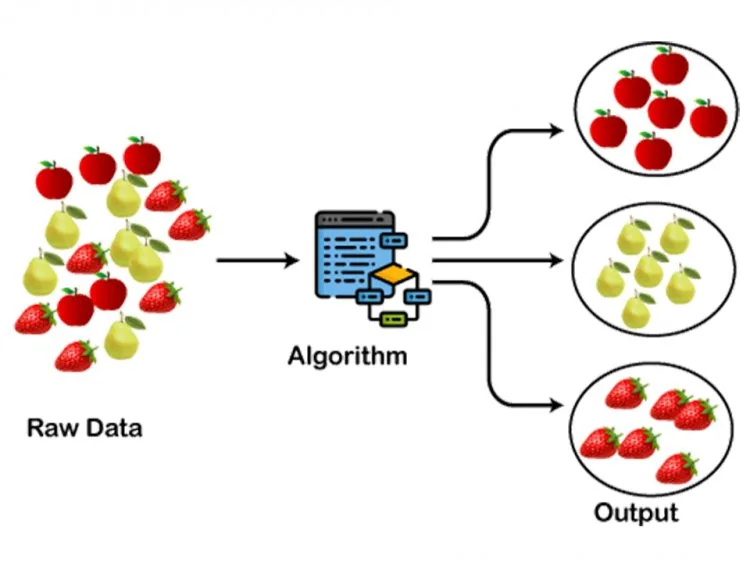
Como explicado acima, o conjunto de dados fornecido no aprendizado não supervisionado não está devidamente rotulado. Isso significa que os dados não são categorizados e não há saídas correspondentes associadas a eles. A máquina treina a si mesma. Primeiro, ela interpreta os dados brutos para encontrar os padrões ocultos e, em seguida, o algoritmo adequado é aplicado. Depois que os algoritmos são executados, os objetos de dados são divididos em grupos de acordo com a similaridade entre eles.[2]
Quais são as categorias de aprendizado não supervisionado?
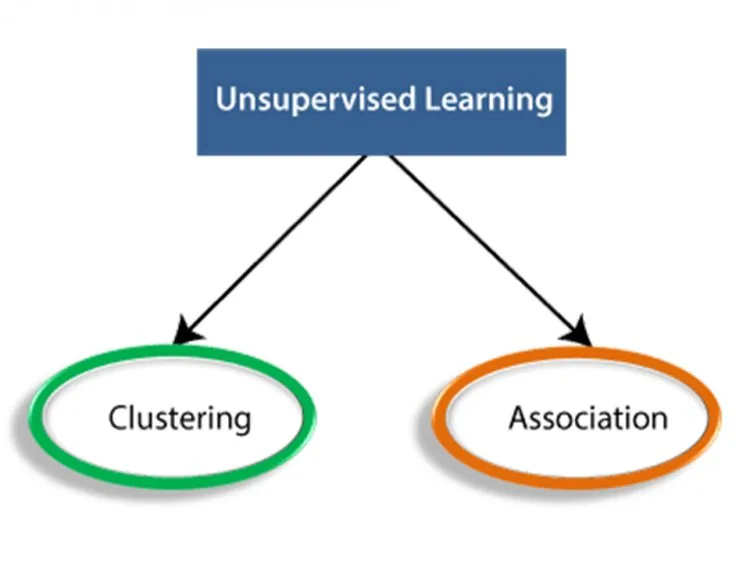
A seguir estão as categorias do aprendizado não supervisionado.
- Clusterização
- Associação
Quais são as vantagens do aprendizado supervisionado?
- É capaz de enxergar o que o cérebro humano não consegue.
- É usado para descobrir características ocultas que são essenciais para o negócio e tem diversas aplicações reais.
- Uma tarefa não controlada pode resultar na criação de um segmento de mercado ou de uma empresa totalmente novos.
- Em comparação com o problema de aprendizado supervisionado, há menos complexidade. Como ninguém precisa entender os rótulos associados, as complicações são reduzidas.
- O conjunto de dados é muito mais fácil de obter.
Quais são as desvantagens do aprendizado supervisionado?
- É mais caro, pois pode ser necessária a participação humana para compreender as tendências e relacioná-las usando conhecimento do domínio.
- Como não há rótulo nem métrica de saída para atestar sua utilidade, muitas vezes não há garantia de que os resultados gerados sejam benéficos.
- O tipo e as saídas de uma tarefa não supervisionada não podem ser definidos com precisão. Ela depende muito do projeto e, consequentemente, do computador.
- Muitas vezes falta precisão nos resultados.
Conclusão:
O aprendizado não supervisionado é uma abordagem de machine learning em que o modelo não precisa de supervisão. O machine learning não supervisionado ajuda a descobrir padrões nos dados que antes não eram conhecidos.
- Pratt, M.K. unsupervised learning. Disponível em: https://www.techtarget.com/searchenterpriseai/definition/unsupervised-learning.
- Unsupervised Machine Learning. Disponível em: https://www.javatpoint.com/unsupervised-machine-learning.
Tarefas comuns de aprendizado não supervisionado
- Clusterização: agrupar itens semelhantes, por exemplo segmentos de clientes para marketing. Algoritmos populares: k-means, clusterização hierárquica e DBSCAN.
- Redução de dimensionalidade: comprimir muitas características em poucas mantendo a estrutura, usando métodos como PCA.
- Regras de associação: encontrar itens frequentemente comprados juntos, como na análise de cesta de compras.
- Detecção de anomalias: identificar transações ou leituras de sensores incomuns.
Exemplos de negócios
Um varejista pode agrupar clientes por comportamento de compra para personalizar ofertas, uma loja pode descobrir produtos que vendem juntos para colocá-los lado a lado, e um banco pode sinalizar atividades incomuns no cartão. Análises de varejo como essas fazem parte do nosso serviço de análise com IA.
Aprendizado não supervisionado vs supervisionado
O aprendizado supervisionado precisa de dados rotulados e prevê uma resposta conhecida; o aprendizado não supervisionado não tem rótulos e busca estruturas ocultas. Leia sobre aprendizado supervisionado e aprendizado semissupervisionado para ver o contraste.
Respostas rápidas
A clusterização é supervisionada ou não supervisionada?
A clusterização é não supervisionada porque os grupos são descobertos, não fornecidos.


