
引言:
计算机可以利用以往记录中的模式和算法进行学习和适应。在没有明确指令的情况下,计算机会对以往数据进行分析和推断,并基于现有记录预测未来结果。但在无监督学习中,您无需像监督式机器学习那样提供已标注数据或训练机器。
什么是无监督学习?
无监督学习也称为无监督机器学习。使用无监督学习时,您无需训练数据。提供给机器的数据没有标注。机器会自行从这些未标注数据中预测出模式和各种信息,并预测出解决问题所需的隐藏分组及其他信息。[1]
监督学习有哪些示例?
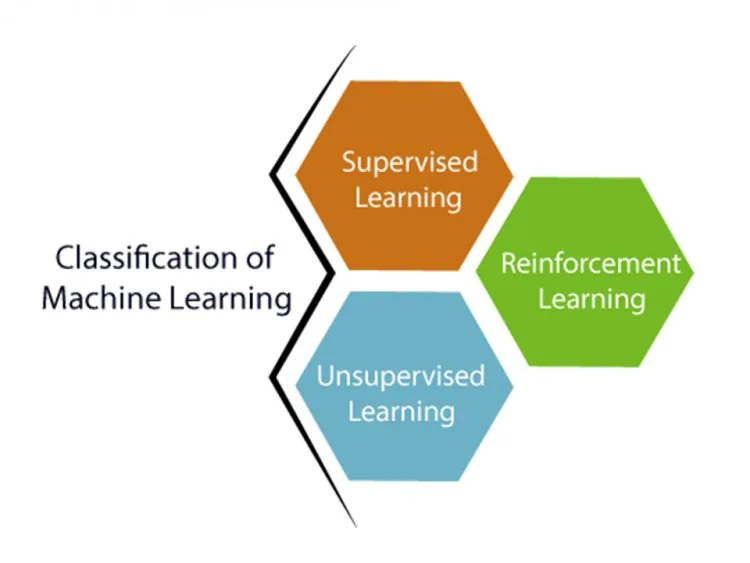
与监督学习相反,当变量(即标签)未提供时,适合采用无监督学习策略。K-Means 聚类、主成分分析和层次聚类都是无监督学习技术的例子。
监督学习是如何工作的?
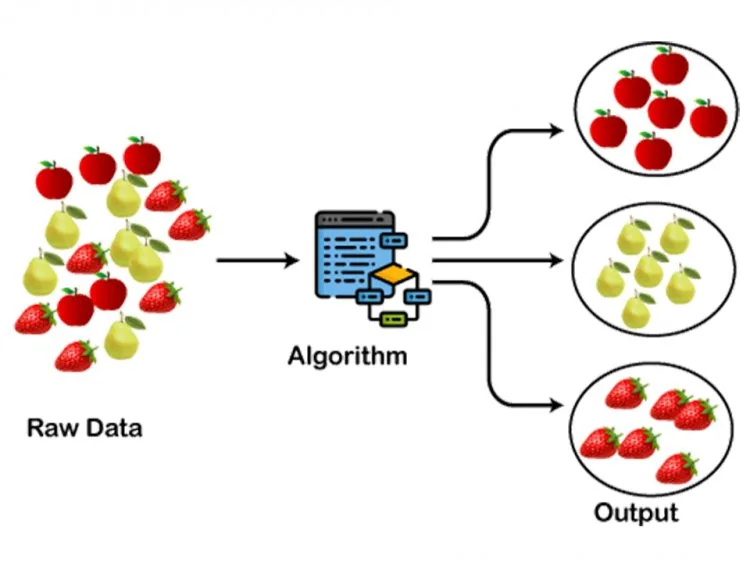
如上所述,无监督学习中提供的数据集没有被恰当地标注。这意味着数据没有分类,也没有给出对应的输出。机器会自行训练:首先解读原始数据以发现其中的隐藏模式,然后对数据应用合适的算法。算法运行完毕后,数据对象会根据各组之间的相似性被划分为不同的组。[2]
无监督学习有哪些类别?
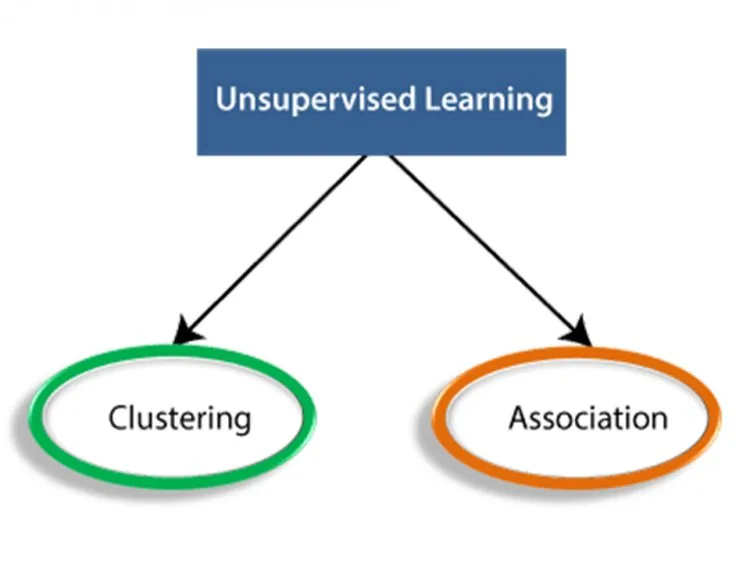
以下是无监督学习所包含的类别。
- 聚类
- 关联
监督学习有哪些优点?
- 它能够发现人脑无法发现的东西。
- 它被用于发掘对业务至关重要的隐藏特征,并有多种实际应用。
- 不受控的任务可能会催生一个全新的公司业务板块或企业。
- 与监督学习问题相比,复杂度更低。由于无需有人去理解相关联的标签,复杂性随之降低。
- 数据集更容易获得。
监督学习有哪些缺点?
- 它成本更高,因为可能需要人工参与来理解趋势,并借助领域专业知识将其关联起来。
- 由于没有标签或输出指标来验证其有用性,所生成的结果通常无法保证是有益的。
- 无监督任务的类型和输出无法被精确定义。它高度依赖于设计,因而也依赖于计算机。
- 结果的精确度往往不足。
结论:
无监督学习是一种无需监督模型的机器学习方法。无监督机器学习有助于发现数据中此前未被发现的模式。
- Pratt, M.K.,无监督学习。来源:https://www.techtarget.com/searchenterpriseai/definition/unsupervised-learning。
- 无监督机器学习。来源:https://www.javatpoint.com/unsupervised-machine-learning。
常见的无监督学习任务
- 聚类:对相似项目进行分组,例如用于营销的客户细分。常用算法:k-means、层次聚类和 DBSCAN。
- 降维:在保留结构的同时,将众多特征压缩为少数几个,使用 PCA 等方法。
- 关联规则:找出经常一起购买的商品,例如购物篮分析。
- 异常检测:发现异常交易或传感器读数。
业务示例
零售商可以按购买行为对客户进行聚类,从而量身定制优惠;商店可以找出一起畅销的商品并将其并排摆放;银行可以标记异常的刷卡活动。此类零售分析属于我们的AI 分析服务。
无监督学习与监督学习
监督学习需要已标注数据并预测已知答案;无监督学习没有标签,而是寻找隐藏结构。请阅读监督学习和半监督学习以了解二者的对比。
快速解答
聚类是监督学习还是无监督学习?
聚类属于无监督学习,因为分组是被发现的,而不是预先给定的。


