
سپروائزڈ لرننگ، جسے سپروائزڈ مشین لرننگ بھی کہا جاتا ہے، مشین لرننگ اور مصنوعی ذہانت کی ایک ذیلی قسم ہے
تعارف:
وقت گزرنے کے ساتھ انسان اپنے تجربے سے سیکھتے ہیں اور اسی تجربے کی بنیاد پر فیصلہ کرتے ہیں۔ مشین لرننگ کے کام کرنے کے طریقے کی طرح، پچھلے ریکارڈز کے پیٹرنز اور الگورتھمز استعمال کر کے کمپیوٹر سیکھ اور خود کو ڈھال سکتا ہے۔ آپ کا کمپیوٹر واضح ہدایات کے بغیر پچھلے ڈیٹا کا تجزیہ اور اس سے استنباط کرتا ہے، اور موجودہ ریکارڈز کی بنیاد پر مستقبل کے نتائج کا اندازہ لگاتا ہے۔
مشین لرننگ کیا ہے؟
Machine learning ڈیٹا کی تحقیق کی ایک قسم ہے جو تشخیصی ماڈلز کی تشکیل کو خودکار بناتی ہے۔ یہ ایک ایسا نظام ہے جو ڈیٹا سے معلومات نکال سکتا ہے، پیٹرنز کی تشخیص کر سکتا ہے اور بہت کم یا بغیر سماجی مداخلت کے نتائج اخذ کر سکتا ہے۔ artificial intelligence کے استعمال کی بدولت یہ نظام واضح کوڈنگ کے بغیر سیکھنے اور ارتقا کرنے کے قابل ہے۔
سپروائزڈ لرننگ کیا ہے؟
Artificial intelligence سپروائزڈ لرننگ کے ذریعے تخلیق کی جاتی ہے۔ اس طریقے میں کمپیوٹر کے الگورتھمز کو کسی مخصوص نتیجے کے لیے (مناسب طور پر لیبل شدہ) ڈیٹا فراہم کر کے تربیت دی جاتی ہے۔ ڈیٹا کو اس وقت تک تربیت دی جاتی ہے جب تک کہ وہ پیٹرنز کو پہچاننے اور ان پٹ ڈیٹا اور آؤٹ پٹ لیبلز کے درمیان تعلق متعین کرنے کے قابل نہ ہو جائے۔ ہم اسے کسی دیے گئے لیبل کے لیے درست نتیجہ متعین کرنے کے لیے استعمال کر سکتے ہیں۔
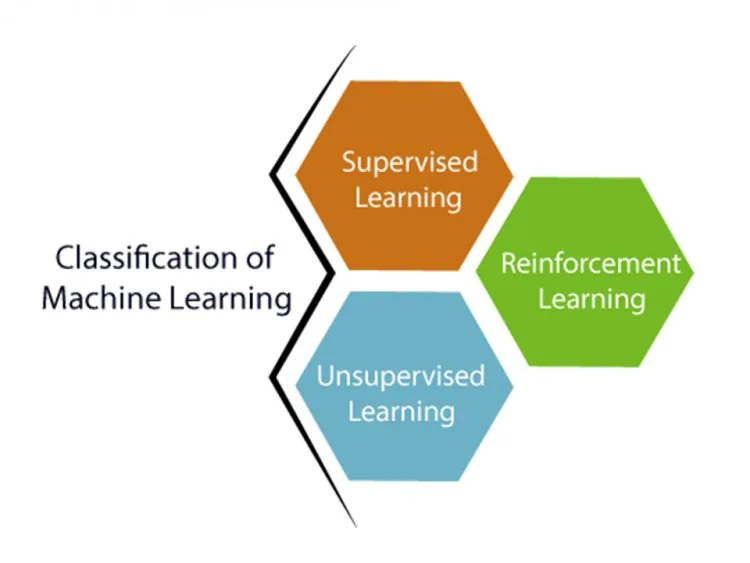
سپروائزڈ لرننگ کی کچھ مثالیں کیا ہیں؟
مختصراً، سپروائزڈ لرننگ وہ ہے جب ہمارے پاس ایک استاد ہو جو اچھی طرح لیبل شدہ ڈیٹا کے ذریعے مشین کو تربیت دے۔ سپروائزڈ لرننگ کے طریقے سے کمپیوٹر کو مثالوں (ڈیٹا) کا ایک نیا گروہ یا تعداد دی جاتی ہے تاکہ وہ تربیتی ڈیٹا (تربیت یا تیاری کی مثالوں کا سیٹ) کا تجزیہ کرے اور لیبل شدہ ڈیٹا سے مناسب نتیجہ تیار کرے۔
سپروائزڈ لرننگ کیسے کام کرتی ہے؟
سپروائزڈ لرننگ میں ہم لیبل شدہ ڈیٹا سیٹ استعمال کر کے ماڈل کو تربیت دیتے ہیں۔ ماڈل کو ہر قسم کے ڈیٹا کے مطابق تربیت دی جاتی ہے۔ تربیت کا عمل مکمل ہونے پر ہم تربیت یافتہ ماڈل کو ٹیسٹ ڈیٹا کے ساتھ جانچتے ہیں۔ پچھلی تربیت کی بنیاد پر مشین آؤٹ پٹ کی پیش گوئی کرتی ہے۔
فرض کریں ہمارے پاس ایک ڈیٹا سیٹ ہے جس میں مختلف اشکال ہیں، جیسے مربع، مستطیل اور کثیر الاضلاع۔ کلاسیکی ماڈل کو ابتدائی مرحلے کے طور پر ہر شکل کے لیے تربیت دینا ضروری ہے۔
- اگر کسی مخصوص شکل کے چار کنارے یا کونے ہوں اور وہ سب برابر ہوں تو وہ مربع کہلاتی ہے۔
- اگر پورے عمل میں تین اطراف ہوں تو اسے مثلث کا لیبل دیا جائے گا۔
- جب داخل کی گئی شکل کے چھ برابر اضلاع ہوں تو وہ مسدس کہلاتی ہے۔
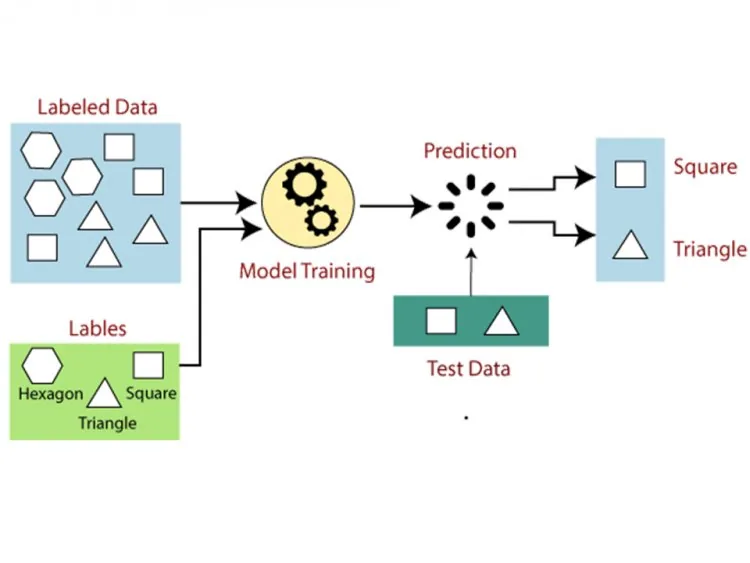
تربیت کے بعد، ہم اپنے ماڈل کو آزمانے کے لیے ٹیسٹ سیٹ استعمال کرتے ہیں، اور ماڈل کا مقصد شکل کو پہچاننا ہوتا ہے۔
نظام کو پہلے ہی مختلف اشکال میں سکھایا جا چکا ہے، اور جب اسے کوئی نئی شکل ملتی ہے تو وہ اس کی درجہ بندی کرتا ہے۔[1]
مشین لرننگ میں کون سے مراحل شامل ہیں؟
- پہلے، اس تربیتی ڈیٹا سیٹ کی قسم کا تعین کریں جو آپ استعمال کریں گے۔
- لیبل شدہ تربیتی ڈیٹا کو جمع اور اکٹھا کر کے حاصل کریں۔
- تربیتی ڈیٹا سیٹ کو تین حصوں میں تقسیم کریں: تربیت، ٹیسٹنگ اور ویلیڈیشن۔
- تربیتی ڈیٹا سیٹ کی ان پٹ خصوصیات کا تعین کریں، جن میں ماڈل کے لیے آؤٹ پٹ کی کامیابی سے پیش گوئی کرنے کی کافی معلومات ہونی چاہئیں۔
- ماڈل کے لیے مناسب الگورتھم منتخب کریں، جیسے سپورٹ ویکٹر مشین یا ڈیسیژن ٹری۔
- الگورتھم چلانے کے لیے تربیتی ڈیٹا سیٹ کی مشق کریں۔ ویلیڈیشن سیٹس، جو تربیتی ڈیٹا سیٹس کا ایک ذیلی حصہ ہوتے ہیں، کبھی کبھار ریگولیٹرز یا کنٹرول پیرامیٹرز کے طور پر درکار ہوتے ہیں۔
- ٹیسٹ سیٹ دے کر آپ ماڈل کی درستگی کا جائزہ لے سکتے ہیں۔ اگر ماڈل نتیجے کی درست پیش گوئی کرے تو ہمارا ماڈل درست ہے۔
سپروائزڈ لرننگ کی اقسام کیا ہیں؟
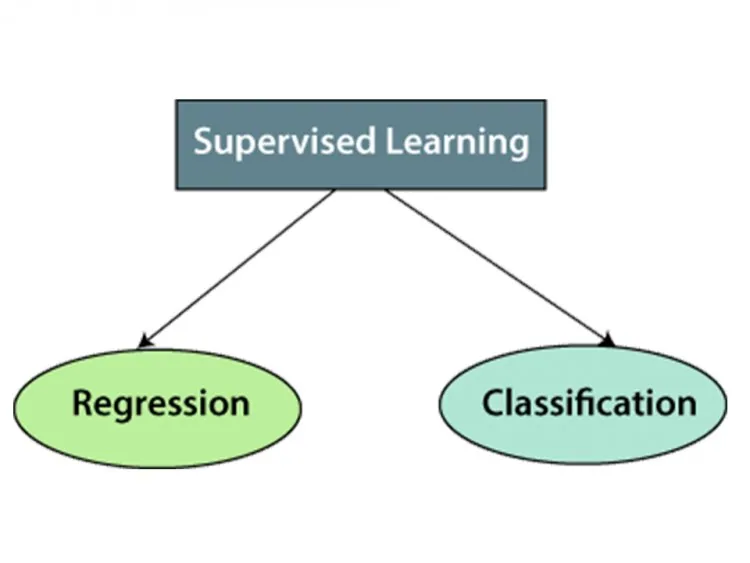
سپروائزڈ لرننگ کی درج ذیل اقسام ہیں۔
- ریگریشن
- کلاسیفکیشن
سپروائزڈ لرننگ کے فوائد کیا ہیں؟
- تدریسی ڈیٹا میں آپ کو ادوار کی تفصیلی رائے ملے گی۔
- آپ کو سمجھنے کے قابل ہونا چاہیے کہ سپروائزڈ لرننگ کا طریقہ کار کیسے کام کرتا ہے۔ جب بات ان سپروائزڈ لرننگ کی آتی ہے تو ہمیں ہمیشہ معلوم نہیں ہوتا کہ مشین کے اندر کیا چل رہا ہے، یہ کیسے سیکھ رہی ہے، وغیرہ۔
- تربیت کے لیے ڈیٹا کے حوالے کرنے سے پہلے، آپ کلاسز کی تفصیلی تعداد کو منضبط کر سکتے ہیں۔
- آپ کلاسز کے معنی کے بارے میں بالکل درست ہو سکتے ہیں، یعنی آپ کلاسیفائر کو اس طریقے سے تربیت دے سکتے ہیں کہ اس کی فیصلہ کن حد بے عیب ہو اور وہ مختلف کلاسز کے درمیان قابل اعتماد طور پر فرق کر سکے۔
- ایک بار پورا پروگرام مکمل ہو جانے کے بعد آپ کو تدریسی ڈیٹا اپنی یادداشت میں رکھنے کی ضرورت نہیں۔ اس کے بجائے، آپ فیصلہ کن حدود کو محفوظ رکھنے کے لیے ریاضیاتی فارمولا استعمال کر سکتے ہیں۔[2]
سپروائزڈ لرننگ کے نقصانات کیا ہیں؟
- مختلف طریقوں سے سپروائزڈ لرننگ غیر فطری ہے، اور یہ مشین لرننگ کے کچھ زیادہ پیچیدہ کام انجام نہیں دے سکتی۔
- سپروائزڈ لرننگ، ان سپروائزڈ لرننگ کے برعکس، تربیتی ڈیٹا سے نامعلوم معلومات نہیں نکال سکتی۔
- ان سپروائزڈ لرننگ کے برعکس؛ یہ اپنی خصوصیات خود متعین کر کے ڈیٹا کو کلسٹر یا درجہ بند نہیں کر سکتی۔
- جب بات کلاسیفکیشن کی آتی ہے، اگر ہم ایسا ان پٹ دیں جو تربیتی ڈیٹا کی کسی بھی کلاس سے نہ ہو، تو نتیجہ غلط کلاس لیبل ہو سکتا ہے۔ تصور کریں کہ آپ نے بلیوں اور کتوں کے ڈیٹا سے ایک امیج کلاسیفائر کو تربیت دی۔ اگر آپ زرافے کی تصویر دیں تو نتیجہ بلی یا کتا ہو سکتا ہے، جو غلط ہے۔
- فرض کریں آپ کے تعلیمی سیٹ میں کچھ مثالیں غائب ہیں اور آپ ایک سبق شامل کرنا چاہتے ہیں۔ پھر، سیکھنے کے بعد، جب آپ ان نمونوں کو استعمال کریں گے تو شاید آپ کو ان پٹ کے طور پر درست کلاس لیبل نہ ملے۔
نتیجہ:
سپروائزڈ لرننگ درجہ بندی اور ریگریشن کے مسائل میں بہترین ہے، جیسے خبر کے مضمون کی درجہ بندی طے کرنا یا مستقبل کی کسی تاریخ کے لیے ٹرانزیکشنز کی تعداد کی پیش گوئی کرنا۔ سپروائزڈ عمل کا مقصد کسی مخصوص مسئلے کے تناظر میں ڈیٹا کے معنی سیکھنا ہے۔
- Supervised Machine Learning۔ دستیاب ہے: https://www.javatpoint.com/supervised-machine-learning۔
- Petersson, D.supervised learning۔ دستیاب ہے: https://www.techtarget.com/searchenterpriseai/definition/supervised-learning۔
سپروائزڈ لرننگ کی دو اہم اقسام
- کلاسیفکیشن: کسی زمرے کی پیش گوئی، جیسے اسپام یا غیر اسپام، یا کوئی ٹرانزیکشن فراڈ ہے یا نہیں۔
- ریگریشن: کسی عدد کی پیش گوئی، جیسے مکان کی قیمت یا اگلے مہینے کی سیلز۔
عام الگورتھمز
لینیئر اور لاجسٹک ریگریشن، ڈیسیژن ٹریز، رینڈم فاریسٹس، سپورٹ ویکٹر مشینیں، k-nearest neighbours اور نیورل نیٹ ورکس۔
ایک سادہ مثال
یہ پیش گوئی کرنے کے لیے کہ آیا کوئی کسٹمر قسط تاخیر سے ادا کرے گا، آپ ایک ماڈل کو ان ماضی کے کسٹمرز پر تربیت دیتے ہیں جن کا نتیجہ معلوم ہے (بروقت ادا یا تاخیر سے) اور آمدنی کا بینڈ، ایڈوانس ادائیگی اور پچھلے رویے جیسی خصوصیات استعمال کرتے ہیں۔ پھر ماڈل نئے کسٹمرز کو اسکور دیتا ہے۔ Installment Management System جیسے قسطوں کے ٹولز بالکل اسی قسم کا ڈیٹا رکھتے ہیں۔
خوبیاں اور حدود
سپروائزڈ لرننگ اس وقت درست ہوتی ہے جب آپ کے پاس اچھا لیبل شدہ ڈیٹا ہو، لیکن لیبلنگ مہنگی ہے اور ماڈل صرف وہی سیکھتا ہے جو لیبلز ظاہر کرتے ہیں۔ اس کا موازنہ unsupervised learning اور reinforcement learning سے کریں۔
فوری جوابات
اوورفٹنگ کیا ہے؟
اوورفٹنگ اس وقت ہوتی ہے جب ماڈل تربیتی ڈیٹا کو رٹ لیتا ہے اور نئے ڈیٹا پر ناقص کارکردگی دکھاتا ہے۔ اسے زیادہ ڈیٹا، سادہ ماڈلز اور ویلیڈیشن کے ذریعے کم کیا جاتا ہے۔


