
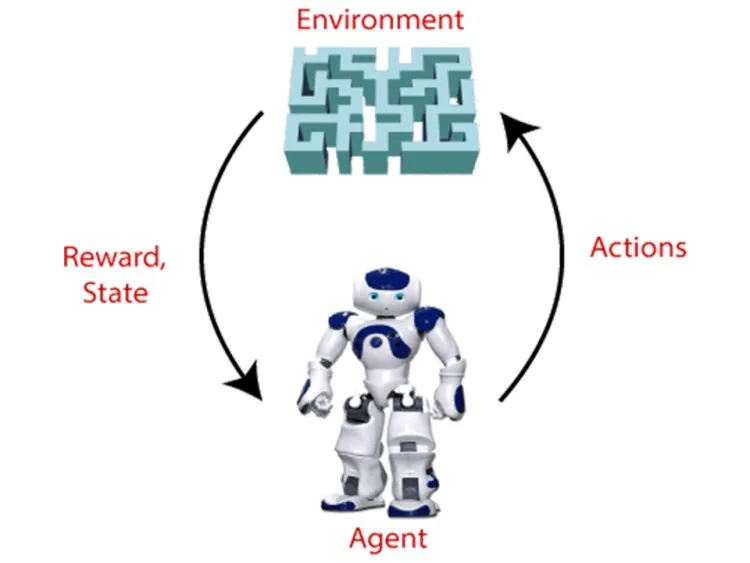
تعارف:
ری انفورسمنٹ لرننگ supervised اور unsupervised learning کے درمیان ہے۔ یہ باضابطہ اور تکنیکی طور پر سپروائزڈ لرننگ نہیں ہے کیونکہ یہ صرف لیبل شدہ تربیتی ڈیٹا کے مجموعے پر منحصر نہیں، لیکن یہ ان سپروائزڈ لرننگ بھی نہیں ہے کیونکہ ہم دیکھ رہے ہوتے ہیں کہ ہمارا ایجنٹ انعام سے فائدہ اٹھائے۔ اپنے بنیادی مقصد پر اثر انداز ہونے کے لیے، ایجنٹ کو مختلف منظرناموں میں انجام دینے کے لیے "درست" کارکردگی اور رویے کا انتخاب کرنا ہوتا ہے۔
ری انفورسمنٹ مشین لرننگ کیا ہے؟
ری انفورسمنٹ لرننگ machine learning کی وہ قسم ہے جس میں مشینیں کسی مخصوص ماحول میں اپنے انعام کو زیادہ سے زیادہ کرنے کے لیے بہترین رویہ یا مناسب عمل سیکھتی ہیں۔ اس رویے میں مشین ماحول کے ساتھ تعامل اور مشاہدے سے سیکھتی ہے کہ کیسے جواب دینا ہے۔
ری انفورسمنٹ لرننگ سپروائزڈ لرننگ سے اس طرح مختلف ہے کہ سپروائزڈ لرننگ میں جوابات کی شیٹ موجود ہوتی ہے، جس سے ماڈل کو درست جواب کے ساتھ تربیت دی جا سکتی ہے، جبکہ ری انفورسمنٹ لرننگ میں جواب نہیں ہوتا اور اس کی جگہ ری انفورسمنٹ ایجنٹ پر انحصار ہوتا ہے کہ وہ کام مکمل کرنے کے لیے کیا کرنا ہے اس کا فیصلہ کرے۔ اسے تربیتی ڈیٹا سیٹ کی غیر موجودگی میں اپنے علم سے خود کو ڈھالنا پڑتا ہے۔
ری انفورسمنٹ لرننگ کیسے کام کرتی ہے؟
ری انفورسمنٹ لرننگ کے مسئلے میں ایک ایجنٹ کسی ہدف کو حاصل کرنے کے لیے ایک ناواقف ماحول کو کھنگالتا ہے۔ ری انفورسمنٹ لرننگ اس خیال پر مبنی ہے کہ متوقع مجموعی انعام کو زیادہ سے زیادہ کرنا کسی بھی مقصد کی نمائندگی کے لیے استعمال ہو سکتا ہے۔ انعام کو زیادہ سے زیادہ کرنے کے لیے ایجنٹ کو اپنی سرگرمیوں کے ذریعے ماحول کی حالت کو سمجھنا اور اس پر اثر انداز ہونا سیکھنا ہوتا ہے۔
RL کے عمل کو سمجھنے کے لیے ہمیں دو بڑے عوامل کا جائزہ لینا ہوگا:
ماحول: یہ کوئی کمرہ، بھول بھلیاں، فٹ بال کا میدان یا کچھ اور بھی ہو سکتا ہے۔
ایجنٹ: ایک ذہین ایجنٹ، جیسے AI روبوٹ، ایجنٹ کہلاتا ہے۔
مثال کے طور پر، ایک بھول بھلیاں کا ماحول لیں جسے ایجنٹ کو عبور کرنا ہے۔ درج ذیل مثال پر غور کریں:
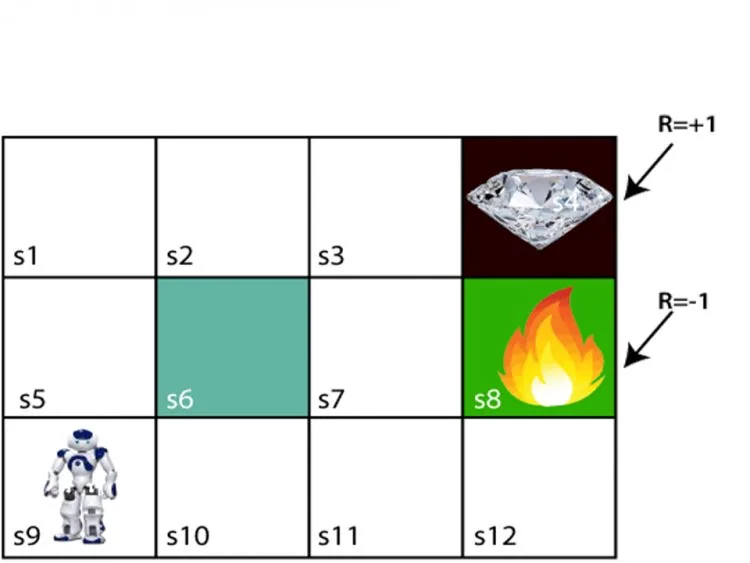
اوپر کی تصویر میں ایجنٹ بھول بھلیاں کے پہلے بلاک پر ہے۔ بھول بھلیاں ایک S6 بلاک، جو دیوار ہے، ایک S8 بلاک، جو آگ کا گڑھا ہے، اور ایک S4 بلاک، جو ہیرے کا بلاک ہے، پر مشتمل ہے۔
ایجنٹ S6 بلاک سے نہیں گزر سکتا کیونکہ یہ ایک ٹھوس دیوار ہے۔ اگر ایجنٹ S4 بلاک تک پہنچ جائے تو اسے +1 انعام ملے گا، جبکہ اگر وہ آگ کے گڑھے تک پہنچے تو اسے -1 انعام ملے گا۔ وہ چار مختلف سمتوں میں اوپر، نیچے، بائیں اور دائیں حرکت کر سکتا ہے۔
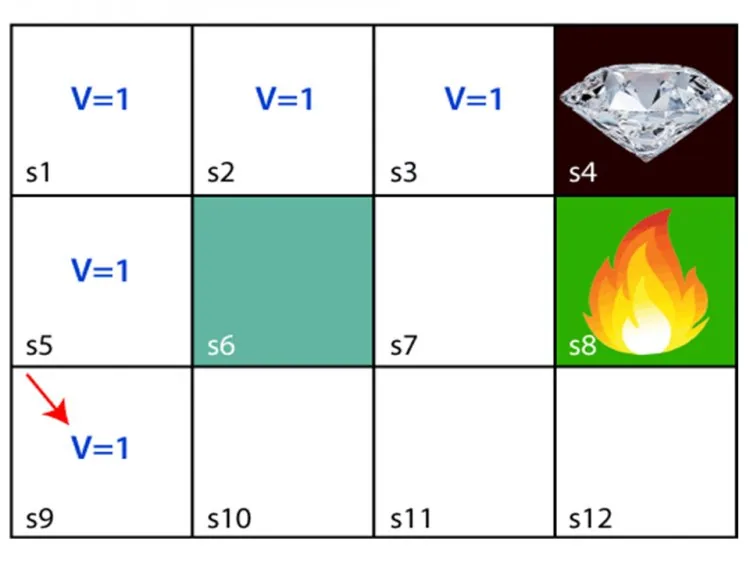
ایجنٹ منزل تک پہنچنے کے لیے کوئی بھی راستہ چن سکتا ہے، لیکن اسے کم سے کم قدموں میں ایسا کرنا ہوگا۔ اگر ایجنٹ S9-S5-S1-S2-S3 راستہ اختیار کرے تو اسے +1 انعامی پوائنٹ ملے گا۔
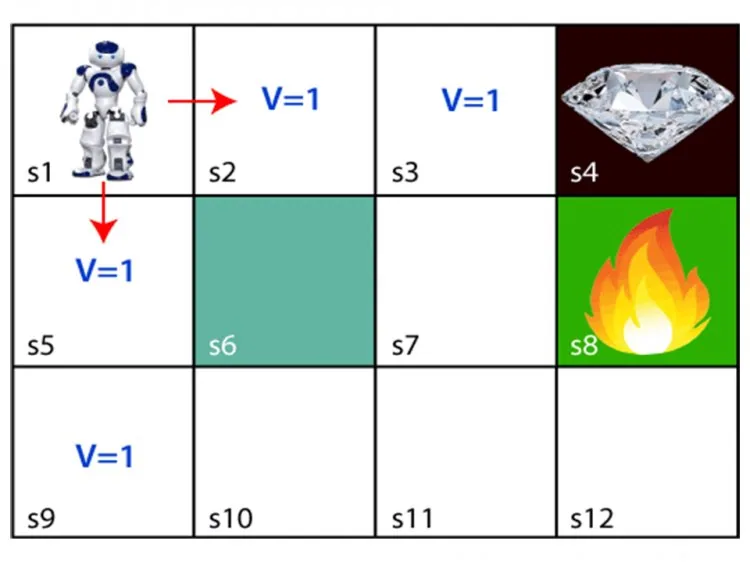
ایجنٹ ان ادوار کو یاد رکھنے کی کوشش کرے گا جو یہاں تک لائے۔ وہ انہیں یاد رکھنے کے لیے ہر پچھلے قدم کو 1 کی قدر دیتا ہے۔[1]
ری انفورسمنٹ لرننگ کی اقسام کیا ہیں؟
ری انفورسمنٹ لرننگ کی صرف دو اقسام ہیں، جو درج ذیل ہیں:
- مثبت:
جب کسی مخصوص رویے کے نتیجے میں کوئی واقعہ پیش آتا ہے تو ری انفورسمنٹ اس رویے کی شدت اور تعدد کو بڑھاتی ہے۔ دوسرے لفظوں میں، اس کا رویے پر مفید اثر ہوتا ہے۔
- منفی:
ری انفورسمنٹ وہ ہے جب کسی منفی صورتحال سے بچنے یا اس کے رک جانے کے نتیجے میں کسی رویے کو تقویت ملتی ہے۔
ری انفورسمنٹ لرننگ کی مثالیں کیا ہیں؟
روبوٹکس:
پہلے سے پروگرام شدہ رویے والے روبوٹس منظم ماحول میں بار بار دہرائے جانے والے کاموں کے لیے مؤثر ہوتے ہیں، جیسے کار بنانے والی فیکٹری کی اسمبلی لائن۔ حقیقی دنیا میں درست رویے پہلے سے پروگرام کرنا تقریباً ناممکن ہے، جہاں روبوٹ کی سرگرمی پر ماحول کا ردعمل نامعلوم ہوتا ہے۔ ایسے معاملات میں RL عمومی مقصد کے روبوٹس بنانے کی ایک تیز اور آسان تکنیک فراہم کرتی ہے۔ یہ روبوٹک راستے کی منصوبہ بندی میں مؤثر طور پر استعمال ہوئی ہے، جہاں روبوٹ کو دو نقطوں کے درمیان ایک مختصر، ہموار اور قابل گزر راستہ تلاش کرنا ہوتا ہے جو ٹکراؤ سے پاک ہو اور روبوٹ کی حرکیات کے مطابق ہو۔
خود مختار ڈرائیونگ:
بدلتے ہوئے ماحول میں، خود مختار ڈرائیونگ سسٹم کو بہت سے ادراکی اور تیاری کے کام انجام دینے ہوتے ہیں۔ گاڑی کے راستے کی تیاری اور حرکت کی پیش گوئی ان سرگرمیوں کی دو مثالیں ہیں جہاں RL استعمال ہو سکتی ہے۔ مختلف زمانی اور جغرافیائی پیمانوں پر فیصلے کرنے کے لیے گاڑی کے راستے کی منصوبہ بندی کو کئی نچلی اور اعلیٰ سطح کے اصولوں کی ضرورت ہوتی ہے۔ لوگوں اور دیگر گاڑیوں کی حرکت کی پیش گوئی کا چیلنج، تاکہ یہ سمجھا جا سکے کہ ماحول کی موجودہ حالت کے لحاظ سے صورتحال کیسے آگے بڑھ سکتی ہے، حرکت کی پیش گوئی کہلاتا ہے۔
ری انفورسمنٹ لرننگ کے فوائد کیا ہیں؟
- ری انفورسمنٹ لرننگ کو انتہائی پیچیدہ مسائل حل کرنے کے لیے استعمال کیا جا سکتا ہے جنہیں روایتی طریقوں سے حل کرنا ناممکن ہے۔
- یہ طریقہ مشکل سے حاصل ہونے والے طویل مدتی نتائج کے حصول کے لیے پسندیدہ ہے۔
- یہ لرننگ پیراڈائم انسانی سیکھنے سے بہت مشابہ ہے۔ نتیجتاً، یہ کمال حاصل کرنے کی دہلیز پر ہے۔
- ماڈل تربیتی مرحلے کے دوران ہونے والی غلطیوں کی اصلاح کی صلاحیت رکھتا ہے۔
- ایک بار جب ماڈل کسی غلطی کو درست کر لیتا ہے تو دوبارہ غلطی ہونے کا امکان بہت کم ہوتا ہے۔
- یہ کسی مخصوص مسئلے سے نمٹنے کے لیے مثالی ماڈل ڈیزائن کرنے کی صلاحیت رکھتی ہے۔
- چلنا سیکھنے کے لیے روبوٹس ری انفورسمنٹ لرننگ الگورتھمز استعمال کر سکتے ہیں۔
- ری انفورسمنٹ لرننگ کا مقصد کسی مخصوص صورتحال میں ماڈل کے بہترین رویے کو حاصل کر کے اس کی کارکردگی کو زیادہ سے زیادہ کرنا ہے۔
- جب ماحول کے بارے میں علم حاصل کرنے کا واحد طریقہ اس کے ساتھ تعامل ہو تو یہ قیمتی ہو سکتی ہے۔[2]
ری انفورسمنٹ لرننگ کے نقصانات کیا ہیں؟
- ایک فریم ورک کے طور پر ری انفورسمنٹ لرننگ کئی لحاظ سے غلط ہے، مگر یہی خامی اسے مؤثر بناتی ہے۔
- حد سے زیادہ ری انفورسمنٹ لرننگ کے نتیجے میں حالتوں کی بہتات ہو سکتی ہے، جس سے افادیت اور مؤثریت کم ہو جاتی ہے۔
- بنیادی کاموں کے لیے یہ بہترین انتخاب نہیں ہے۔
- ری انفورسمنٹ لرننگ کو بڑی مقدار میں ڈیٹا اور کمپیوٹیشن درکار ہوتی ہے۔ اس کی اعداد و شمار کی بھوک ختم نہ ہونے والی ہے۔ اسی لیے یہ ویڈیو گیمز میں اتنی اچھی کام کرتی ہے کیونکہ گیم بار بار کھیلا جا سکتا ہے، اور بڑی مقدار میں ڈیٹا حاصل کرنا ممکن نظر آتا ہے۔
- ری انفورسمنٹ لرننگ کو مکمل طور پر ترک کرنے کے بجائے، ہم بہت سے مسائل سے نمٹنے کے لیے ری انفورسمنٹ لرننگ اور دیگر طریقوں کا امتزاج استعمال کر سکتے ہیں۔ ری انفورسمنٹ لرننگ اور ڈیپ لرننگ ایک عام امتزاج ہے۔
نتیجہ:
ری انفورسمنٹ لرننگ بہت کم یا بغیر ڈیٹا کے خود مختار ایجنٹس کے لیے کنٹرول کے طریقے سیکھنے کی مشکل کو حل کرتی ہے۔ چونکہ نمونوں کے وسیع مجموعے کو جمع کرنا اور لیبل کرنا خود ڈیٹا سے زیادہ مہنگا ہوتا ہے، RL الگورتھمز مشین لرننگ میں مفید ہیں۔ فیصلے ری انفورسمنٹ لرننگ کے ذریعے کیے جاتے ہیں۔ یہ ایک ذہین نظام کے لیے ممکن بناتی ہے کہ وہ نئی مصروفیات یا طریقے آزمائے، ناکامیاں ہونے پر راستہ بدلے، اور پورے کاروبار یا نظام کا سمولیشن بنا کر کامیابیوں پر آگے بڑھے۔
- Reinforcement Learning Tutorial۔ دستیاب ہے: https://www.javatpoint.com/reinforcement-learning۔
- Pros and Cons of Reinforcement Learning۔ دستیاب ہے: https://pythonistaplanet.com/pros-and-cons-of-reinforcement-learning/۔
ری انفورسمنٹ لرننگ کا چکر
- ایک ایجنٹ اپنے ماحول کی موجودہ حالت کا مشاہدہ کرتا ہے۔
- یہ ایک عمل کرتا ہے۔
- ماحول ایک انعام (مثبت یا منفی) اور ایک نئی حالت واپس کرتا ہے۔
- ایجنٹ وقت کے ساتھ زیادہ انعام حاصل کرنے کے لیے اپنی پالیسی اپ ڈیٹ کرتا ہے۔
حقیقی دنیا کی مثالیں
- گیمز: ایسے سسٹمز جنہوں نے خود کے خلاف کھیل کر Go اور ویڈیو گیمز کھیلنا سیکھا۔
- روبوٹکس: روبوٹس جو چلنا یا اشیاء کو پکڑنا سیکھتے ہیں۔
- سفارشات اور اشتہارات: طویل مدتی مصروفیت کو زیادہ سے زیادہ کرنے کے لیے یہ منتخب کرنا کہ کیا دکھانا ہے۔
- وسائل کا انتظام: ڈیٹا سینٹر کی کولنگ اور ٹریفک سگنل کنٹرول۔
- لینگویج ماڈلز: انسانی فیڈ بیک کے ساتھ فائن ٹیوننگ تاکہ زیادہ مفید جوابات دیے جا سکیں۔
ری انفورسمنٹ بمقابلہ سپروائزڈ بمقابلہ ان سپروائزڈ لرننگ
سپروائزڈ لرننگ لیبل شدہ مثالوں سے سیکھتی ہے (supervised learning)؛ ان سپروائزڈ لرننگ بغیر لیبل ڈیٹا میں ساخت تلاش کرتی ہے (unsupervised learning)؛ ری انفورسمنٹ لرننگ انعامات سے آزمائش اور غلطی کے ذریعے سیکھتی ہے۔ جائزہ what is machine learning میں دیکھیں۔
فوری جوابات
ریوارڈ فنکشن کیا ہے؟
ایک اصول جو یہ جانچتا ہے کہ کوئی عمل یا نتیجہ کتنا اچھا ہے۔ اسے اچھی طرح ڈیزائن کرنا ری انفورسمنٹ لرننگ کے مشکل ترین حصوں میں سے ایک ہے۔


