
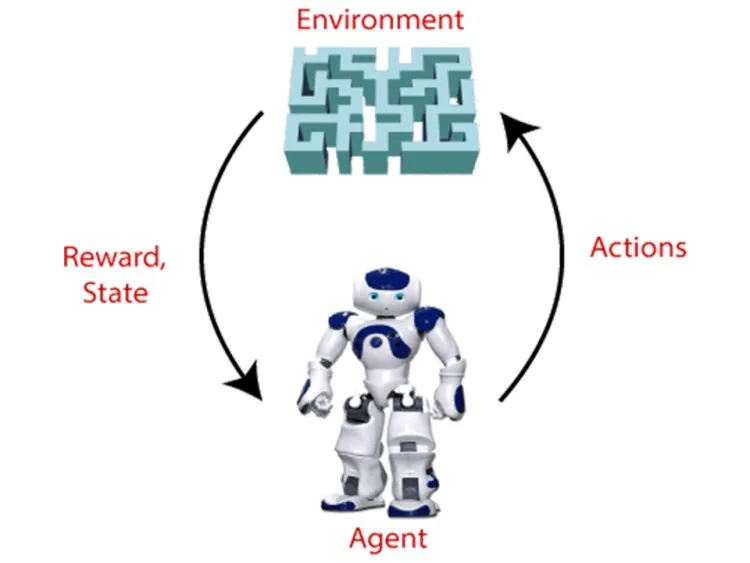
Введение:
Обучение с подкреплением находится между обучением с учителем и обучением без учителя. Формально и технически это не обучение с учителем, поскольку оно опирается не только на набор размеченных обучающих данных, но и не обучение без учителя, потому что мы ждём, что наш агент получит максимальное вознаграждение. Чтобы повлиять на своё главное решение, агент должен выбирать «правильные» действия и поведение в разнообразных сценариях.
Что такое машинное обучение с подкреплением?
Обучение с подкреплением — это тип машинного обучения, при котором машины учатся оптимальному поведению или подходящему действию в конкретной среде, чтобы максимизировать вознаграждение. При таком поведении машина учится, взаимодействуя со средой и наблюдая, как реагировать.
Обучение с подкреплением отличается от обучения с учителем тем, что обучение с учителем содержит лист с ответами, позволяя обучать модель с правильным ответом, тогда как обучение с подкреплением ответа не содержит и вместо этого полагается на агента подкрепления, который решает, что делать для выполнения задачи. Оно вынуждено учиться на собственном опыте при отсутствии обучающего набора данных.
Как работает обучение с подкреплением?
Агент исследует незнакомую среду, чтобы достичь цели в задаче обучения с подкреплением. Обучение с подкреплением основано на идее, что любую цель можно представить как максимизацию ожидаемого суммарного вознаграждения. Чтобы максимизировать вознаграждение, агент должен научиться воспринимать состояние среды и влиять на него своими действиями.
Чтобы понять принцип работы RL, необходимо рассмотреть два основных фактора:
Среда: это может быть комната, лабиринт, футбольное поле или что-то совсем другое.
Агент: интеллектуальный агент, например ИИ-робот, называется агентом.
Возьмём, например, среду-лабиринт, которую должен пройти агент. Рассмотрим следующую иллюстрацию:
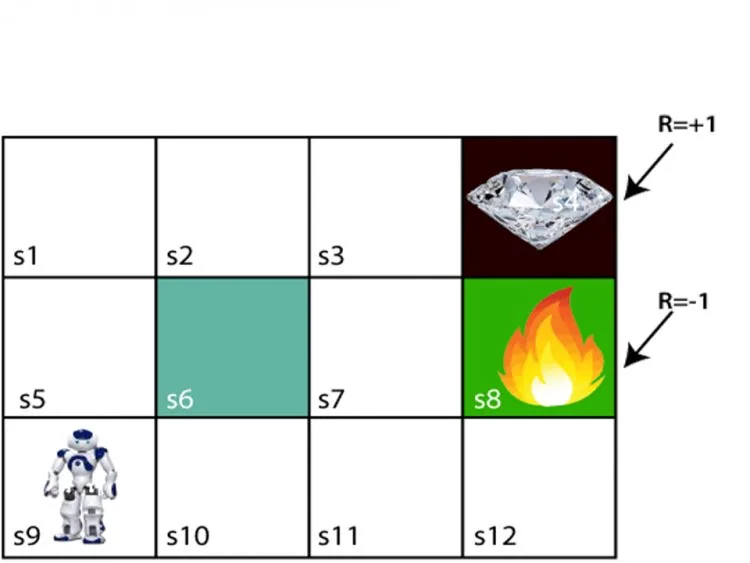
На изображении выше агент находится на первом блоке лабиринта. Лабиринт состоит из блока S6, который является стеной, блока S8, который является огненной ямой, и блока S4, который является алмазным блоком.
Агент не может пройти через блок S6, так как это сплошная стена. Если агент достигнет блока S4, он получит вознаграждение +1, а если попадёт в огненную яму — вознаграждение -1. Он может двигаться в четырёх направлениях: вверх, вниз, влево и вправо.
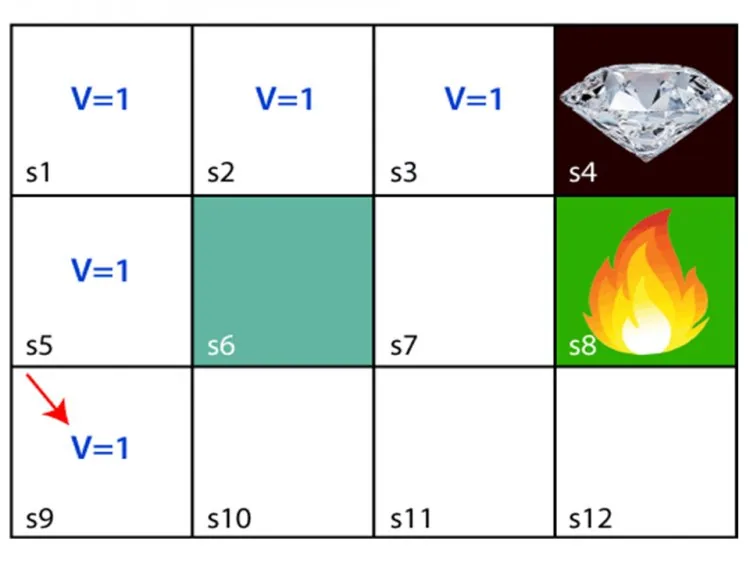
Агент может выбрать любой путь к конечной точке, но должен сделать это за как можно меньшее число шагов. Если агент пройдёт путь S9-S5-S1-S2-S3, он получит +1 очко вознаграждения.
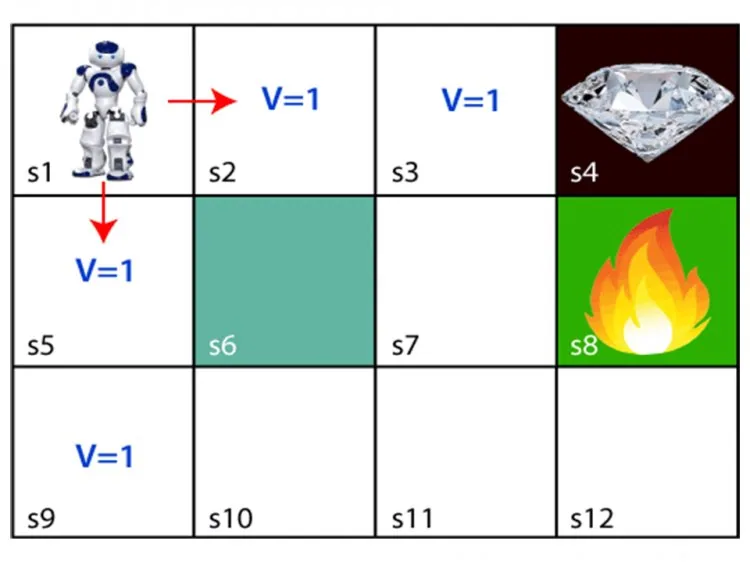
Агент постарается запомнить этапы, которые привели к текущей точке. Он присваивает значение 1 каждому предыдущему шагу, чтобы запомнить их.[1]
Какие бывают типы обучения с подкреплением?
Существует только два типа обучения с подкреплением:
- Положительное:
Когда событие происходит в результате определённого поведения, подкрепление повышает силу и частоту этого поведения. Иными словами, оно оказывает благотворное влияние на поведение.
- Отрицательное:
Подкрепление — это когда поведение усиливается в результате того, что негативной ситуации удалось избежать или она прекратилась.
Каковы примеры обучения с подкреплением?
Робототехника:
Роботы с заранее запрограммированным поведением эффективны в организованных средах с повторяющимися задачами, например на сборочной линии автомобильного завода. Заранее запрограммировать точное поведение в реальном мире, где реакция среды на действия робота неизвестна, почти невозможно. В таких случаях RL предлагает быстрый и простой способ создания роботов общего назначения. Он успешно применяется в планировании маршрута робота, где робот должен найти короткий, плавный и проходимый путь между двумя точками, свободный от столкновений и согласующийся с динамикой робота.
Автономное вождение:
В изменяющейся среде система автономного вождения должна решать множество задач восприятия и планирования. Планирование маршрута автомобиля и прогнозирование движения — два примера задач, где можно применять RL. Для принятия решений в различных временных и географических масштабах планирование пути автомобиля требует ряда правил низкого и высокого уровня. Задача прогнозирования движения людей и других транспортных средств, чтобы понять, как может развиваться ситуация в зависимости от текущего состояния среды, называется прогнозированием движения.
Каковы преимущества обучения с подкреплением?
- Обучение с подкреплением можно использовать для решения чрезвычайно сложных задач, которые невозможно решить традиционными методами.
- Этот подход предпочтителен для достижения трудно достижимых долгосрочных результатов.
- Эта парадигма обучения очень похожа на обучение человека. Поэтому она на пороге достижения совершенства.
- Модель способна исправлять ошибки, допущенные на этапе обучения.
- Как только модель исправила ошибку, вероятность повторения другой ошибки очень мала.
- Оно способно создать идеальную модель для решения конкретной задачи.
- Чтобы научиться ходить, роботы могут использовать алгоритмы обучения с подкреплением.
- Цель обучения с подкреплением — максимизировать производительность модели, достигая её оптимального поведения в определённой ситуации.
- Оно может быть ценным, когда единственный способ получить знания о среде — взаимодействовать с ней.[2]
Каковы недостатки обучения с подкреплением?
- Обучение с подкреплением как концепция во многом несовершенно, но именно этот недостаток и делает его действенным.
- Слишком много обучения с подкреплением может привести к избытку состояний, снижая полезность и эффективность.
- Для элементарных задач это не лучший вариант.
- Обучение с подкреплением требует большого объёма данных и вычислений. У него ненасытный аппетит к данным. Поэтому оно так хорошо работает в видеоиграх: в игру можно играть снова и снова, и получение больших объёмов данных кажется достижимым.
- Вместо того чтобы полностью отказываться от обучения с подкреплением, мы можем сочетать его с другими подходами для решения многих задач. Обучение с подкреплением и глубокое обучение — распространённое сочетание.
Вывод:
Обучение с подкреплением решает проблему обучения методам управления для автономных агентов при малом объёме данных или их отсутствии. Поскольку сбор и разметка обширной коллекции образцов стоят дороже самих данных, алгоритмы RL полезны в машинном обучении. Решения принимаются посредством обучения с подкреплением. Оно позволяет интеллектуальной системе пробовать новые действия или подходы, менять курс при неудачах и развивать успехи, создавая симуляцию целой компании или системы.
- Reinforcement Learning Tutorial. Доступно по адресу: https://www.javatpoint.com/reinforcement-learning.
- Pros and Cons of Reinforcement Learning. Доступно по адресу: https://pythonistaplanet.com/pros-and-cons-of-reinforcement-learning/.
Цикл обучения с подкреплением
- Агент наблюдает текущее состояние своей среды.
- Он выполняет действие.
- Среда возвращает вознаграждение (положительное или отрицательное) и новое состояние.
- Агент обновляет свою политику, чтобы со временем получать больше вознаграждения.
Примеры из реальной жизни
- Игры: системы, которые научились играть в го и видеоигры, играя сами с собой.
- Робототехника: роботы учатся ходить или захватывать предметы.
- Рекомендации и реклама: выбор того, что показывать, чтобы максимизировать долгосрочную вовлечённость.
- Управление ресурсами: охлаждение центров обработки данных и управление светофорами.
- Языковые модели: дообучение с использованием обратной связи от людей для получения более полезных ответов.
Обучение с подкреплением, с учителем и без учителя
Обучение с учителем учится на размеченных примерах (обучение с учителем); обучение без учителя находит структуру в неразмеченных данных (обучение без учителя); обучение с подкреплением учится методом проб и ошибок на основе вознаграждений. Обзор — в статье что такое машинное обучение.
Быстрые ответы
Что такое функция вознаграждения?
Правило, оценивающее, насколько хорошо действие или результат. Грамотная разработка такого правила — одна из самых сложных частей обучения с подкреплением.


