
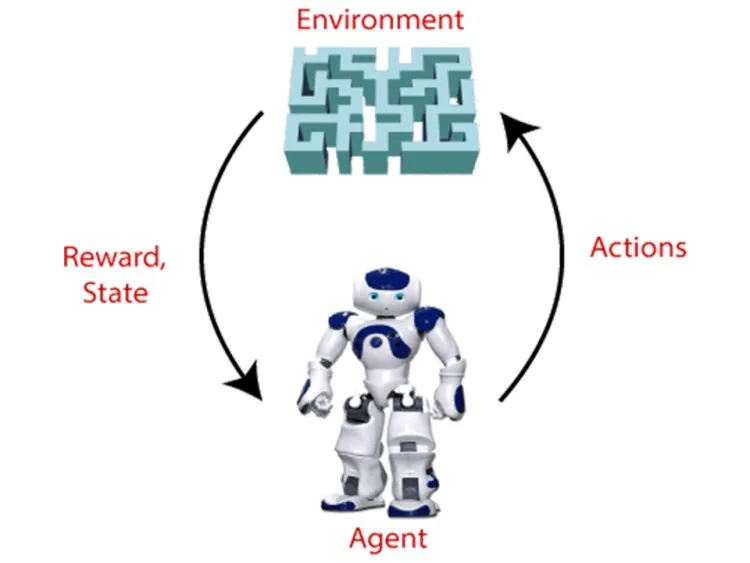
مقدمة:
يقع التعلم التعزيزي بين التعلم الخاضع للإشراف وغير الخاضع للإشراف. فهو رسمياً وتقنياً ليس تعلماً خاضعاً للإشراف لأنه لا يعتمد فقط على مجموعة من بيانات التدريب المصنفة، لكنه أيضاً ليس تعلماً غير خاضع للإشراف لأننا نسعى إلى أن يستفيد وكيلنا من المكافأة. ولتحقيق هدفه الرئيسي، يجب على الوكيل اختيار الأداءات والسلوكيات "الصحيحة" لتنفيذها في سيناريوهات عديدة.
ما هو تعلم الآلة التعزيزي؟
التعلم التعزيزي هو نوع من تعلم الآلة تتعلم فيه الآلات السلوك الأمثل أو الإجراء المناسب في بيئة محددة لتعظيم مكافأتها. وفي هذا السلوك، تتعلم الآلة من التفاعل مع البيئة ومراقبة كيفية الاستجابة.
يختلف التعلم التعزيزي عن التعلم الخاضع للإشراف في أن الأخير يتضمن ورقة الإجابات، مما يتيح تدريب النموذج بالإجابة الصحيحة، بينما لا يحتوي التعلم التعزيزي على إجابة ويعتمد بدلاً من ذلك على وكيل التعزيز ليقرر ما يفعله لإنجاز المهمة. فهو مُلزم بالتكيف من معرفته في غياب مجموعة بيانات تدريب.
كيف يعمل التعلم التعزيزي؟
يستكشف الوكيل بيئة غير مألوفة لتحقيق هدف في مسألة التعلم التعزيزي. ويقوم التعلم التعزيزي على فكرة أن تعظيم المكافأة التراكمية المتوقعة يمكن استخدامه لتمثيل أي هدف. ولتعظيم المكافأة، يجب على الوكيل أن يتعلم إدراك حالة البيئة والتأثير فيها من خلال أفعاله.
لفهم عمل RL، يجب أن ندرس عاملين رئيسيين:
البيئة: قد تكون غرفة أو متاهة أو ملعب كرة قدم أو أي شيء آخر.
الوكيل: يُشار إلى الوكيل الذكي، مثل روبوت الذكاء الاصطناعي، بالوكيل.
لنأخذ مثلاً بيئة متاهة يجب على الوكيل عبورها. تأمل التوضيح التالي:
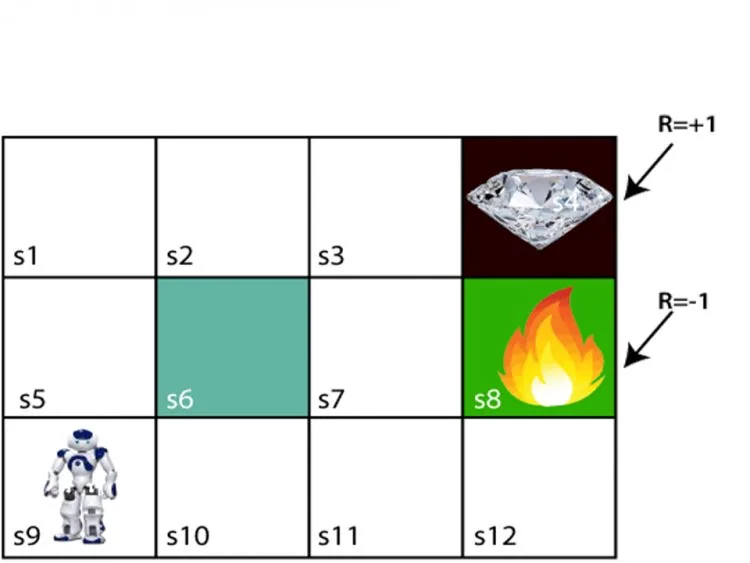
الوكيل في الصورة أعلاه على الكتلة الأولى في المتاهة. وتتكون المتاهة من الكتلة S6 وهي جدار، والكتلة S8 وهي حفرة نار، والكتلة S4 وهي كتلة ألماس.
لا يستطيع الوكيل المرور عبر الكتلة S6 لأنها جدار صلب. وإذا وصل الوكيل إلى الكتلة S4 فسيحصل على مكافأة +1، بينما إذا وصل إلى حفرة النار فسيحصل على -1. ويستطيع التحرك في أربعة اتجاهات: أعلى وأسفل ويسار ويمين.
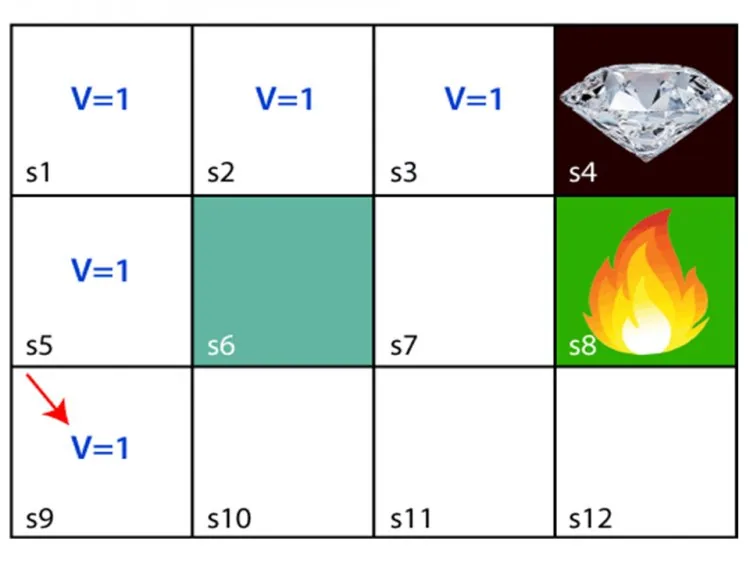
يستطيع الوكيل اختيار أي مسار للوصول إلى نقطة النهاية، لكن عليه فعل ذلك بأقل عدد ممكن من الخطوات. وإذا سلك الوكيل المسار S9-S5-S1-S2-S3 فسيحصل على نقطة المكافأة +1.
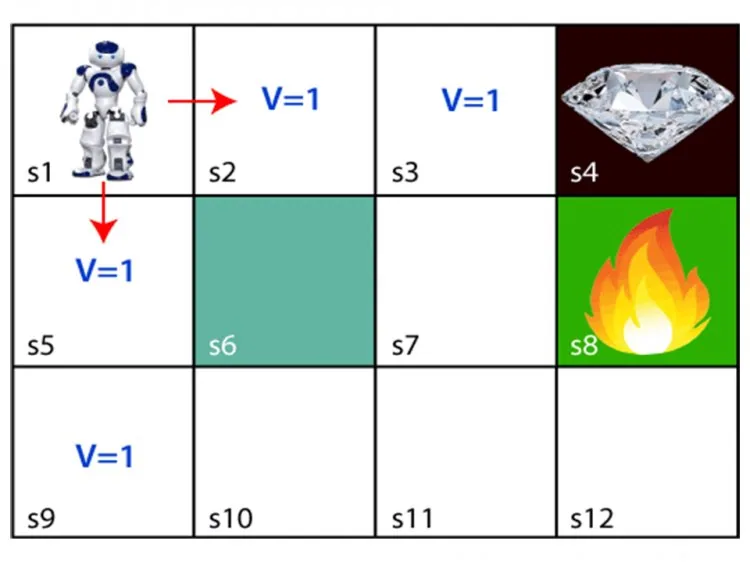
سيبذل الوكيل جهداً لتذكّر الفترات التي أدت إلى هذه النقطة. فهو يمنح قيمة 1 لكل خطوة سابقة لحفظها.[1]
ما أنواع التعلم التعزيزي؟
هناك نوعان فقط من التعلم التعزيزي كما يلي:
- إيجابي:
عندما يقع حدث نتيجة سلوك معين، يعزز التعزيز قوة السلوك وتكراره. وبعبارة أخرى، له تأثير مفيد على السلوك.
- سلبي:
التعزيز هو تقوية السلوك نتيجة تجنب ظرف سلبي أو إيقافه.
ما أمثلة التعلم التعزيزي؟
الروبوتات:
تكون الروبوتات ذات السلوك المبرمج مسبقاً فعالة في البيئات المنظمة ذات المهام المتكررة، مثل خط التجميع في مصنع سيارات. أما برمجة سلوكيات دقيقة مسبقاً في العالم الحقيقي، حيث تكون استجابة البيئة لنشاط الروبوت غير معروفة، فهي شبه مستحيلة. وفي مثل هذه الحالات، يوفر RL تقنية سريعة وسهلة لإنشاء روبوتات متعددة الأغراض. وقد استُخدم بفعالية في تخطيط مسار الروبوت، حيث يجب على الروبوت إيجاد مسار قصير وسلس وسالك بين نقطتين خالٍ من التصادمات ومتسق مع ديناميكيات الروبوت.
القيادة الذاتية:
في بيئة متغيرة، يجب على نظام القيادة الذاتية إنجاز العديد من مهام الإدراك والتخطيط. ويُعد تخطيط مسار المركبة والتنبؤ بالحركة مثالين على الأنشطة التي يمكن استخدام RL فيها. ولاتخاذ قرارات على نطاقات زمنية وجغرافية متنوعة، يتطلب تخطيط مسار المركبة عدداً من القواعد منخفضة المستوى وعالية المستوى. أما التنبؤ بالحركة فهو التحدي المتمثل في توقع حركة الأشخاص والمركبات الأخرى لفهم كيف قد يتطور الموقف بحسب الحالة الراهنة للبيئة.
ما مزايا التعلم التعزيزي؟
- يمكن استخدام التعلم التعزيزي لمعالجة المشكلات شديدة التعقيد التي يستحيل حلها بالطرق التقليدية.
- يُفضَّل هذا النهج لتحقيق نتائج طويلة المدى يصعب تحقيقها.
- يشبه نموذج التعلم هذا التعلم البشري إلى حد كبير. ولذلك فهو على وشك بلوغ الكمال.
- يستطيع النموذج تصحيح الأخطاء التي ارتُكبت خلال مرحلة التدريب.
- بمجرد أن يصحح النموذج خطأً، يصبح احتمال حدوث خطأ آخر منخفضاً جداً.
- لديه القدرة على تصميم النموذج المثالي لمعالجة مشكلة محددة.
- لتعلم المشي، يمكن للروبوتات استخدام خوارزميات التعلم التعزيزي.
- يهدف التعلم التعزيزي إلى تعظيم أداء النموذج عبر تحقيق سلوكه الأمثل ضمن موقف معين.
- عندما تكون الطريقة الوحيدة لجمع المعرفة عن البيئة هي التفاعل معها، فقد يكون مفيداً.[2]
ما عيوب التعلم التعزيزي؟
- التعلم التعزيزي كإطار عمل خاطئ في جوانب كثيرة، لكن هذا الخطأ بالذات هو ما يجعله فعالاً.
- الإفراط في التعلم التعزيزي قد يؤدي إلى فرط في الحالات، مما يقلل الفائدة والفعالية.
- وهو ليس الخيار الأفضل للمهام الأولية.
- يتطلب التعلم التعزيزي كمية كبيرة من البيانات والحوسبة. فله شهية لا تشبع للإحصاءات. ولهذا يعمل بشكل جيد جداً في ألعاب الفيديو، إذ يمكن إعادة لعب اللعبة، ويصبح الحصول على كميات هائلة من البيانات في المتناول.
- بدلاً من التخلي عن التعلم التعزيزي كلياً، يمكننا استخدام مزيج من التعلم التعزيزي وأساليب إضافية لمعالجة مشكلات كثيرة. والتعلم التعزيزي والتعلم العميق مزيج شائع.
الخلاصة:
يعالج التعلم التعزيزي صعوبة تعلم أساليب التحكم للوكلاء المستقلين بقليل من البيانات أو دونها. ولأن جمع مجموعة واسعة من الأنماط النموذجية وتصنيفها يكلف أكثر من البيانات نفسها، فإن خوارزميات RL مفيدة في تعلم الآلة. وتُتخذ القرارات من خلال التعلم التعزيزي. فهو يجعل من الممكن لنظام ذكي تجربة مهام أو أساليب جديدة، وتغيير المسار عند حدوث إخفاقات، والبناء على النجاحات عبر تطوير محاكاة لشركة أو نظام كامل.
- Reinforcement Learning Tutorial. متاح على: https://www.javatpoint.com/reinforcement-learning.
- Pros and Cons of Reinforcement Learning. متاح على: https://pythonistaplanet.com/pros-and-cons-of-reinforcement-learning/.
حلقة التعلم التعزيزي
- يلاحظ الوكيل الحالة الراهنة لبيئته.
- يتخذ إجراءً.
- تعيد البيئة مكافأة (إيجابية أو سلبية) وحالة جديدة.
- يحدّث الوكيل سياسته ليحصل على مكافأة أكبر مع الوقت.
أمثلة من العالم الواقعي
- الألعاب: أنظمة تعلمت لعب Go وألعاب الفيديو عبر اللعب ضد نفسها.
- الروبوتات: روبوتات تتعلم المشي أو الإمساك بالأشياء.
- التوصيات والإعلانات: اختيار ما يُعرض لتعظيم التفاعل على المدى الطويل.
- إدارة الموارد: تبريد مراكز البيانات والتحكم في إشارات المرور.
- النماذج اللغوية: الضبط الدقيق بملاحظات بشرية لإنتاج إجابات أكثر فائدة.
التعلم التعزيزي مقابل التعلم الخاضع للإشراف وغير الخاضع للإشراف
يتعلم التعلم الخاضع للإشراف من أمثلة مصنفة (التعلم الخاضع للإشراف)؛ ويكتشف التعلم غير الخاضع للإشراف البنية في بيانات غير مصنفة (التعلم غير الخاضع للإشراف)؛ أما التعلم التعزيزي فيتعلم بالتجربة والخطأ من المكافآت. راجع النظرة العامة في ما هو تعلم الآلة.
إجابات سريعة
ما هي دالة المكافأة؟
قاعدة تقيّم مدى جودة إجراء أو نتيجة. ويُعد تصميمها جيداً من أصعب أجزاء التعلم التعزيزي.


