
ভূমিকা:
রিইনফোর্সমেন্ট লার্নিং সুপারভাইজড এবং আনসুপারভাইজড লার্নিংয়ের মাঝামাঝি অবস্থান করে। আনুষ্ঠানিক ও প্রযুক্তিগতভাবে এটি সুপারভাইজড লার্নিং নয়, কারণ এটি কেবল লেবেলযুক্ত প্রশিক্ষণ বা অনুশীলন ডেটার সেটের ওপর নির্ভর করে না, আবার এটি আনসুপারভাইজড লার্নিংও নয়, কারণ আমরা চাই আমাদের এজেন্ট একটি পুরস্কার কাজে লাগাক। তার মূল সংকল্পকে প্রভাবিত করতে এজেন্টকে বিভিন্ন পরিস্থিতিতে "সঠিক" কাজ ও আচরণ বেছে নিতে হয়।
রিইনফোর্সমেন্ট মেশিন লার্নিং কী?
রিইনফোর্সমেন্ট লার্নিং হলো এমন ধরনের মেশিন লার্নিং, যেখানে যন্ত্র তার পুরস্কার সর্বাধিক করতে একটি নির্দিষ্ট পরিবেশে সর্বোত্তম আচরণ বা উপযুক্ত কাজ শেখে। এই আচরণে যন্ত্র পরিবেশের সঙ্গে মিথস্ক্রিয়া এবং পর্যবেক্ষণ থেকে শেখে কীভাবে সাড়া দিতে হয়।
রিইনফোর্সমেন্ট লার্নিং সুপারভাইজড লার্নিং থেকে আলাদা, কারণ সুপারভাইজড লার্নিংয়ে উত্তরপত্র থাকে, ফলে মডেলকে সঠিক উত্তর দিয়ে প্রশিক্ষণ দেওয়া যায়, অথচ রিইনফোর্সমেন্ট লার্নিংয়ে কোনো উত্তর নেই এবং এর বদলে কাজ সম্পন্ন করতে কী করতে হবে তা সিদ্ধান্ত নিতে রিইনফোর্সমেন্ট এজেন্টের ওপর নির্ভর করে। প্রশিক্ষণ ডেটাসেটের অনুপস্থিতিতে এটিকে নিজের জ্ঞান থেকেই মানিয়ে নিতে হয়।
রিইনফোর্সমেন্ট লার্নিং কীভাবে কাজ করে?
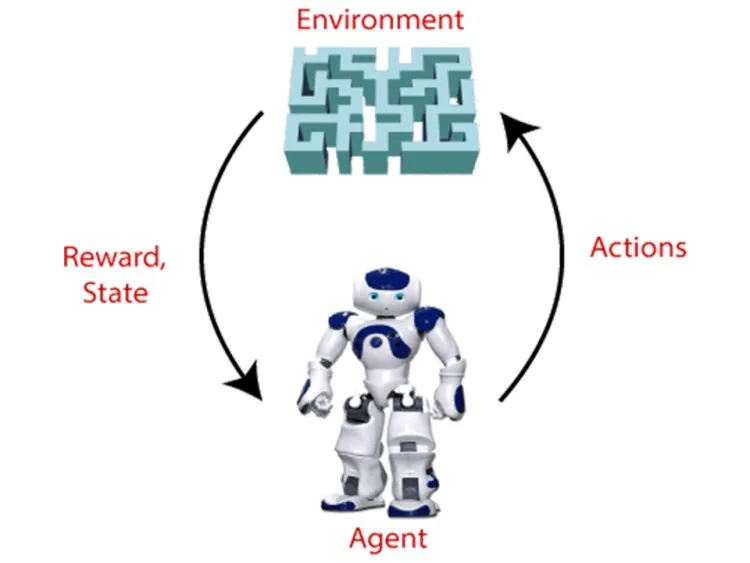
রিইনফোর্সমেন্ট লার্নিং সমস্যায় একটি লক্ষ্য অর্জনের জন্য একজন এজেন্ট অপরিচিত পরিবেশ অন্বেষণ করে। রিইনফোর্সমেন্ট লার্নিং এই ধারণার ওপর ভিত্তি করে তৈরি যে প্রত্যাশিত সম্মিলিত পুরস্কারের সর্বাধিকীকরণ দিয়ে যেকোনো উদ্দেশ্য উপস্থাপন করা যায়। পুরস্কার সর্বাধিক করতে এজেন্টকে তার কাজের মাধ্যমে পরিবেশের অবস্থা উপলব্ধি করতে ও তাতে প্রভাব ফেলতে শিখতে হয়।
RL-এর কার্যপ্রণালী বুঝতে আমাদের দুটি প্রধান বিষয় পরীক্ষা করতে হবে:
পরিবেশ: এটি একটি ঘর, একটি গোলকধাঁধা, একটি ফুটবল মাঠ বা সম্পূর্ণ অন্য কিছু হতে পারে।
এজেন্ট: AI রোবটের মতো একটি বুদ্ধিমান এজেন্টকে এজেন্ট বলা হয়।
উদাহরণস্বরূপ, একটি গোলকধাঁধা পরিবেশ ধরুন যা এজেন্টকে পার হতে হবে। নিচের চিত্রটি বিবেচনা করুন:
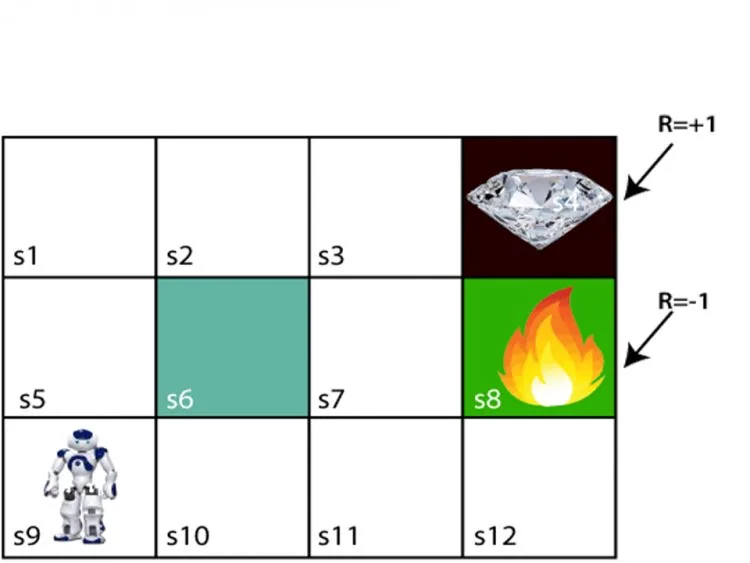
উপরের ছবিতে এজেন্ট গোলকধাঁধার প্রথম ব্লকে আছে। গোলকধাঁধাটি গঠিত S6 ব্লক দিয়ে, যা একটি দেয়াল; S8 ব্লক, যা একটি আগুনের গর্ত; এবং S4 ব্লক, যা একটি হীরার ব্লক।
এজেন্ট S6 ব্লক পার হতে পারে না, কারণ এটি একটি শক্ত দেয়াল। এজেন্ট S4 ব্লকে পৌঁছালে সে +1 পুরস্কার পাবে, আর আগুনের গর্তে পৌঁছালে -1 পুরস্কার পাবে। সে চার দিকে, অর্থাৎ ওপরে, নিচে, বামে ও ডানে যেতে পারে।
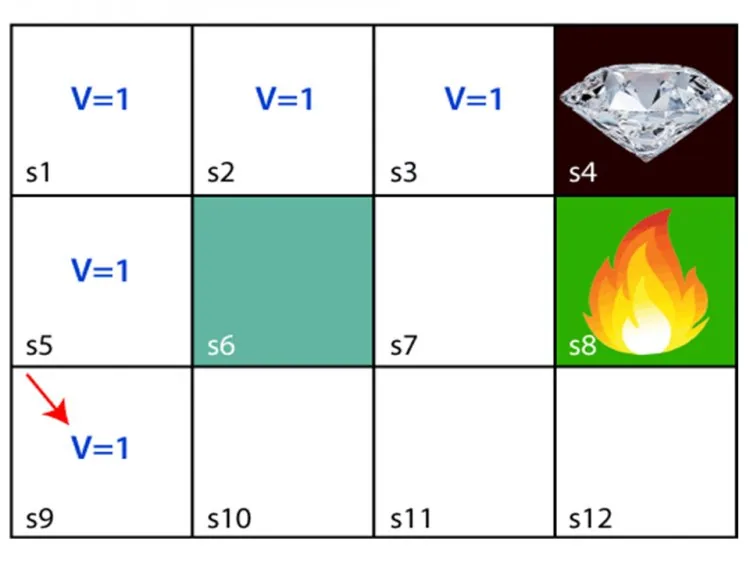
এজেন্ট শেষ বিন্দুতে পৌঁছাতে যেকোনো পথ বেছে নিতে পারে, তবে যতটা সম্ভব কম ধাপে তা করতে হবে। এজেন্ট S9-S5-S1-S2-S3 পথটি অনুসরণ করলে সে +1 পুরস্কার পয়েন্ট পাবে।
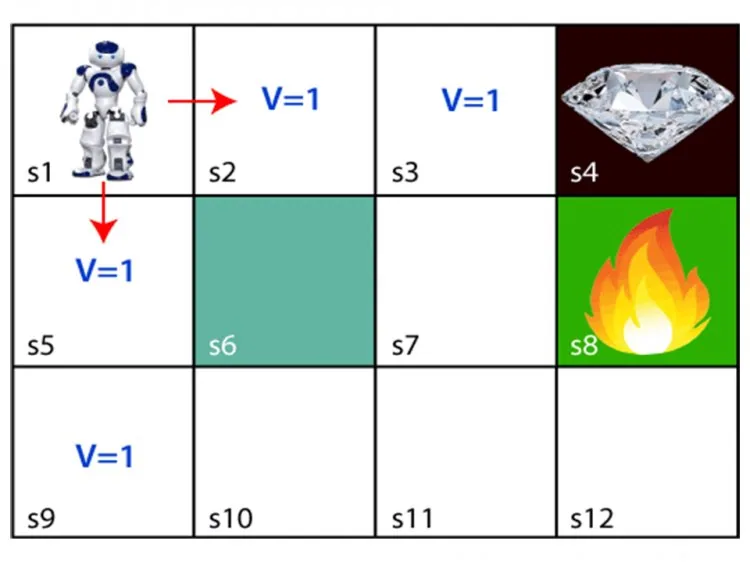
এজেন্ট এই পর্যন্ত পৌঁছানোর পথের ধাপগুলো মনে রাখার চেষ্টা করবে। এগুলো মনে রাখতে সে প্রতিটি পূর্ববর্তী ধাপে ১ মান বরাদ্দ করে।[1]
রিইনফোর্সমেন্ট লার্নিংয়ের ধরনগুলো কী কী?
রিইনফোর্সমেন্ট লার্নিং কেবল দুই ধরনের, যা নিম্নরূপ:
- ইতিবাচক:
কোনো নির্দিষ্ট আচরণের ফলে একটি ঘটনা ঘটলে রিইনফোর্সমেন্ট সেই আচরণের শক্তি ও ঘনঘনতা বাড়ায়। অন্য কথায়, এটি আচরণের ওপর ইতিবাচক প্রভাব ফেলে।
- নেতিবাচক:
রিইনফোর্সমেন্ট হলো যখন কোনো নেতিবাচক পরিস্থিতি এড়ানো বা থামানোর ফলে একটি আচরণ শক্তিশালী হয়।
রিইনফোর্সমেন্ট লার্নিংয়ের উদাহরণ কী কী?
রোবোটিক্স:
পূর্ব-প্রোগ্রাম করা আচরণের রোবট সংগঠিত পরিবেশে এবং পুনরাবৃত্ত কাজে কার্যকর, যেমন গাড়ি তৈরির কারখানার অ্যাসেম্বলি লাইন। বাস্তব জগতে সুনির্দিষ্ট আচরণ আগে থেকে প্রোগ্রাম করা প্রায় অসম্ভব, যেখানে রোবটের কাজের প্রতি পরিবেশের সাড়া অজানা। এমন ক্ষেত্রে RL সাধারণ উদ্দেশ্যের রোবট তৈরির একটি দ্রুত ও সহজ কৌশল দেয়। এটি রোবটের পথ পরিকল্পনায় কার্যকরভাবে ব্যবহৃত হয়েছে, যেখানে রোবটকে দুই বিন্দুর মধ্যে একটি ছোট, মসৃণ ও চলাচলযোগ্য পথ খুঁজে বের করতে হয়, যা সংঘর্ষমুক্ত এবং রোবটের গতিবিদ্যার সঙ্গে সামঞ্জস্যপূর্ণ।
স্বয়ংচালিত ড্রাইভিং:
পরিবর্তনশীল পরিবেশে একটি স্বয়ংচালিত ড্রাইভিং সিস্টেমকে অনেক উপলব্ধি ও প্রস্তুতিমূলক কাজ সম্পন্ন করতে হয়। যানবাহনের পথ প্রস্তুতি এবং গতি পূর্বাভাস হলো এমন দুটি কাজ যেখানে RL ব্যবহার করা যেতে পারে। বিভিন্ন সময় ও ভৌগোলিক পরিসরে সিদ্ধান্ত নিতে যানবাহনের পথ পরিকল্পনায় নিম্ন ও উচ্চ স্তরের বেশ কিছু নিয়মের প্রয়োজন হয়। পরিবেশের বিদ্যমান অবস্থার ওপর নির্ভর করে পরিস্থিতি কীভাবে বিকশিত হতে পারে তা বোঝার জন্য মানুষ ও অন্যান্য যানবাহনের গতিবিধির পূর্বাভাস দেওয়ার চ্যালেঞ্জকে গতি পূর্বাভাস বলা হয়।
রিইনফোর্সমেন্ট লার্নিংয়ের সুবিধাগুলো কী কী?
- রিইনফোর্সমেন্ট লার্নিং এমন অত্যন্ত জটিল সমস্যা সামলাতে ব্যবহার করা যেতে পারে, যা প্রচলিত পদ্ধতিতে সমাধান করা অসম্ভব।
- কঠিনভাবে অর্জনযোগ্য দীর্ঘমেয়াদি ফলাফল অর্জনে এই পদ্ধতিটি বেশি পছন্দ করা হয়।
- এই শেখার কাঠামো মানুষের শেখার সঙ্গে অত্যন্ত তুলনীয়। ফলে এটি পূর্ণতা অর্জনের দ্বারপ্রান্তে।
- প্রশিক্ষণ পর্যায়ে ঘটা ভুলগুলো সংশোধন করার সক্ষমতা মডেলের আছে।
- একবার কোনো মডেল ভুল সংশোধন করলে আরেকটি ভুল হওয়ার সম্ভাবনা অত্যন্ত কম।
- একটি নির্দিষ্ট সমস্যা মোকাবিলায় আদর্শ মডেল তৈরি করার সক্ষমতা এর আছে।
- হাঁটতে শিখতে রোবটরা রিইনফোর্সমেন্ট লার্নিং অ্যালগরিদম ব্যবহার করতে পারে।
- রিইনফোর্সমেন্ট লার্নিংয়ের লক্ষ্য একটি নির্দিষ্ট পরিস্থিতিতে মডেলের সর্বোত্তম আচরণ অর্জনের মাধ্যমে তার কর্মক্ষমতা সর্বাধিক করা।
- পরিবেশ সম্পর্কে জ্ঞান অর্জনের একমাত্র উপায় যখন তার সঙ্গে মিথস্ক্রিয়া করা, তখন এটি মূল্যবান হতে পারে।[2]
রিইনফোর্সমেন্ট লার্নিংয়ের অসুবিধাগুলো কী কী?
- একটি কাঠামো হিসেবে রিইনফোর্সমেন্ট লার্নিং বহু দিক থেকে ত্রুটিপূর্ণ, তবু ঠিক এই ত্রুটিই একে কার্যকর করে তোলে।
- অতিরিক্ত রিইনফোর্সমেন্ট লার্নিং অবস্থার আধিক্য ঘটাতে পারে, যা উপযোগিতা ও কার্যকারিতা কমিয়ে দেয়।
- প্রাথমিক কাজের জন্য এটি সেরা বিকল্প নয়।
- রিইনফোর্সমেন্ট লার্নিংয়ের জন্য প্রচুর পরিমাণ ডেটা ও কম্পিউটেশন প্রয়োজন। পরিসংখ্যানের জন্য এর ক্ষুধা অতৃপ্ত। সে কারণেই এটি ভিডিও গেমে এত ভালো কাজ করে, কারণ গেম বারবার খেলা যায়, ফলে বিপুল পরিমাণ ডেটা পাওয়া সম্ভব বলে মনে হয়।
- রিইনফোর্সমেন্ট লার্নিং পুরোপুরি ত্যাগ করার বদলে আমরা বহু সমস্যা মোকাবিলায় রিইনফোর্সমেন্ট লার্নিং ও অতিরিক্ত পদ্ধতির মিশ্রণ ব্যবহার করতে পারি। রিইনফোর্সমেন্ট লার্নিং ও ডিপ লার্নিং একটি প্রচলিত সমন্বয়।
উপসংহার:
রিইনফোর্সমেন্ট লার্নিং স্বয়ংক্রিয় এজেন্টদের জন্য সামান্য বা কোনো ডেটা ছাড়াই নিয়ন্ত্রণ পদ্ধতি শেখার চ্যালেঞ্জ মোকাবিলা করে। নমুনা প্যাটার্নের বিশাল সংগ্রহ জোগাড় ও লেবেল করার খরচ ডেটার চেয়েও বেশি হওয়ায় মেশিন লার্নিংয়ে RL অ্যালগরিদম কার্যকর। রিইনফোর্সমেন্ট লার্নিংয়ের মাধ্যমে সিদ্ধান্ত নেওয়া হয়। এটি একটি বুদ্ধিমান সিস্টেমের পক্ষে নতুন উদ্যোগ বা পদ্ধতি চেষ্টা করা, ব্যর্থতা এলে গতিপথ বদলানো এবং একটি সম্পূর্ণ প্রতিষ্ঠান বা সিস্টেমের সিমুলেশন তৈরি করে সাফল্যের ওপর ভিত্তি করে এগোনো সম্ভব করে তোলে।
- Reinforcement Learning Tutorial. এখানে পাওয়া যাবে: https://www.javatpoint.com/reinforcement-learning.
- Pros and Cons of Reinforcement Learning. এখানে পাওয়া যাবে: https://pythonistaplanet.com/pros-and-cons-of-reinforcement-learning/.
রিইনফোর্সমেন্ট লার্নিং চক্র
- একটি এজেন্ট তার পরিবেশের বর্তমান অবস্থা পর্যবেক্ষণ করে।
- এটি একটি কাজ করে।
- পরিবেশ একটি পুরস্কার (ইতিবাচক বা নেতিবাচক) এবং একটি নতুন অবস্থা ফেরত দেয়।
- এজেন্ট সময়ের সঙ্গে আরও বেশি পুরস্কার পেতে তার নীতি হালনাগাদ করে।
বাস্তব উদাহরণ
- গেম: যেসব সিস্টেম নিজেদের বিরুদ্ধে খেলে Go এবং ভিডিও গেম খেলা শিখেছে।
- রোবটিক্স: রোবট হাঁটতে বা বস্তু ধরতে শিখছে।
- সুপারিশ ও বিজ্ঞাপন: দীর্ঘমেয়াদি সম্পৃক্ততা সর্বাধিক করতে কী দেখানো হবে তা বেছে নেওয়া।
- সম্পদ ব্যবস্থাপনা: ডেটা সেন্টারের কুলিং এবং ট্রাফিক সিগন্যাল নিয়ন্ত্রণ।
- ভাষা মডেল: আরও সহায়ক উত্তর তৈরি করতে মানুষের প্রতিক্রিয়া দিয়ে ফাইন-টিউনিং।
রিইনফোর্সমেন্ট বনাম সুপারভাইজড বনাম আনসুপারভাইজড লার্নিং
সুপারভাইজড লার্নিং লেবেলযুক্ত উদাহরণ থেকে শেখে (সুপারভাইজড লার্নিং); আনসুপারভাইজড লার্নিং লেবেলবিহীন ডেটায় কাঠামো খুঁজে পায় (আনসুপারভাইজড লার্নিং); রিইনফোর্সমেন্ট লার্নিং পুরস্কার থেকে চেষ্টা ও ভুলের মাধ্যমে শেখে। সংক্ষিপ্ত বিবরণ দেখুন মেশিন লার্নিং কী-তে।
দ্রুত উত্তর
পুরস্কার ফাংশন কী?
একটি নিয়ম যা কোনো কাজ বা ফলাফল কতটা ভালো তা স্কোর করে। এটি ভালোভাবে নকশা করা রিইনফোর্সমেন্ট লার্নিংয়ের সবচেয়ে কঠিন অংশগুলোর একটি।


