
Introduction :
L'apprentissage par renforcement se situe entre l'apprentissage supervisé et l'apprentissage non supervisé. Officiellement et techniquement, ce n'est pas de l'apprentissage supervisé car il ne dépend pas uniquement d'un ensemble de données d'entraînement étiquetées, mais ce n'est pas non plus de l'apprentissage non supervisé car nous attendons de notre agent qu'il maximise une récompense. Pour orienter sa décision principale, l'agent doit choisir les « bonnes » actions et comportements à adopter dans de nombreux scénarios.
Qu'est-ce que l'apprentissage automatique par renforcement ?
L'apprentissage par renforcement est le type d'apprentissage automatique dans lequel les machines apprennent le comportement optimal ou l'action appropriée dans un environnement donné afin de maximiser leur récompense. Dans ce mode, la machine apprend en interagissant avec l'environnement et en observant comment réagir.
L'apprentissage par renforcement diffère de l'apprentissage supervisé : ce dernier comprend le corrigé, ce qui permet d'entraîner le modèle avec la bonne réponse, alors que l'apprentissage par renforcement ne comporte pas de réponse et s'appuie à la place sur l'agent de renforcement pour décider quoi faire afin d'accomplir la tâche. Il est obligé de s'adapter à partir de son expérience en l'absence de jeu de données d'entraînement.
Comment fonctionne l'apprentissage par renforcement ?
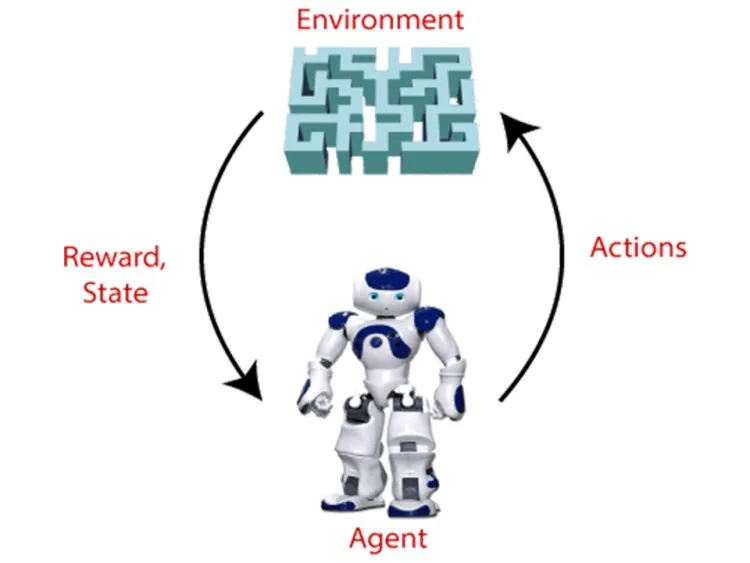
Dans le problème d'apprentissage par renforcement, un agent explore un environnement inconnu afin d'atteindre un objectif. L'apprentissage par renforcement repose sur l'idée que la maximisation de la récompense cumulée attendue peut servir à représenter n'importe quel objectif. Pour maximiser la récompense, l'agent doit apprendre à percevoir et à modifier l'état de l'environnement par ses actions.
Pour comprendre le fonctionnement du RL, nous devons examiner deux facteurs majeurs :
Environnement : il peut s'agir d'une pièce, d'un labyrinthe, d'un terrain de football ou de tout autre chose.
Agent : un agent intelligent, tel qu'un robot d'IA, est appelé un agent.
Prenons, par exemple, un environnement de labyrinthe que l'agent doit traverser. Considérez l'illustration suivante :
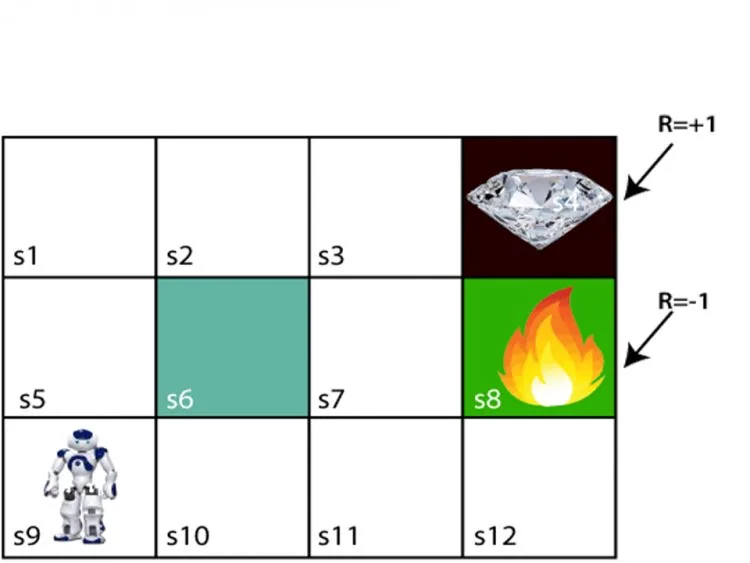
L'agent se trouve sur le premier bloc du labyrinthe de l'image ci-dessus. Le labyrinthe se compose d'un bloc S6, qui est un mur, d'un bloc S8, qui est une fosse de feu, et d'un bloc S4, qui est un bloc de diamant.
L'agent ne peut pas traverser le bloc S6 car c'est un mur infranchissable. Si l'agent atteint le bloc S4, il reçoit une récompense de +1, alors que s'il atteint la fosse de feu, il reçoit une récompense de -1. Il peut se déplacer dans quatre directions : haut, bas, gauche et droite.
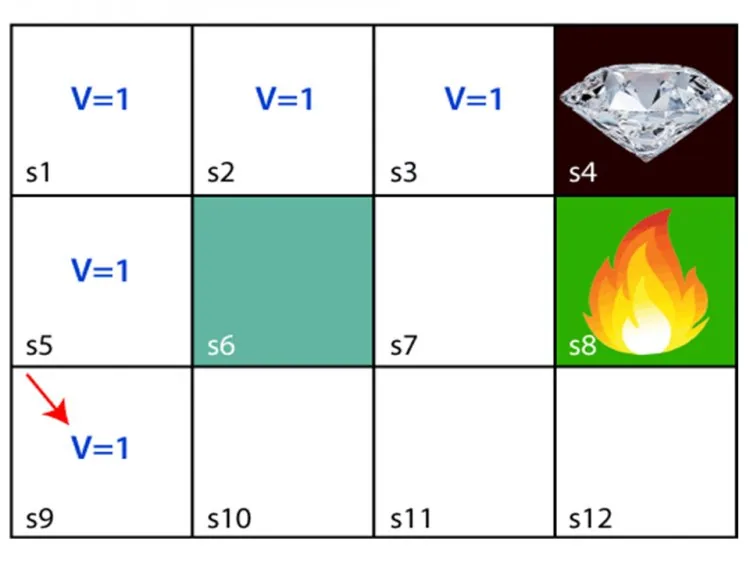
L'agent peut choisir n'importe quel chemin pour atteindre l'arrivée, mais il doit le faire en aussi peu d'étapes que possible. Si l'agent emprunte le chemin S9-S5-S1-S2-S3, il recevra le point de récompense +1.
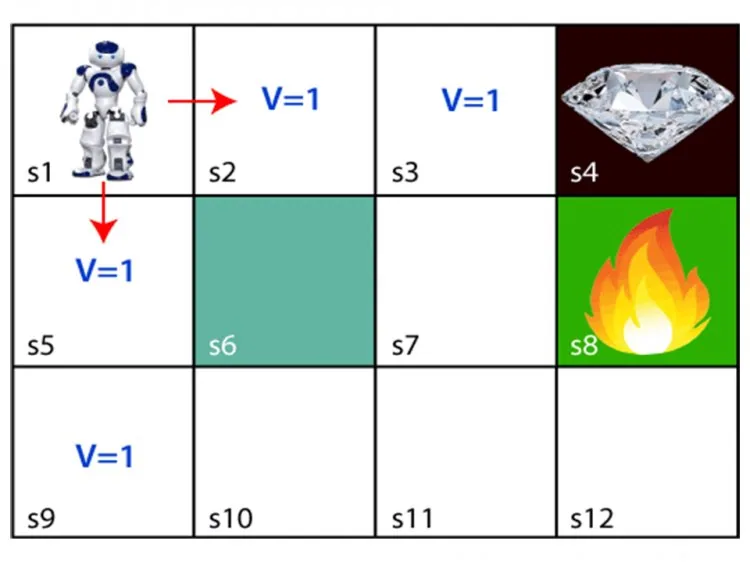
L'agent s'efforcera de se rappeler les étapes qui l'ont mené jusqu'ici. Il attribue la valeur 1 à chaque étape précédente afin de les mémoriser.[1]
Quels sont les types d'apprentissage par renforcement ?
Il n'existe que deux types d'apprentissage par renforcement :
- Positif:
Lorsqu'un événement se produit à la suite d'un comportement particulier, le renforcement augmente l'intensité et la fréquence de ce comportement. Autrement dit, il a une influence bénéfique sur la conduite.
- Négatif :
Le renforcement a lieu lorsqu'un comportement est consolidé du fait qu'une situation négative est évitée ou interrompue.
Quels sont des exemples d'apprentissage par renforcement ?
Robotique :
Les robots au comportement préprogrammé sont efficaces dans des environnements organisés avec des tâches répétitives, comme une chaîne de montage dans une usine automobile. Préprogrammer des comportements précis dans le monde réel, où la réaction de l'environnement à l'action du robot est inconnue, est presque impossible. Dans de tels cas, le RL offre une technique rapide et simple pour créer des robots polyvalents. Il a été utilisé efficacement dans la planification de trajectoire robotique, où un robot doit trouver un chemin court, fluide et praticable entre deux points, sans collision et cohérent avec la dynamique du robot.
Conduite autonome :
Dans un environnement changeant, un système de conduite autonome doit accomplir de nombreuses tâches de perception et de planification. La planification de trajectoire du véhicule et la prédiction de mouvement sont deux exemples d'activités où le RL peut être utilisé. Pour prendre des décisions à différentes échelles temporelles et géographiques, la planification de trajectoire d'un véhicule nécessite un certain nombre de règles de bas et de haut niveau. Le défi de prévoir le mouvement des personnes et des autres véhicules afin de comprendre comment la situation peut évoluer selon l'état actuel de l'environnement s'appelle la prédiction de mouvement.
Quels sont les avantages de l'apprentissage par renforcement ?
- L'apprentissage par renforcement peut servir à résoudre des problèmes extrêmement complexes impossibles à résoudre avec les méthodes traditionnelles.
- Cette approche est privilégiée pour atteindre des résultats à long terme difficiles à obtenir.
- Ce paradigme d'apprentissage est très proche de l'apprentissage humain. Il est par conséquent sur le point d'atteindre la perfection.
- Le modèle est capable de corriger les erreurs commises pendant la phase d'entraînement.
- Une fois qu'un modèle a corrigé une erreur, la probabilité qu'une autre erreur se produise est très faible.
- Il est capable de concevoir le modèle idéal pour résoudre un problème donné.
- Pour apprendre à marcher, les robots peuvent utiliser des algorithmes d'apprentissage par renforcement.
- L'apprentissage par renforcement vise à maximiser la performance d'un modèle en atteignant son comportement optimal dans une situation donnée.
- Lorsque la seule façon d'acquérir des connaissances sur l'environnement est d'interagir avec lui, il peut être précieux.[2]
Quels sont les inconvénients de l'apprentissage par renforcement ?
- L'apprentissage par renforcement en tant que cadre est erroné à bien des égards, et c'est pourtant précisément ce défaut qui le rend efficace.
- Trop d'apprentissage par renforcement peut entraîner une surabondance d'états, réduisant l'utilité et l'efficacité.
- Pour les tâches élémentaires, ce n'est pas la meilleure option.
- L'apprentissage par renforcement nécessite une grande quantité de données et de calcul. Il a un appétit insatiable de statistiques. C'est pourquoi il fonctionne si bien dans les jeux vidéo : comme la partie peut être rejouée, obtenir de grandes quantités de données semble envisageable.
- Plutôt que d'abandonner complètement l'apprentissage par renforcement, nous pouvons employer un mélange d'apprentissage par renforcement et d'autres approches pour résoudre de nombreux problèmes. L'apprentissage par renforcement et le Deep Learning forment une combinaison courante.
Conclusion :
Le défi de l'apprentissage de méthodes de contrôle pour des agents autonomes avec peu ou pas de données est traité par l'apprentissage par renforcement. Comme collecter et étiqueter un large ensemble d'exemples coûte plus cher que les données elles-mêmes, les algorithmes de RL sont utiles en apprentissage automatique. Les décisions sont prises par apprentissage par renforcement. Il devient possible pour un système intelligent d'essayer de nouvelles actions ou approches, de changer de cap en cas d'échec et de s'appuyer sur les réussites en développant une simulation d'une entreprise ou d'un système complet.
- Reinforcement Learning Tutorial. Available from: https://www.javatpoint.com/reinforcement-learning.
- Pros and Cons of Reinforcement Learning. Available from: https://pythonistaplanet.com/pros-and-cons-of-reinforcement-learning/.
La boucle de l'apprentissage par renforcement
- Un agent observe l'état actuel de son environnement.
- Il entreprend une action.
- L'environnement renvoie une récompense (positive ou négative) et un nouvel état.
- L'agent met à jour sa politique pour obtenir plus de récompense au fil du temps.
Exemples concrets
- Jeux : des systèmes qui ont appris à jouer au Go et à des jeux vidéo en jouant contre eux-mêmes.
- Robotique : des robots qui apprennent à marcher ou à saisir des objets.
- Recommandations et publicités : choisir ce qu'il faut afficher pour maximiser l'engagement à long terme.
- Gestion des ressources : refroidissement de centres de données et contrôle des feux de circulation.
- Modèles de langage : affinage avec des retours humains pour produire des réponses plus utiles.
Apprentissage par renforcement, supervisé et non supervisé
L'apprentissage supervisé apprend à partir d'exemples étiquetés (apprentissage supervisé) ; l'apprentissage non supervisé découvre une structure dans des données non étiquetées (apprentissage non supervisé) ; l'apprentissage par renforcement apprend par essais et erreurs à partir de récompenses. Consultez la vue d'ensemble dans qu'est-ce que le machine learning.
Réponses rapides
Qu'est-ce qu'une fonction de récompense ?
Une règle qui évalue la qualité d'une action ou d'un résultat. La concevoir correctement est l'une des parties les plus difficiles de l'apprentissage par renforcement.


