
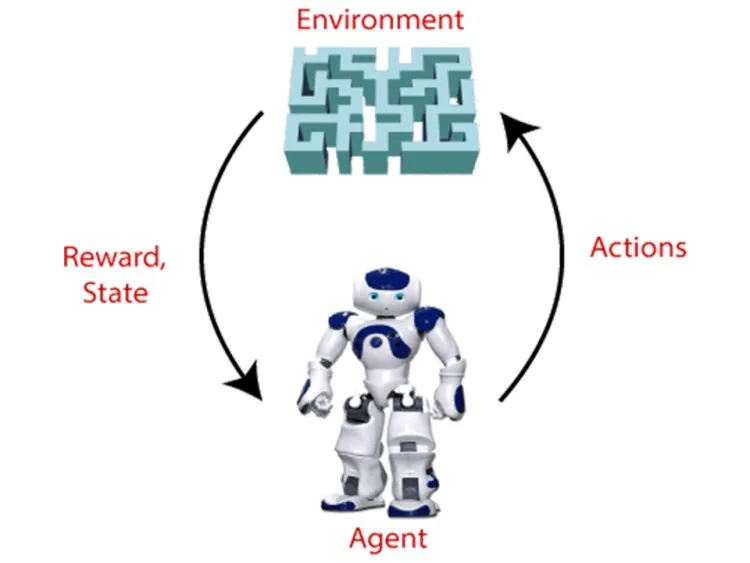
परिचय:
रिइन्फ़ोर्समेंट लर्निंग सुपरवाइज़्ड और अनसुपरवाइज़्ड लर्निंग के बीच आती है। औपचारिक और तकनीकी रूप से यह सुपरवाइज़्ड लर्निंग नहीं है क्योंकि यह केवल लेबल किए गए प्रशिक्षण या अभ्यास डेटा के सेट पर निर्भर नहीं करती, लेकिन यह अनसुपरवाइज़्ड लर्निंग भी नहीं है क्योंकि हम चाहते हैं कि हमारा एजेंट पुरस्कार का लाभ उठाए। अपने मुख्य निर्णय को प्रभावित करने के लिए, एजेंट को अनेक परिदृश्यों में "सही" कार्य और व्यवहार चुनने होते हैं।
रिइन्फ़ोर्समेंट मशीन लर्निंग क्या है?
रिइन्फ़ोर्समेंट लर्निंग मशीन लर्निंग का वह प्रकार है जिसमें मशीनें किसी विशिष्ट परिवेश में अपना पुरस्कार अधिकतम करने के लिए इष्टतम व्यवहार या उपयुक्त कार्रवाई सीखती हैं। इस व्यवहार में, मशीन परिवेश के साथ संपर्क करके और अवलोकन करके सीखती है कि कैसे प्रतिक्रिया देनी है।
रिइन्फ़ोर्समेंट लर्निंग सुपरवाइज़्ड लर्निंग से इस मायने में भिन्न है कि सुपरवाइज़्ड लर्निंग में उत्तर पुस्तिका होती है, जिससे मॉडल को सही उत्तर के साथ प्रशिक्षित किया जाता है, जबकि रिइन्फ़ोर्समेंट लर्निंग में उत्तर नहीं होता और इसके बजाय यह रिइन्फ़ोर्समेंट एजेंट पर निर्भर करती है कि वह कार्य पूरा करने के लिए क्या करना है इसका निष्कर्ष निकाले। प्रशिक्षण डेटासेट की अनुपस्थिति में उसे अपने ज्ञान से खुद को ढालना पड़ता है।
रिइन्फ़ोर्समेंट लर्निंग कैसे काम करती है?
रिइन्फ़ोर्समेंट लर्निंग की समस्या में एक एजेंट किसी लक्ष्य को हासिल करने के निर्देश के तहत एक अपरिचित परिवेश की खोज करता है। रिइन्फ़ोर्समेंट लर्निंग इस विचार पर बनी है कि किसी भी उद्देश्य को अपेक्षित संचयी पुरस्कार को अधिकतम करने के रूप में दर्शाया जा सकता है। पुरस्कार को अधिकतम करने के लिए, एजेंट को अपनी गतिविधियों के माध्यम से परिवेश की स्थिति को समझना और उसे प्रभावित करना सीखना होता है।
RL के संचालन को समझने के लिए हमें दो प्रमुख कारकों की जाँच करनी होगी:
परिवेश: यह कोई कमरा, भूलभुलैया, फ़ुटबॉल मैदान या कुछ और भी हो सकता है।
एजेंट: AI रोबोट जैसे किसी बुद्धिमान एजेंट को एजेंट कहा जाता है।
उदाहरण के लिए, एक भूलभुलैया परिवेश लें जिसे एजेंट को पार करना है। निम्नलिखित चित्रण पर विचार करें:
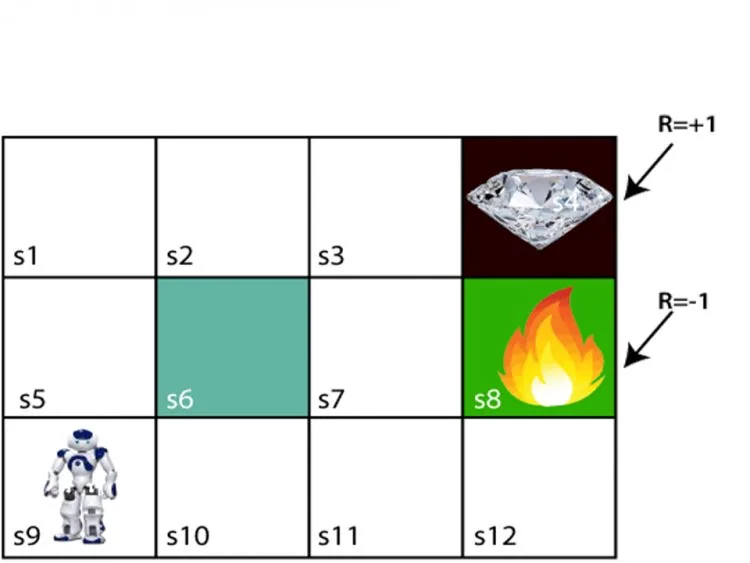
ऊपर की छवि में एजेंट भूलभुलैया के पहले ब्लॉक पर है। भूलभुलैया में एक S6 ब्लॉक है जो दीवार है, एक S8 ब्लॉक है जो आग का गड्ढा है, और एक S4 ब्लॉक है जो हीरे का ब्लॉक है।
एजेंट S6 ब्लॉक से नहीं गुज़र सकता क्योंकि वह एक ठोस दीवार है। यदि एजेंट S4 ब्लॉक तक पहुँचता है, तो उसे +1 पुरस्कार मिलेगा, जबकि यदि वह आग के गड्ढे तक पहुँचता है, तो उसे -1 पुरस्कार मिलेगा। वह चार अलग-अलग दिशाओं, यानी ऊपर, नीचे, बाएँ और दाएँ, में जा सकता है।
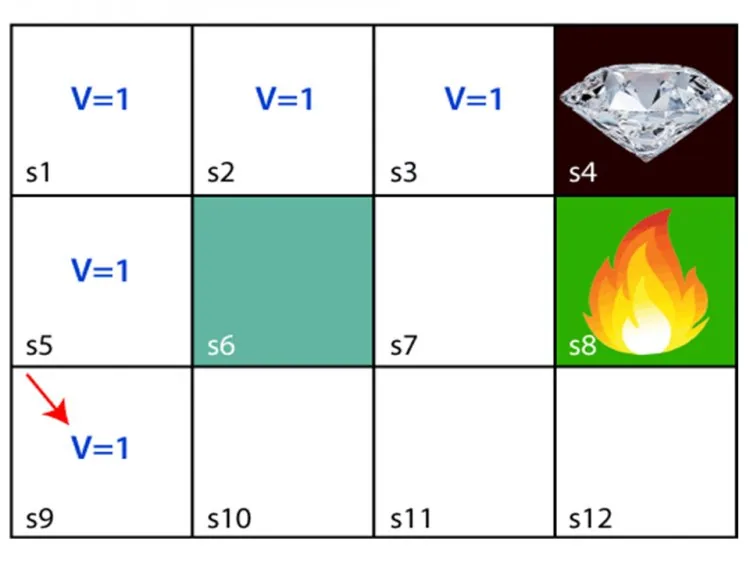
एजेंट अंतिम बिंदु तक पहुँचने के लिए कोई भी रास्ता चुन सकता है, लेकिन उसे यह यथासंभव कम चरणों में करना होगा। यदि एजेंट S9-S5-S1-S2-S3 मार्ग अपनाता है, तो उसे +1 पुरस्कार अंक मिलेगा।
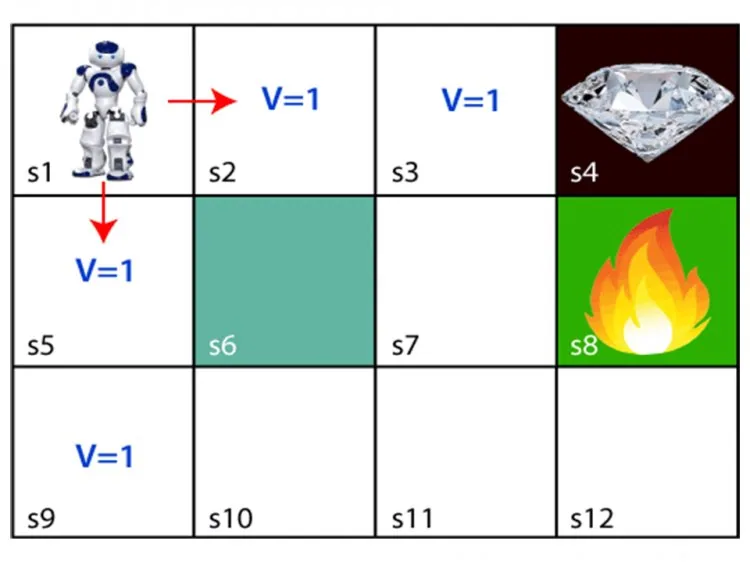
एजेंट उन अवधियों को याद रखने का प्रयास करेगा जो यहाँ तक पहुँचाने की वजह बनीं। इन्हें याद रखने के लिए वह प्रत्येक पिछले चरण को 1 मान देता है।[1]
रिइन्फ़ोर्समेंट लर्निंग के प्रकार क्या हैं?
रिइन्फ़ोर्समेंट लर्निंग के केवल दो प्रकार हैं, जो इस प्रकार हैं:
- सकारात्मक:
जब किसी विशेष व्यवहार के परिणामस्वरूप कोई घटना घटती है, तो रिइन्फ़ोर्समेंट उस व्यवहार की ताकत और आवृत्ति को बढ़ाता है। दूसरे शब्दों में, इसका आचरण पर लाभकारी प्रभाव पड़ता है।
- नकारात्मक:
रिइन्फ़ोर्समेंट तब होता है जब किसी नकारात्मक परिस्थिति से बचने या उसके रुकने के परिणामस्वरूप कोई व्यवहार मज़बूत होता है।
रिइन्फ़ोर्समेंट लर्निंग के उदाहरण क्या हैं?
रोबोटिक्स:
पहले से प्रोग्राम किए गए व्यवहार वाले रोबोट संगठित परिवेशों में, जहाँ कार्य दोहराए जाते हैं, प्रभावी होते हैं, जैसे कार निर्माण फ़ैक्टरी की असेंबली लाइन। वास्तविक दुनिया में सटीक व्यवहारों को पहले से प्रोग्राम करना, जहाँ रोबोट की गतिविधि पर परिवेश की प्रतिक्रिया अज्ञात होती है, लगभग असंभव है। ऐसे मामलों में, RL सामान्य-उद्देश्य वाले रोबोट बनाने की एक तेज़ और आसान तकनीक प्रदान करती है। इसका प्रभावी उपयोग रोबोटिक मार्ग योजना में किया गया है, जहाँ रोबोट को दो बिंदुओं के बीच टकराव-मुक्त, छोटा, सहज और चलने योग्य रास्ता खोजना होता है जो रोबोट की गतिकी के अनुरूप हो।
स्वायत्त ड्राइविंग:
बदलते परिवेश में, स्वायत्त ड्राइविंग सिस्टम को कई अवबोधन और तैयारी संबंधी कार्य पूरे करने होते हैं। वाहन मार्ग की तैयारी और गति का पूर्वानुमान ऐसी दो गतिविधियाँ हैं जहाँ RL का उपयोग किया जा सकता है। विविध समय और भौगोलिक पैमानों पर निर्णय लेने के लिए, वाहन मार्ग योजना में कई निम्न और उच्च-स्तरीय नियमों की आवश्यकता होती है। यह समझने के लिए कि परिवेश की मौजूदा स्थिति के आधार पर स्थिति कैसे विकसित हो सकती है, लोगों और अन्य वाहनों की गति का पूर्वानुमान लगाने की चुनौती को गति पूर्वानुमान कहा जाता है।
रिइन्फ़ोर्समेंट लर्निंग के फ़ायदे क्या हैं?
- रिइन्फ़ोर्समेंट लर्निंग का उपयोग अत्यंत जटिल समस्याओं को संभालने के लिए किया जा सकता है जिन्हें पारंपरिक तरीकों से हल करना असंभव है।
- कठिनाई से हासिल होने वाले दीर्घकालिक परिणामों को पाने के लिए इस दृष्टिकोण को प्राथमिकता दी जाती है।
- यह लर्निंग प्रतिमान मानवीय सीखने से बहुत मिलता-जुलता है। नतीजतन, यह पूर्णता प्राप्त करने की कगार पर है।
- मॉडल में प्रशिक्षण चरण के दौरान हुई गलतियों को सुधारने की क्षमता होती है।
- एक बार जब मॉडल किसी गलती को ठीक कर लेता है, तो दूसरी गलती होने की संभावना बहुत कम होती है।
- इसमें किसी विशिष्ट समस्या को हल करने के लिए आदर्श मॉडल तैयार करने की क्षमता होती है।
- चलना सीखने के लिए रोबोट रिइन्फ़ोर्समेंट लर्निंग एल्गोरिदम का उपयोग कर सकते हैं।
- रिइन्फ़ोर्समेंट लर्निंग का उद्देश्य किसी विशेष स्थिति में मॉडल का इष्टतम व्यवहार हासिल करके उसके प्रदर्शन को अधिकतम करना है।
- जब पर्यावरण के बारे में ज्ञान जुटाने का एकमात्र तरीका उससे संपर्क करना हो, तो यह मूल्यवान हो सकती है।[2]
रिइन्फ़ोर्समेंट लर्निंग के नुकसान क्या हैं?
- एक ढाँचे के रूप में रिइन्फ़ोर्समेंट लर्निंग कई मामलों में अपूर्ण है, फिर भी यही कमी उसे कारगर बनाती है।
- बहुत अधिक रिइन्फ़ोर्समेंट लर्निंग से अवस्थाओं की अधिकता हो सकती है, जिससे उपयोगिता और प्रभावशीलता घटती है।
- प्राथमिक कार्यों के लिए यह सबसे अच्छा विकल्प नहीं है।
- रिइन्फ़ोर्समेंट लर्निंग के लिए बड़ी मात्रा में डेटा और कंप्यूटेशन की आवश्यकता होती है। इसकी आँकड़ों की भूख कभी शांत नहीं होती। इसीलिए यह वीडियो गेम में इतना अच्छा काम करती है, क्योंकि गेम को बार-बार खेला जा सकता है, इसलिए बड़ी मात्रा में डेटा जुटाना संभव प्रतीत होता है।
- रिइन्फ़ोर्समेंट लर्निंग को पूरी तरह छोड़ने के बजाय, हम कई समस्याओं से निपटने के लिए रिइन्फ़ोर्समेंट लर्निंग और अन्य दृष्टिकोणों के मिश्रण का उपयोग कर सकते हैं। रिइन्फ़ोर्समेंट लर्निंग और डीप लर्निंग एक आम जोड़ी है।
निष्कर्ष:
रिइन्फ़ोर्समेंट लर्निंग कम या बिना डेटा के स्वायत्त एजेंटों के लिए नियंत्रण विधियाँ सीखने की कठिनाई को दूर करती है। क्योंकि नमूना पैटर्न के विशाल संग्रह को जुटाने और लेबल करने में खुद डेटा से अधिक खर्च आता है, RL एल्गोरिदम मशीन लर्निंग में उपयोगी हैं। निर्णय रिइन्फ़ोर्समेंट लर्निंग के माध्यम से लिए जाते हैं। यह किसी बौद्धिक प्रणाली के लिए संभव बनाती है कि वह नई गतिविधियाँ या तरीके आज़माए, निराशा होने पर दिशा बदले, और किसी संपूर्ण कंपनी या सिस्टम का सिमुलेशन विकसित करके उपलब्धियों पर आगे बढ़े।
- Reinforcement Learning Tutorial. यहाँ उपलब्ध: https://www.javatpoint.com/reinforcement-learning.
- Pros and Cons of Reinforcement Learning. यहाँ उपलब्ध: https://pythonistaplanet.com/pros-and-cons-of-reinforcement-learning/.
रिइन्फ़ोर्समेंट लर्निंग लूप
- एक एजेंट अपने परिवेश की मौजूदा अवस्था का अवलोकन करता है।
- वह एक एक्शन लेता है।
- परिवेश एक पुरस्कार (सकारात्मक या नकारात्मक) और एक नई अवस्था लौटाता है।
- एजेंट समय के साथ अधिक पुरस्कार पाने के लिए अपनी पॉलिसी को अपडेट करता है।
वास्तविक दुनिया के उदाहरण
- गेम्स: ऐसे सिस्टम जिन्होंने खुद के विरुद्ध खेलकर Go और वीडियो गेम खेलना सीखा।
- रोबोटिक्स: रोबोट जो चलना या वस्तुओं को पकड़ना सीखते हैं।
- सुझाव और विज्ञापन: दीर्घकालिक जुड़ाव को अधिकतम करने के लिए यह चुनना कि क्या दिखाया जाए।
- संसाधन प्रबंधन: डेटा-सेंटर कूलिंग और ट्रैफ़िक सिग्नल नियंत्रण।
- भाषा मॉडल: अधिक उपयोगी उत्तर देने के लिए मानवीय फ़ीडबैक के साथ फ़ाइन-ट्यूनिंग।
रिइन्फ़ोर्समेंट बनाम सुपरवाइज़्ड बनाम अनसुपरवाइज़्ड लर्निंग
सुपरवाइज़्ड लर्निंग लेबल किए गए उदाहरणों से सीखती है (सुपरवाइज़्ड लर्निंग); अनसुपरवाइज़्ड लर्निंग बिना लेबल वाले डेटा में संरचना खोजती है (अनसुपरवाइज़्ड लर्निंग); रिइन्फ़ोर्समेंट लर्निंग पुरस्कारों से प्रयास और त्रुटि के ज़रिए सीखती है। अवलोकन के लिए मशीन लर्निंग क्या है देखें।
त्वरित उत्तर
रिवॉर्ड फ़ंक्शन क्या है?
एक नियम जो यह अंक देता है कि कोई कार्रवाई या परिणाम कितना अच्छा है। इसे अच्छी तरह डिज़ाइन करना रिइन्फ़ोर्समेंट लर्निंग के सबसे कठिन हिस्सों में से एक है।


