
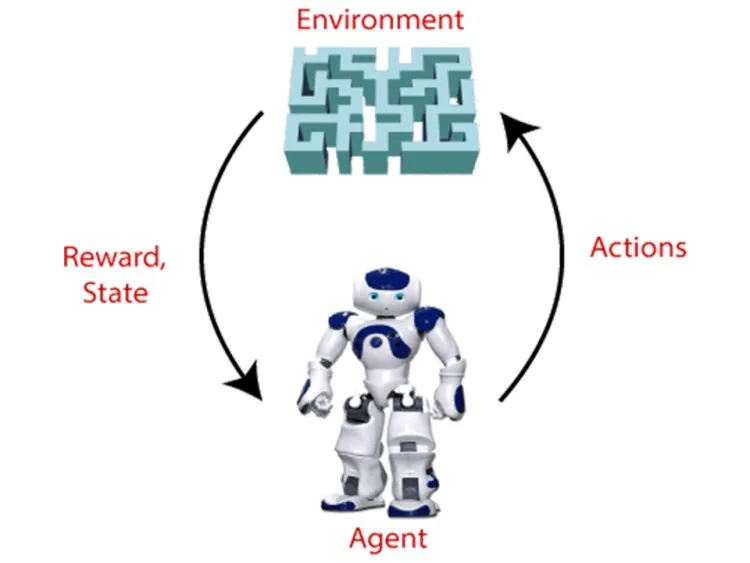
Giriş:
Pekiştirmeli öğrenme, denetimli ve denetimsiz öğrenme arasında yer alır. Yalnızca etiketli bir eğitim veya alıştırma verisi kümesine dayanmadığı için resmî ve teknik olarak denetimli öğrenme değildir; ancak ajanımızın bir ödülden yararlanmasını beklediğimiz için denetimsiz öğrenme de değildir. Ana kararını etkilemek için ajan, çok sayıda senaryoda yapılacak "doğru" performansları ve davranışları seçmelidir.
Pekiştirmeli makine öğrenmesi nedir?
Pekiştirmeli öğrenme, makinelerin ödüllerini en üst düzeye çıkarmak için belirli bir ortamda en uygun davranışı veya uygun eylemi öğrendiği bir makine öğrenmesi türüdür. Bu davranışta makine, ortamla etkileşime girerek ve gözlemleyerek nasıl yanıt vereceğini öğrenir.
Pekiştirmeli öğrenme, denetimli öğrenmeden farklıdır; denetimli öğrenme cevap anahtarını içerir ve modelin doğru cevapla eğitilmesine izin verirken, pekiştirmeli öğrenme cevap içermez ve görevi tamamlamak için ne yapılacağına karar vermeyi pekiştirme ajanına bırakır. Bir eğitim veri kümesinin yokluğunda kendi bilgisinden uyum sağlamak zorundadır.
Pekiştirmeli öğrenme nasıl çalışır?
Pekiştirmeli Öğrenme probleminde bir ajan, bir hedefe ulaşmak için bilinmeyen bir ortamı keşfeder. Pekiştirmeli Öğrenme, beklenen kümülatif ödülün maksimize edilmesinin herhangi bir hedefi temsil etmek için kullanılabileceği fikrine dayanır. Ödülü maksimize etmek için ajan, eylemleri aracılığıyla ortamın durumunu algılamayı ve ona müdahale etmeyi öğrenmelidir.
RL'nin işleyişini anlamak için iki ana etkeni incelemeliyiz:
Ortam: Bir oda, bir labirent, bir futbol sahası veya tamamen başka bir şey olabilir.
Ajan: Yapay zeka robotu gibi zeki bir varlığa ajan denir.
Örneğin ajanın geçmesi gereken bir labirent ortamı düşünün. Aşağıdaki örneği ele alın:
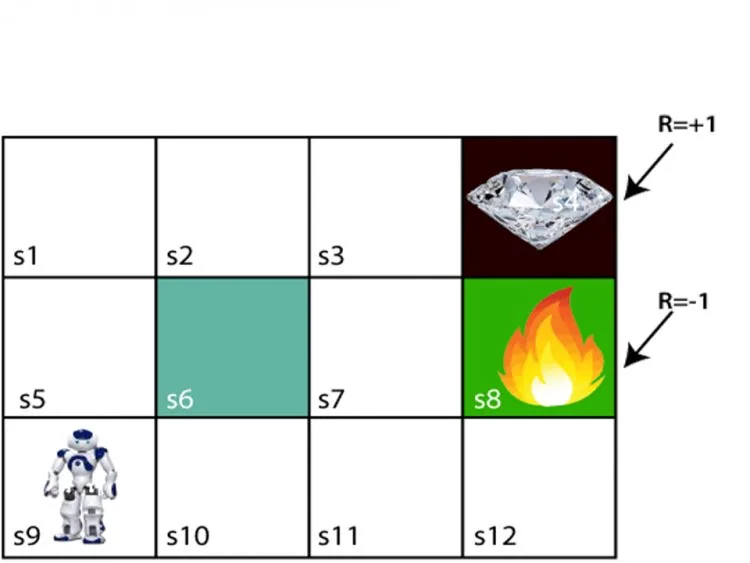
Ajan, yukarıdaki görseldeki labirentte ilk bloktadır. Labirent; duvar olan bir S6 bloğundan, ateş çukuru olan bir S8 bloğundan ve elmas bloğu olan bir S4 bloğundan oluşur.
Ajan, S6 bloğunun sert bir duvar olması nedeniyle ondan geçemez. Ajan S4 bloğuna ulaşırsa +1 ödül alır, ateş çukuruna ulaşırsa -1 ödül alır. Yukarı, aşağı, sola ve sağa olmak üzere dört farklı yönde hareket edebilir.
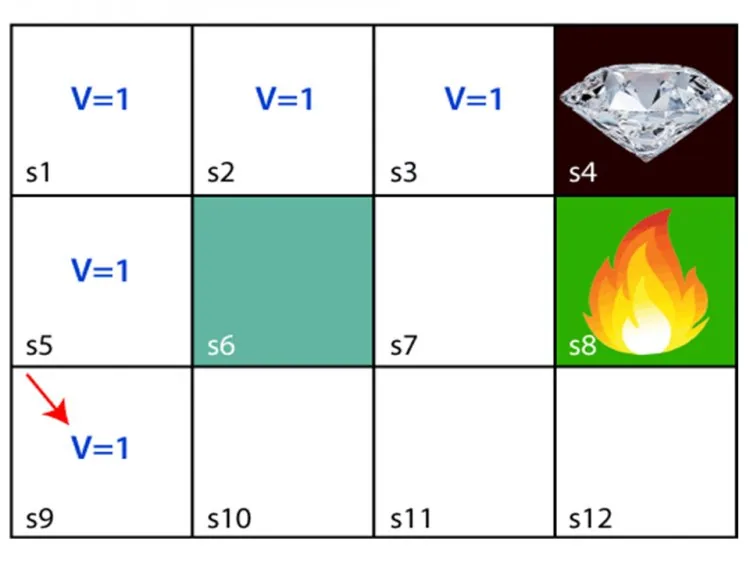
Ajan uç noktaya ulaşmak için herhangi bir yolu seçebilir, ancak bunu mümkün olduğunca az adımda yapmalıdır. Ajan S9-S5-S1-S2-S3 yolunu incelerse +1 ödül puanı alır.
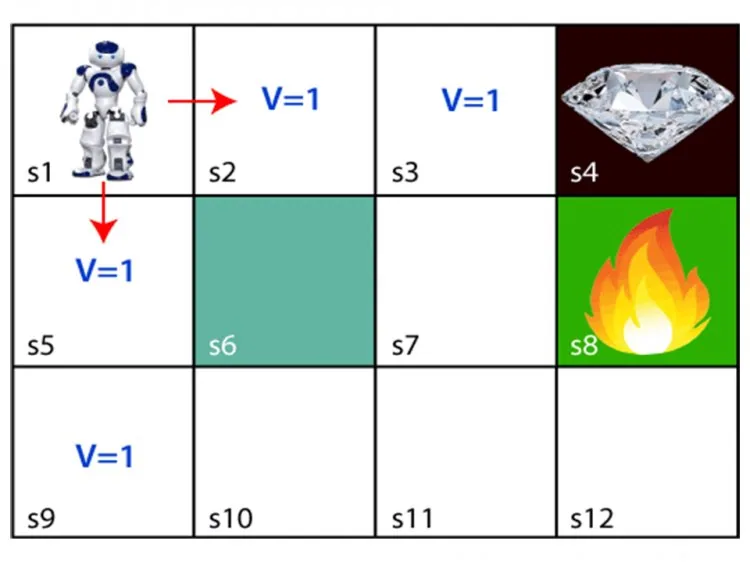
Ajan, bu noktaya kadar getiren aşamaları hatırlamaya çaba gösterecektir. Bunları aklında tutmak için önceki her adıma 1 değeri atar.[1]
Pekiştirmeli öğrenmenin türleri nelerdir?
Pekiştirmeli öğrenmenin yalnızca iki türü vardır:
- Pozitif:
Belirli bir davranışın sonucunda bir olay meydana geldiğinde, pekiştirme o davranışın gücünü ve sıklığını artırır. Başka bir deyişle, davranış üzerinde olumlu bir etkisi vardır.
- Negatif:
Pekiştirme, olumsuz bir durumun önlenmesi veya durdurulması sonucunda bir davranışın güçlendirilmesidir.
Pekiştirmeli öğrenme örnekleri nelerdir?
Robotik:
Önceden programlanmış davranışlara sahip robotlar, otomobil üretim fabrikasındaki bir montaj hattı gibi, tekrarlayan görevlerin olduğu düzenli ortamlarda etkilidir. Ortamın robotun eylemine verdiği yanıtın bilinmediği gerçek dünyada kesin davranışları önceden programlamak neredeyse imkânsızdır. Bu gibi durumlarda RL, genel amaçlı robotlar oluşturmak için hızlı ve kolay bir teknik sunar. İki nokta arasında çarpışmasız ve robotun dinamikleriyle uyumlu kısa, düzgün ve geçilebilir bir yol bulması gereken robotik rota planlamasında etkili biçimde kullanılmıştır.
Otonom Sürüş:
Değişken bir ortamda otonom bir sürüş sistemi, birçok algı ve hazırlık görevini yerine getirmek zorundadır. Araç rotası hazırlama ve hareket tahmini, RL'nin kullanılabileceği faaliyetlere iki örnektir. Araç yol planlaması, çeşitli zaman ve coğrafi ölçeklerde karar vermek için bir dizi alt ve üst düzey kural gerektirir. İnsanların ve diğer araçların hareketini tahmin ederek durumun çevrenin mevcut durumuna bağlı olarak nasıl gelişebileceğini anlama zorluğuna hareket tahmini denir.
Pekiştirmeli öğrenmenin avantajları nelerdir?
- Pekiştirmeli öğrenme, geleneksel yöntemlerle çözülmesi imkânsız olan son derece karmaşık sorunları ele almak için kullanılabilir.
- Bu yaklaşım, ulaşılması zor uzun vadeli sonuçlara erişmek için tercih edilir.
- Bu öğrenme paradigması insan öğrenmesine çok benzer. Sonuç olarak mükemmelliğe ulaşmanın eşiğindedir.
- Model, eğitim aşamasında yapılan hataları düzeltme yeteneğine sahiptir.
- Bir model bir hatayı düzelttikten sonra başka bir hatanın oluşma olasılığı oldukça düşüktür.
- Belirli bir sorunu çözmek için ideal modeli tasarlama yeteneğine sahiptir.
- Yürümeyi öğrenmek için robotlar pekiştirmeli öğrenme algoritmalarını kullanabilir.
- Pekiştirmeli öğrenme, belirli bir durumda en uygun davranışa ulaşarak bir modelin performansını en üst düzeye çıkarmayı amaçlar.
- Çevre hakkında bilgi toplamanın tek yolu onunla etkileşime girmek olduğunda değerli olabilir.[2]
Pekiştirmeli öğrenmenin dezavantajları nelerdir?
- Bir çerçeve olarak pekiştirmeli öğrenme birçok açıdan kusurludur, ancak onu işlevsel kılan tam da bu kusurdur.
- Çok fazla pekiştirmeli öğrenme, aşırı sayıda durumla sonuçlanarak kullanışlılığı ve etkinliği düşürebilir.
- Temel görevler için en iyi seçenek değildir.
- Pekiştirmeli öğrenme büyük miktarda veri ve hesaplama gerektirir. İstatistiğe doymak bilmez bir iştahı vardır. Bu yüzden video oyunlarında bu kadar iyi çalışır; çünkü oyun tekrar tekrar oynanabildiği için büyük miktarda veri elde etmek ulaşılabilir görünür.
- Pekiştirmeli öğrenmeyi tamamen terk etmek yerine, birçok sorunu çözmek için pekiştirmeli öğrenmeyi ek yaklaşımlarla birleştirebiliriz. Pekiştirmeli öğrenme ve Derin Öğrenme yaygın bir kombinasyondur.
Sonuç:
Pekiştirmeli Öğrenme, az veriyle veya hiç veri olmadan otonom ajanlar için kontrol yöntemlerini öğrenme zorluğunu ele alır. Geniş bir örnek örüntü koleksiyonunu toplamak ve etiketlemek verinin kendisinden daha pahalıya mal olduğu için RL algoritmaları makine öğrenmesinde işe yarar. Kararlar pekiştirmeli öğrenmeyle alınır. Zeki bir sistemin yeni girişimleri veya yaklaşımları denemesini, başarısızlıklar yaşandığında yön değiştirmesini ve tüm bir şirketin veya sistemin simülasyonunu geliştirerek başarıların üzerine inşa etmesini mümkün kılar.
- Reinforcement Learning Tutorial. Kaynak: https://www.javatpoint.com/reinforcement-learning.
- Pros and Cons of Reinforcement Learning. Kaynak: https://pythonistaplanet.com/pros-and-cons-of-reinforcement-learning/.
Pekiştirmeli öğrenme döngüsü
- Bir ajan, ortamının mevcut durumunu gözlemler.
- Bir eylem gerçekleştirir.
- Ortam bir ödül (pozitif veya negatif) ve yeni bir durum döndürür.
- Ajan, zamanla daha fazla ödül kazanmak için politikasını günceller.
Gerçek dünya örnekleri
- Oyunlar: kendi kendilerine karşı oynayarak Go ve video oyunlarını oynamayı öğrenen sistemler.
- Robotik: yürümeyi veya nesneleri kavramayı öğrenen robotlar.
- Öneriler ve reklamlar: uzun vadeli etkileşimi en üst düzeye çıkarmak için neyin gösterileceğine karar verme.
- Kaynak yönetimi: veri merkezi soğutma ve trafik sinyali kontrolü.
- Dil modelleri: daha yararlı yanıtlar üretmek için insan geri bildirimiyle ince ayar yapma.
Pekiştirmeli, denetimli ve denetimsiz öğrenme karşılaştırması
Denetimli öğrenme etiketli örneklerden öğrenir (denetimli öğrenme); denetimsiz öğrenme etiketsiz verilerde yapı bulur (denetimsiz öğrenme); pekiştirmeli öğrenme ise ödüllerden deneme yanılma yoluyla öğrenir. Genel bakış için makine öğrenmesi nedir yazısına bakın.
Kısa yanıtlar
Ödül fonksiyonu nedir?
Bir eylemin veya sonucun ne kadar iyi olduğunu puanlayan bir kural. Bunu iyi tasarlamak, pekiştirmeli öğrenmenin en zor kısımlarından biridir.


