
Introducción:
El aprendizaje por refuerzo se sitúa entre el aprendizaje supervisado y el no supervisado. Formal y técnicamente no es aprendizaje supervisado porque no depende únicamente de un conjunto de datos de entrenamiento etiquetados, pero tampoco es aprendizaje no supervisado porque buscamos que nuestro agente maximice una recompensa. Para influir en su determinación principal, el agente debe elegir las acciones y comportamientos «correctos» que ejecutar en numerosos escenarios.
¿Qué es el aprendizaje automático por refuerzo?
El aprendizaje por refuerzo es el tipo de aprendizaje automático en el que las máquinas aprenden el comportamiento óptimo o la acción adecuada en un entorno específico para maximizar su recompensa. En este comportamiento, la máquina aprende de la interacción con el entorno y de la observación de cómo responder.
El aprendizaje por refuerzo se diferencia del aprendizaje supervisado en que este último incluye la hoja de respuestas, lo que permite entrenar al modelo con la respuesta correcta, mientras que el aprendizaje por refuerzo no contiene una respuesta y, en su lugar, depende del agente de refuerzo para decidir qué hacer para completar la tarea. Está obligado a adaptarse a partir de su conocimiento en ausencia de un conjunto de datos de entrenamiento.
¿Cómo funciona el aprendizaje por refuerzo?
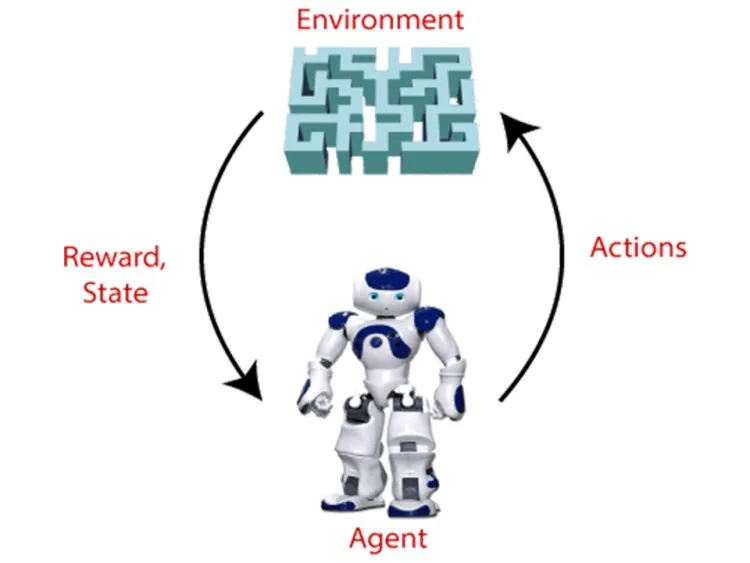
En un problema de aprendizaje por refuerzo, un agente explora un entorno desconocido para alcanzar un objetivo. El aprendizaje por refuerzo se basa en la idea de que la maximización de la recompensa acumulada esperada puede usarse para representar cualquier objetivo. Para maximizar la recompensa, el agente debe aprender a percibir y alterar el estado del entorno mediante sus acciones.
Para comprender el funcionamiento del RL, debemos examinar dos factores principales:
Entorno: puede ser una habitación, un laberinto, un campo de fútbol o algo totalmente distinto.
Agente: un agente inteligente, como un robot de IA, se denomina agente.
Tomemos como ejemplo un entorno de laberinto que el agente debe recorrer. Considere la siguiente ilustración:
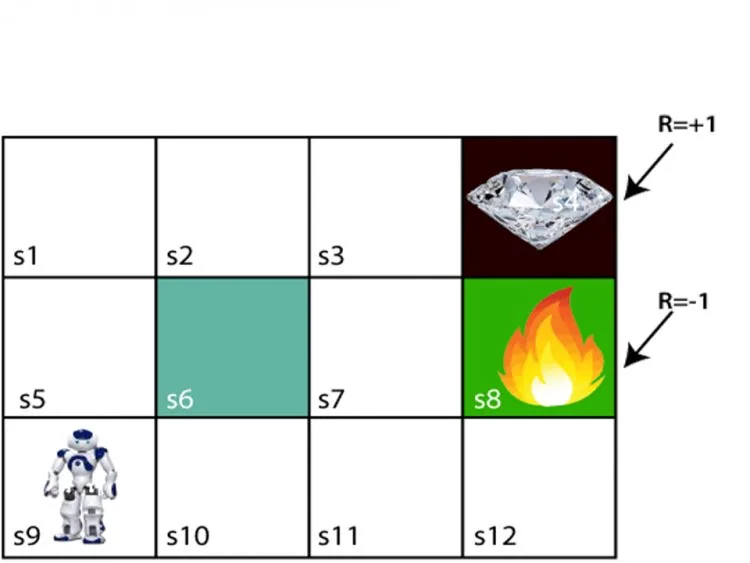
El agente se encuentra en el primer bloque del laberinto de la imagen anterior. El laberinto se compone de un bloque S6, que es un muro, un bloque S8, que es un foso de fuego, y un bloque S4, que es un bloque de diamante.
El agente no puede atravesar el bloque S6 porque es un muro sólido. Si el agente llega al bloque S4, recibirá una recompensa de +1, mientras que si llega al foso de fuego, recibirá una recompensa de -1. Puede moverse en cuatro direcciones: arriba, abajo, izquierda y derecha.
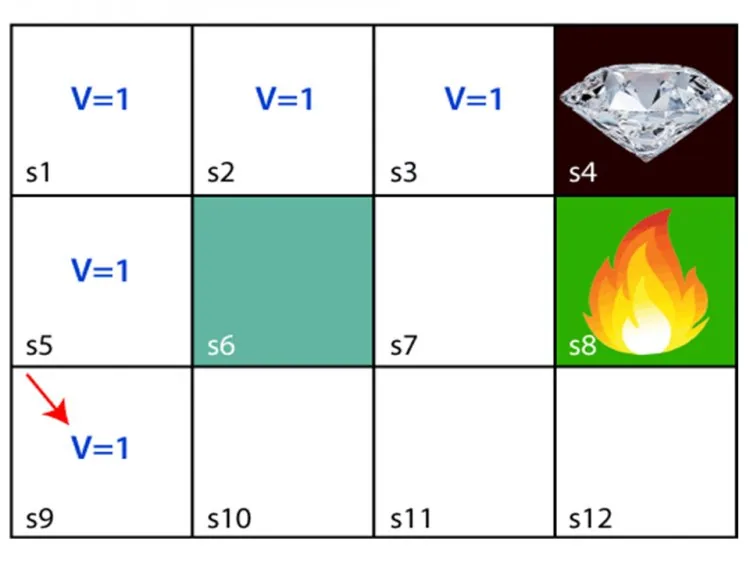
El agente puede elegir cualquier camino para llegar al punto final, pero debe hacerlo en el menor número posible de pasos. Si el agente recorre el camino S9-S5-S1-S2-S3, recibirá el punto de recompensa +1.
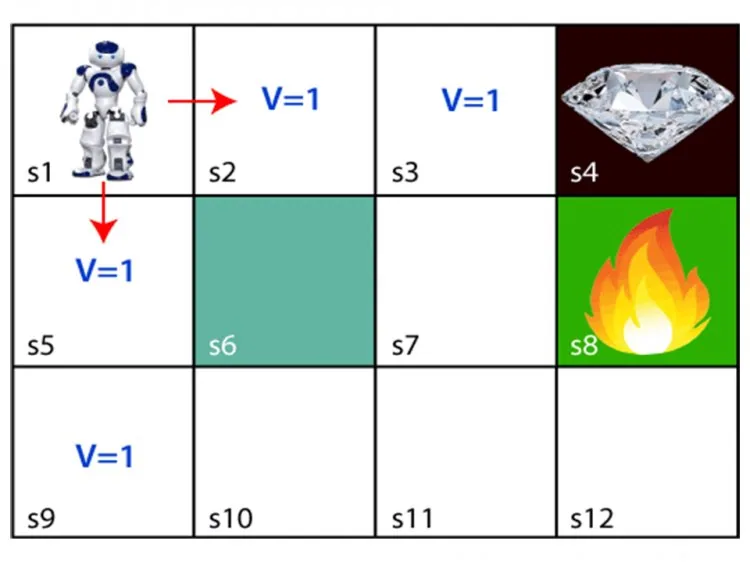
El agente se esforzará por recordar los pasos que han conducido hasta este punto. Asigna un valor de 1 a cada paso anterior para memorizarlos.[1]
¿Cuáles son los tipos de aprendizaje por refuerzo?
Solo existen dos tipos de aprendizaje por refuerzo, que son los siguientes:
- Positivo:
Cuando ocurre un suceso como resultado de un comportamiento concreto, el refuerzo aumenta la fuerza y la frecuencia de ese comportamiento. Dicho de otro modo, tiene una influencia beneficiosa en la conducta.
- Negativo:
El refuerzo ocurre cuando un comportamiento se fortalece como resultado de evitar o detener una circunstancia negativa.
¿Cuáles son los ejemplos de aprendizaje por refuerzo?
Robótica:
Los robots con comportamientos preprogramados son eficaces en entornos organizados con tareas repetitivas, como una línea de montaje en una fábrica de automóviles. Preprogramar comportamientos precisos en el mundo real, donde se desconoce la respuesta del entorno a la acción del robot, es casi imposible. En tales casos, el RL ofrece una técnica rápida y sencilla para crear robots de propósito general. Se ha utilizado con éxito en la planificación de rutas robóticas, donde un robot debe descubrir un camino corto, suave y transitable entre dos puntos, libre de colisiones y coherente con la dinámica del robot.
Conducción autónoma:
En un entorno cambiante, un sistema de conducción autónoma debe realizar muchas tareas de percepción y planificación. La planificación de la ruta del vehículo y la predicción del movimiento son dos ejemplos de actividades en las que se puede usar RL. Para tomar decisiones a diversas escalas temporales y geográficas, la planificación de la trayectoria del vehículo requiere una serie de reglas de bajo y alto nivel. El desafío de pronosticar el movimiento de las personas y de otros vehículos para comprender cómo puede evolucionar la situación según el estado actual del entorno se conoce como predicción del movimiento.
¿Cuáles son las ventajas del aprendizaje por refuerzo?
- El aprendizaje por refuerzo puede utilizarse para abordar problemas extremadamente complejos que son imposibles de resolver con métodos tradicionales.
- Este enfoque se prefiere para lograr resultados difíciles de alcanzar a largo plazo.
- Este paradigma de aprendizaje es muy parecido al aprendizaje humano. En consecuencia, está a punto de alcanzar la perfección.
- El modelo tiene la capacidad de corregir los errores cometidos durante la fase de entrenamiento.
- Una vez que un modelo ha corregido un error, la probabilidad de que ocurra otro error es muy baja.
- Tiene la capacidad de diseñar el modelo ideal para resolver un problema específico.
- Para aprender a caminar, los robots pueden usar algoritmos de aprendizaje por refuerzo.
- El aprendizaje por refuerzo busca maximizar el rendimiento de un modelo logrando su comportamiento óptimo en una situación determinada.
- Cuando la única forma de obtener conocimiento sobre el entorno es interactuar con él, puede resultar valioso.[2]
¿Cuáles son las desventajas del aprendizaje por refuerzo?
- El aprendizaje por refuerzo como marco es incorrecto en muchos aspectos, pero precisamente ese defecto es lo que lo hace eficaz.
- Un exceso de aprendizaje por refuerzo puede dar lugar a una sobreabundancia de estados, lo que reduce la utilidad y la eficacia.
- Para tareas elementales, no es la mejor opción.
- El aprendizaje por refuerzo requiere una gran cantidad de datos y de cómputo. Tiene un apetito insaciable de datos. Por eso funciona tan bien en los videojuegos: como la partida se puede repetir, parece factible obtener enormes cantidades de datos.
- En lugar de abandonar por completo el aprendizaje por refuerzo, podemos emplear una combinación de aprendizaje por refuerzo y otros enfoques para abordar muchos problemas. El aprendizaje por refuerzo y el aprendizaje profundo son una combinación habitual.
Conclusión:
El aprendizaje por refuerzo aborda la dificultad de aprender métodos de control para agentes autónomos con pocos datos o ninguno. Como recopilar y etiquetar una amplia colección de patrones de muestra cuesta más que los propios datos, los algoritmos de RL resultan útiles en el aprendizaje automático. Las decisiones se toman mediante aprendizaje por refuerzo. Hace viable que un sistema inteligente pruebe nuevas acciones o enfoques, cambie de rumbo cuando se producen fracasos y aproveche los logros mediante el desarrollo de una simulación de una empresa o de un sistema completo.
- Reinforcement Learning Tutorial. Disponible en: https://www.javatpoint.com/reinforcement-learning.
- Pros and Cons of Reinforcement Learning. Disponible en: https://pythonistaplanet.com/pros-and-cons-of-reinforcement-learning/.
El ciclo del aprendizaje por refuerzo
- Un agente observa el estado actual de su entorno.
- Realiza una acción.
- El entorno devuelve una recompensa (positiva o negativa) y un nuevo estado.
- El agente actualiza su política para obtener más recompensa con el tiempo.
Ejemplos del mundo real
- Juegos: sistemas que aprendieron a jugar al Go y a videojuegos jugando contra sí mismos.
- Robótica: robots que aprenden a caminar o a agarrar objetos.
- Recomendaciones y anuncios: elegir qué mostrar para maximizar la interacción a largo plazo.
- Gestión de recursos: refrigeración de centros de datos y control de semáforos.
- Modelos de lenguaje: ajuste fino con retroalimentación humana para producir respuestas más útiles.
Aprendizaje por refuerzo frente a aprendizaje supervisado y no supervisado
El aprendizaje supervisado aprende a partir de ejemplos etiquetados (aprendizaje supervisado); el aprendizaje no supervisado encuentra estructura en datos sin etiquetar (aprendizaje no supervisado); el aprendizaje por refuerzo aprende por ensayo y error a partir de recompensas. Consulte la visión general en qué es el aprendizaje automático.
Respuestas rápidas
¿Qué es una función de recompensa?
Una regla que puntúa lo buena que es una acción o un resultado. Diseñarla bien es una de las partes más difíciles del aprendizaje por refuerzo.


