
引言:
强化学习介于监督学习和无监督学习之间。从正式和技术角度来看,它不属于监督学习,因为它并不仅仅依赖一组带标签的训练或练习数据;但它也不属于无监督学习,因为我们希望智能体能够最大化奖励。为了影响其主要决策,智能体必须在众多场景中选择要执行的“正确”表现和行为。
什么是强化机器学习?
强化学习是一种机器学习类型,机器在特定环境中学习最优行为或合适的动作,以最大化其奖励。在这种行为中,机器通过与环境交互并观察来学习如何做出响应。
强化学习与监督学习的不同之处在于,监督学习包含答案表,使模型能够用正确答案进行训练,而强化学习则不包含答案,而是依靠强化智能体来决定如何完成任务。在没有训练数据集的情况下,它必须根据自己的知识进行调整。
强化学习是如何工作的?
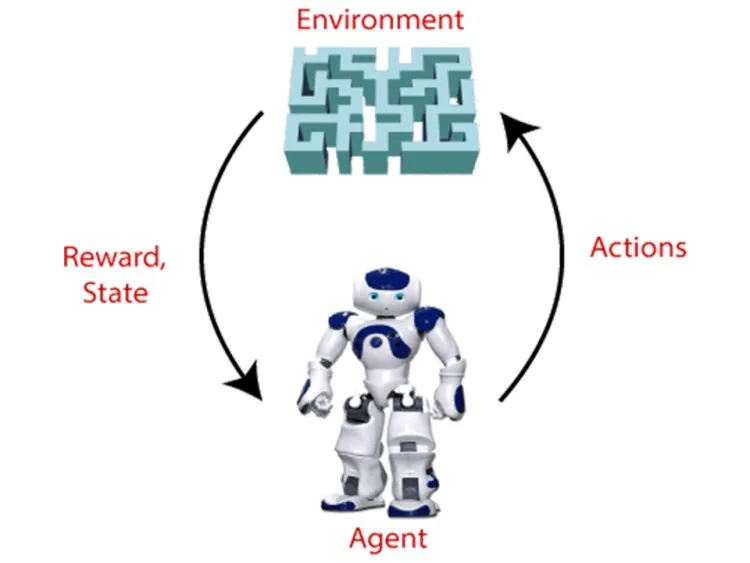
在强化学习问题中,智能体为了实现目标而探索一个陌生的环境。强化学习建立在这样的理念之上:任何目标都可以用预期累积奖励的最大化来表示。为了最大化奖励,智能体必须学会通过其行动来感知并影响环境的状态。
要理解 RL 的运作方式,我们必须研究两个主要因素:
环境:它可以是一个房间、一个迷宫、一个足球场,或者完全是别的东西。
智能体:智能代理,例如 AI 机器人,被称为智能体。
例如,一个智能体必须穿越的迷宫环境。请看下面的示意图:
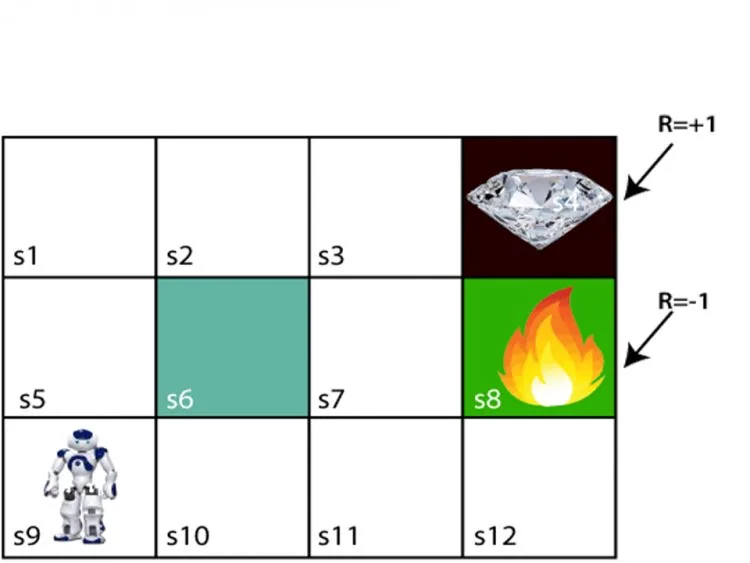
在上图中,智能体位于迷宫中的第一个方块上。迷宫由 S6 方块(一堵墙)、S8 方块(一个火坑)和 S4 方块(一个钻石方块)组成。
智能体无法穿过 S6 方块,因为它是一堵坚硬的墙。如果智能体到达 S4 方块,将获得 +1 的奖励,而如果到达火坑,则会获得 -1 的奖励。它可以向上、向下、向左和向右四个不同方向移动。
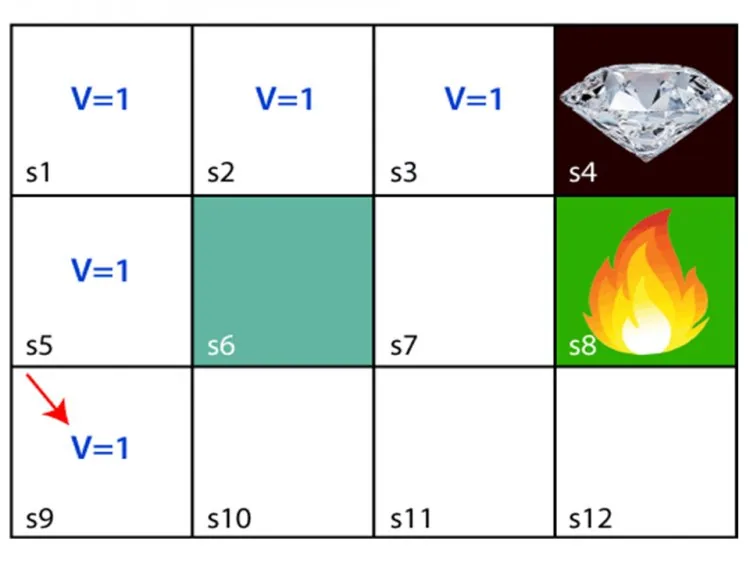
智能体可以选择任何路径到达终点,但必须以尽可能少的步数完成。如果智能体走 S9-S5-S1-S2-S3 这条路径,就会获得 +1 的奖励分。
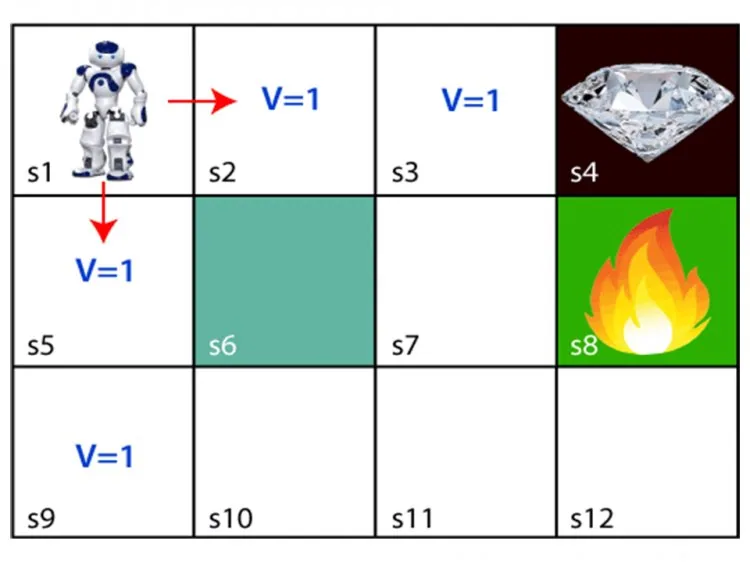
智能体会努力回想导致当前这一步的各个阶段。它为之前的每一步分配 1 的值,以便记住它们。[1]
强化学习有哪些类型?
强化学习只有以下两种类型:
- 正向:
当某种特定行为导致某个事件发生时,强化会增强该行为的强度和频率。换句话说,它对行为具有有益的影响。
- 负向:
强化是指通过避免或停止负面情况而使某种行为得到加强。
强化学习有哪些例子?
机器人技术:
具有预先编程行为的机器人在具有重复任务的有序环境中非常有效,例如汽车制造工厂的装配线。在现实世界中,环境对机器人行动的反应是未知的,因此几乎不可能预先编写精确的行为。在这种情况下,RL 提供了一种快速简便的技术来创建通用机器人。它已被有效地用于机器人路径规划,在这种情况下,机器人必须在两点之间找到一条短、平滑且可通行的路径,该路径没有碰撞且符合机器人的动力学特性。
自动驾驶:
在多变的环境中,自动驾驶系统必须完成许多感知和规划任务。车辆路径规划和运动预测是可以使用 RL 的两个活动示例。为了在不同的时间和空间尺度上做出判断,车辆路径规划需要一系列低层和高层规则。运动预测的挑战在于预测人和其他车辆的移动,以便根据环境的现有状况理解情况可能如何发展。
强化学习有哪些优势?
- 强化学习可用于处理使用传统方法无法解决的极其复杂的问题。
- 这种方法适合用于实现难以达成的长期成果。
- 这种学习范式与人类的学习非常相似。因此,它即将达到完美。
- 该模型有能力纠正在训练阶段所犯的错误。
- 一旦模型纠正了某个错误,再次发生另一个错误的概率就非常低。
- 它有能力设计出解决特定问题的理想模型。
- 为了学会走路,机器人可以使用强化学习算法。
- 强化学习旨在通过在特定情境中实现最优行为,使模型的性能最大化。
- 当了解环境信息的唯一方法是与其交互时,它会很有价值。[2]
强化学习有哪些缺点?
- 强化学习作为一个框架在许多方面并不完美,然而恰恰是这种缺陷使其行之有效。
- 过多的强化学习可能导致状态过多,从而降低其实用性和效率。
- 对于基础任务来说,它并不是最佳选择。
- 强化学习需要大量的数据和计算。它对数据有着永不满足的需求。这就是它在电子游戏中效果如此出色的原因,因为游戏可以反复进行,获取大量数据似乎是可行的。
- 与其完全放弃强化学习,我们可以将强化学习与其他方法相结合来解决许多问题。强化学习与深度学习是常见的组合。
结论:
强化学习解决的是在数据很少或没有数据的情况下为自主智能体学习控制方法的难题。由于收集和标记大量样本模式的成本比数据本身还要高,RL 算法在机器学习中很有用。决策是通过强化学习做出的。它使智能系统能够尝试新的举措或方法、在出现失败时调整方向,并通过构建整个公司或系统的仿真来巩固成果。
- Reinforcement Learning Tutorial。来源:https://www.javatpoint.com/reinforcement-learning。
- Pros and Cons of Reinforcement Learning。来源:https://pythonistaplanet.com/pros-and-cons-of-reinforcement-learning/。
强化学习循环
- 智能体观察其环境的当前状态。
- 它采取一个动作。
- 环境返回一个奖励(正向或负向)和一个新的状态。
- 智能体更新其策略,以便随时间推移获得更多奖励。
现实世界中的示例
- 游戏:通过自我对弈学会下围棋和玩电子游戏的系统。
- 机器人技术:机器人学习行走或抓取物体。
- 推荐和广告:选择展示什么内容以最大化长期参与度。
- 资源管理:数据中心冷却和交通信号控制。
- 语言模型:利用人类反馈进行微调,以生成更有帮助的回答。
强化学习、监督学习与无监督学习的对比
监督学习从带标签的示例中学习(监督学习);无监督学习在未标记的数据中发现结构(无监督学习);强化学习则通过试错并根据奖励来学习。请参阅什么是机器学习中的概述。
快速解答
什么是奖励函数?
一种为某个动作或结果的好坏打分的规则。把它设计好是强化学习中最困难的部分之一。


